ITトレンドと関連用語
下の動画はこの節の解説ではありません。 解説動画の雰囲気を知っていただくための見本として、「AI・機械学習」の動画を再生します。
この節の解説動画はプレミアム限定です。プレミアムなら全科目・全節が見放題!
プレミアムで見る人工知能(AI)とは、人工的にコンピュータ上で人間と同様の知能を実現しようとする試み、またはその技術の総称です。この節では、AIの代表的な研究テーマ(推論・探索、エキスパートシステム、機械学習、深層学習)から始め、機械学習の3分類、ニューラルネットワークの構造、生成AIの用語、そして二値分類問題の評価指標までを学びます。令和3年度から7年度まで毎年出題されている分野です。とくに「機械学習・深層学習・強化学習・エキスパートシステム」の4語を入れ替えた出題が繰り返されているので、1対1で結びつけておきましょう。


簡単にいうと
AIの研究テーマは4つ! 推論・探索、エキスパートシステム、機械学習、深層学習。この4つの入れ替えが令和3年度で出題されたよ。「知識をルールで表現=エキスパートシステム」が判別の鍵。
① 人工知能(AI:Artificial Intelligence)とは
人工知能(AI)とは、人工的にコンピュータ上で人間と同様の知能を実現しようとする試み、またはその技術の総称です。
| 項目 | 内容 |
|---|---|
| 何を目指すか | 人間と同様の知能を実現すること |
| 性格 | 試み、またはその技術の総称 |
民間企業における著名な人工知能には、米IBMの「ワトソン」などがあります。
② 代表的な研究テーマ
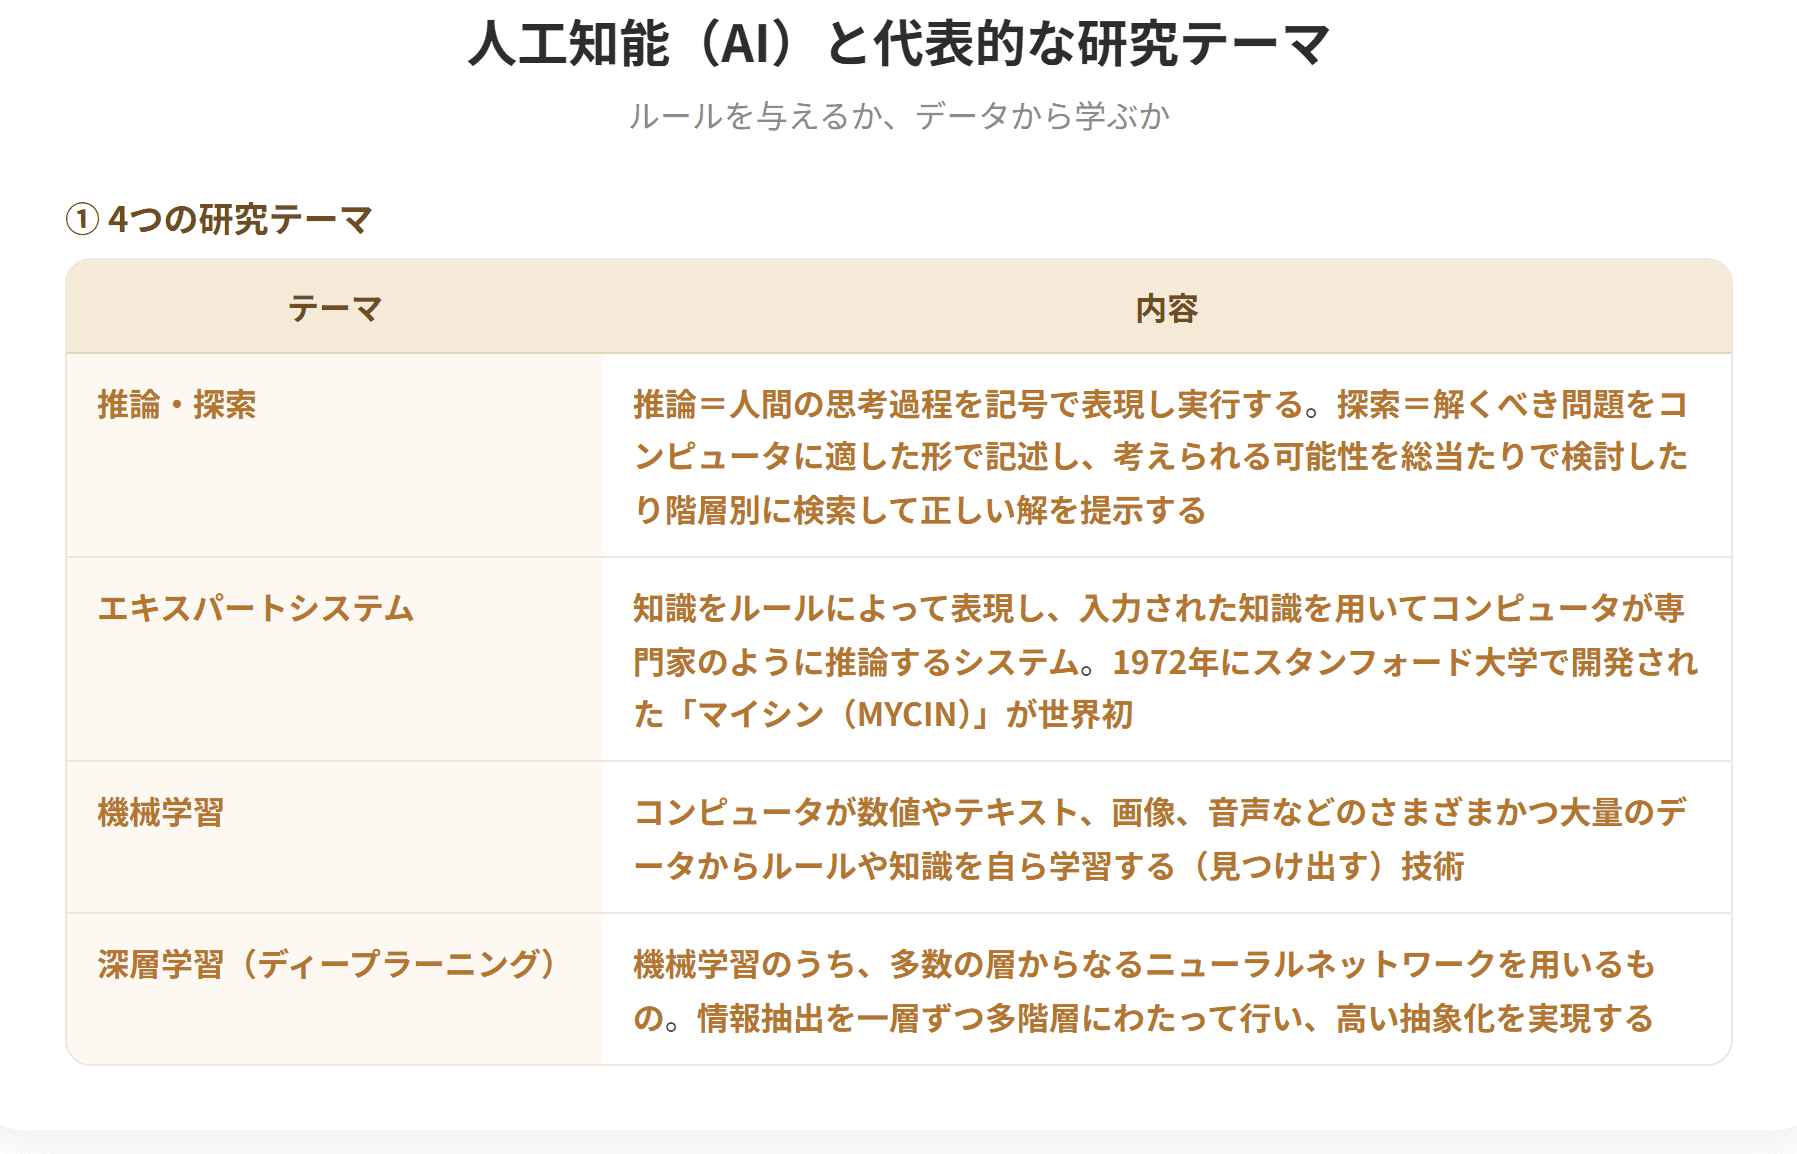
人工知能(AI)の代表的な研究テーマには、次のものなどがあります。
中でも機械学習やディープラーニングといった技術分野が注目されています。
| 研究テーマ |
|---|
| 推論・探索 |
具体例
設例 AIの研究テーマ
> 次の記述の正誤を判定せよ。(令和3年度第13問 改題)
> a 機械学習とは、知識をルールによって表現し、入力された知識を用いてコンピュータが専門家のように推論するシステムである。
> c 強化学習とは、機械学習のうち、多数の層からなるニューラルネットワークを用いるものである。
> d 深層学習とは、一定の環境の中で試行錯誤を行い、個々の行動に対して得点や報酬を与えることによって、ゴールの達成に向けた行動の仕方を獲得する機械学習の学習法の1つである。
解答 a:× c:× d:×
3つの誤りを整理する
| 選択肢 | 書かれている内容 | 本来の用語 |
|---|---|---|
人工知能(AI)と代表的な研究テーマ(1/3)
人工知能(AI)と代表的な研究テーマ(2/3)
人工知能(AI)と代表的な研究テーマ(3/3)

試験のポイント

簡単にいうと
教師あり・教師なし・強化学習の3つ!「正解ラベルが付いているか」で最初の2つが分かれるよ。そして代表的な手法もセットで押さえよう。回帰分析は教師あり、クラスター分析は教師なし。
① 3つの分類
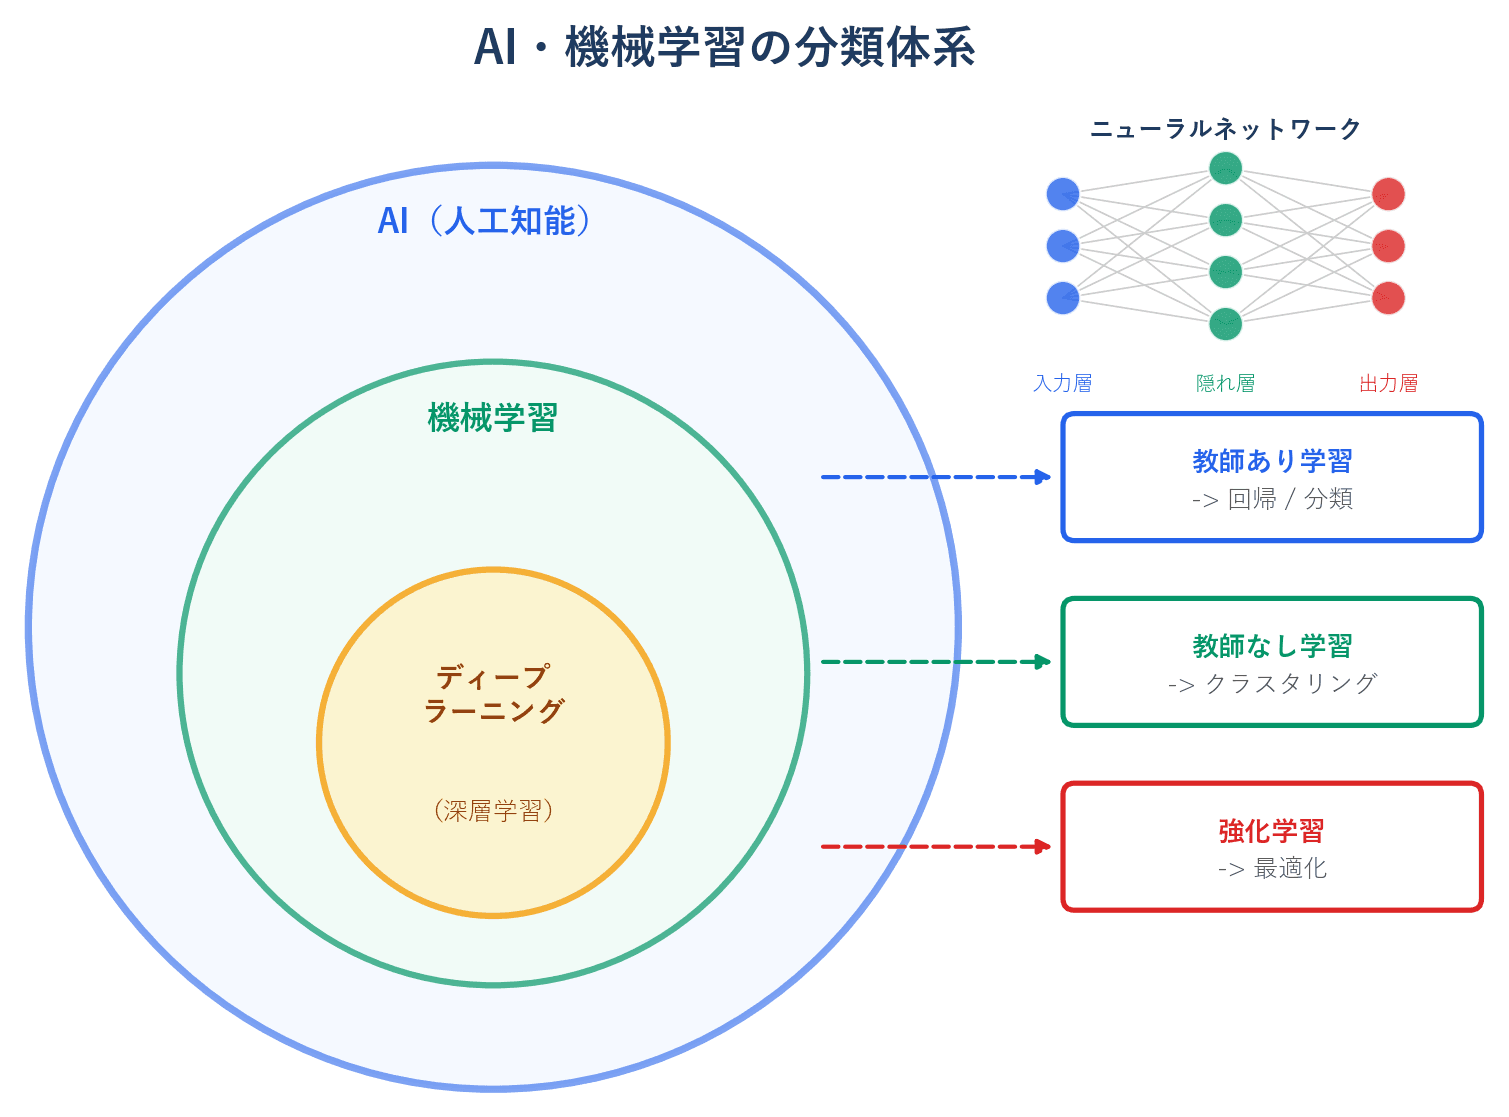
機械学習は大きく3つに分かれます。教師あり学習(supervised learning)、教師なし学習(unsupervised learning)、強化学習(reinforcement learning)です。
| 分類 | 英語 |
|---|---|
| 教師あり学習 | supervised learning |
| 教師なし学習 | unsupervised learning |
簡単にいうと
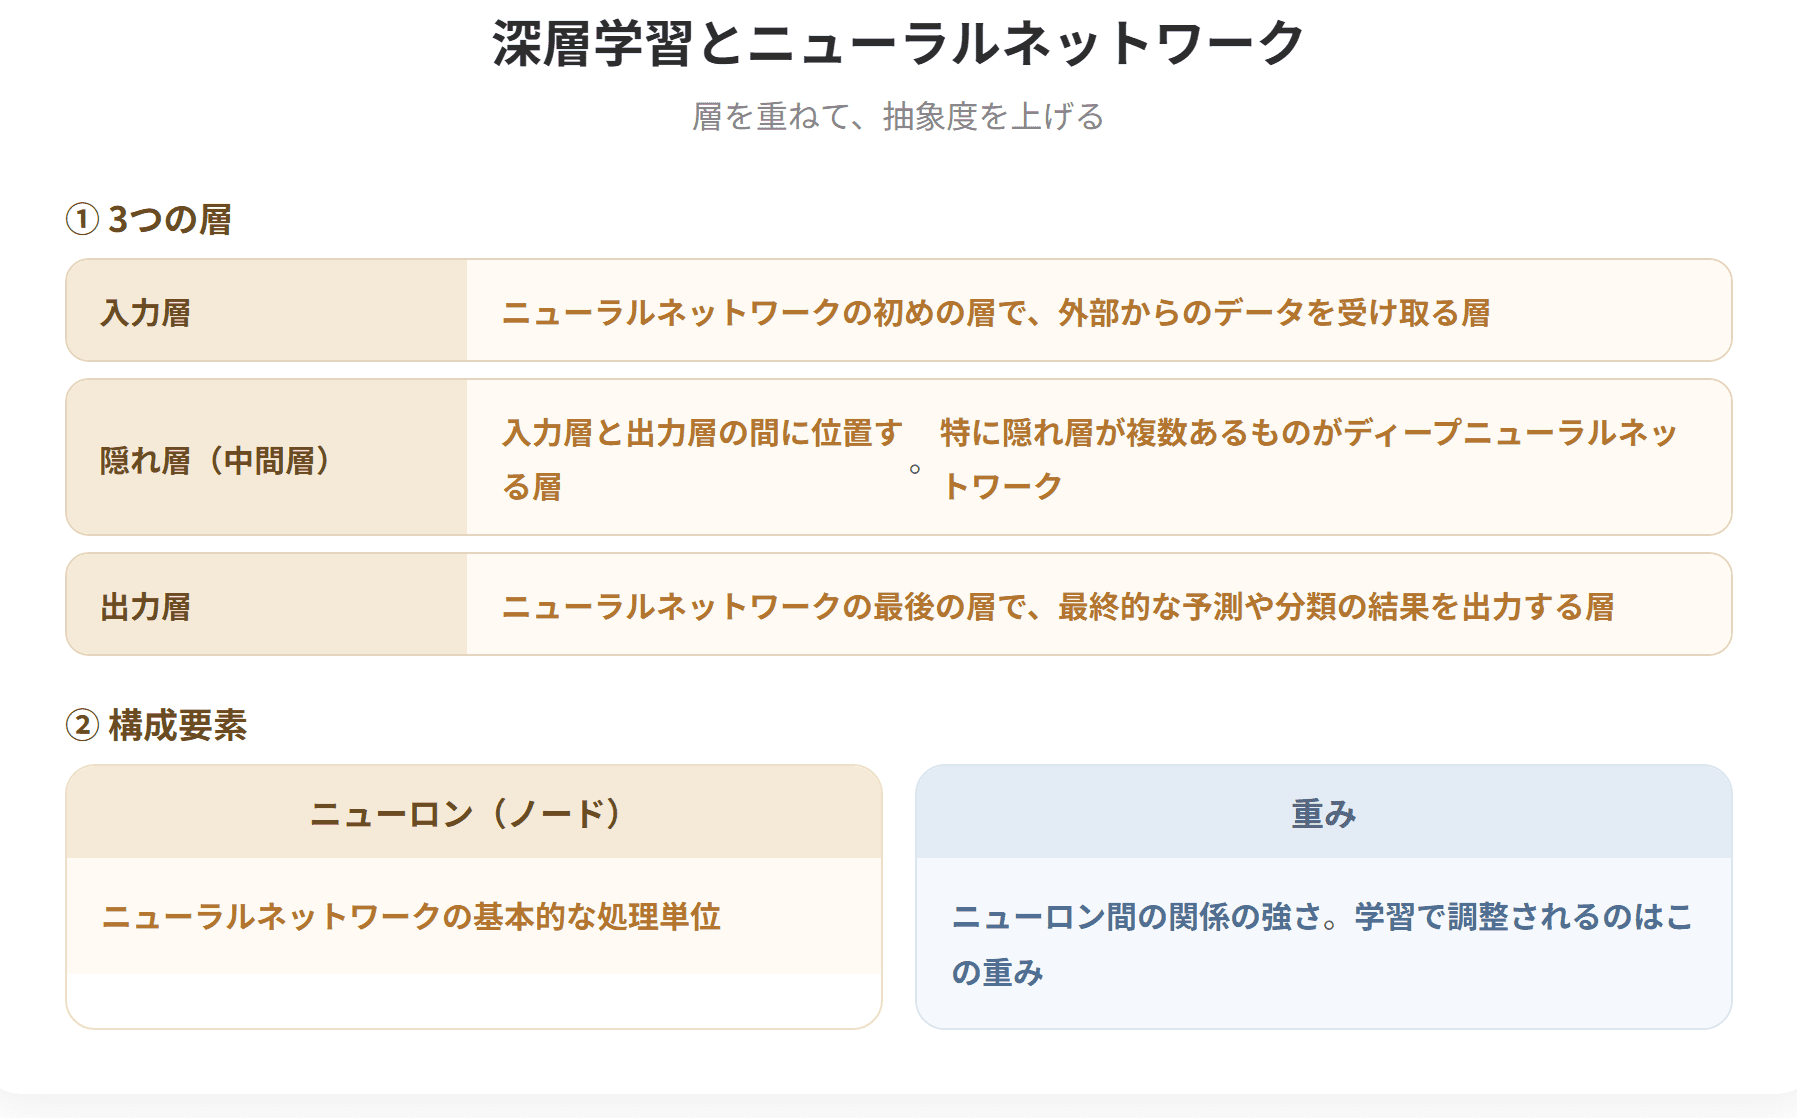
ニューラルネットワークは3層! 入力層・隠れ層(中間層)・出力層。そして隠れ層が複数あるとディープニューラルネットワーク。令和5年度では「活性化関数」と「誤差関数」を入れ替えた出題があったよ。
① 深層学習(ディープラーニング)とは
深層学習は、ディープニューラルネットワークを用いた学習方法のことです。
② ニューラルネットワークの構造
ニューラルネットワークは、入力層、隠れ層(中間層)、出力層の3つの層から構成されます。
| 層 | 内容 |
|---|---|
| 入力層 | いちばん手前。外からのデータを受け取る |
簡単にいうと
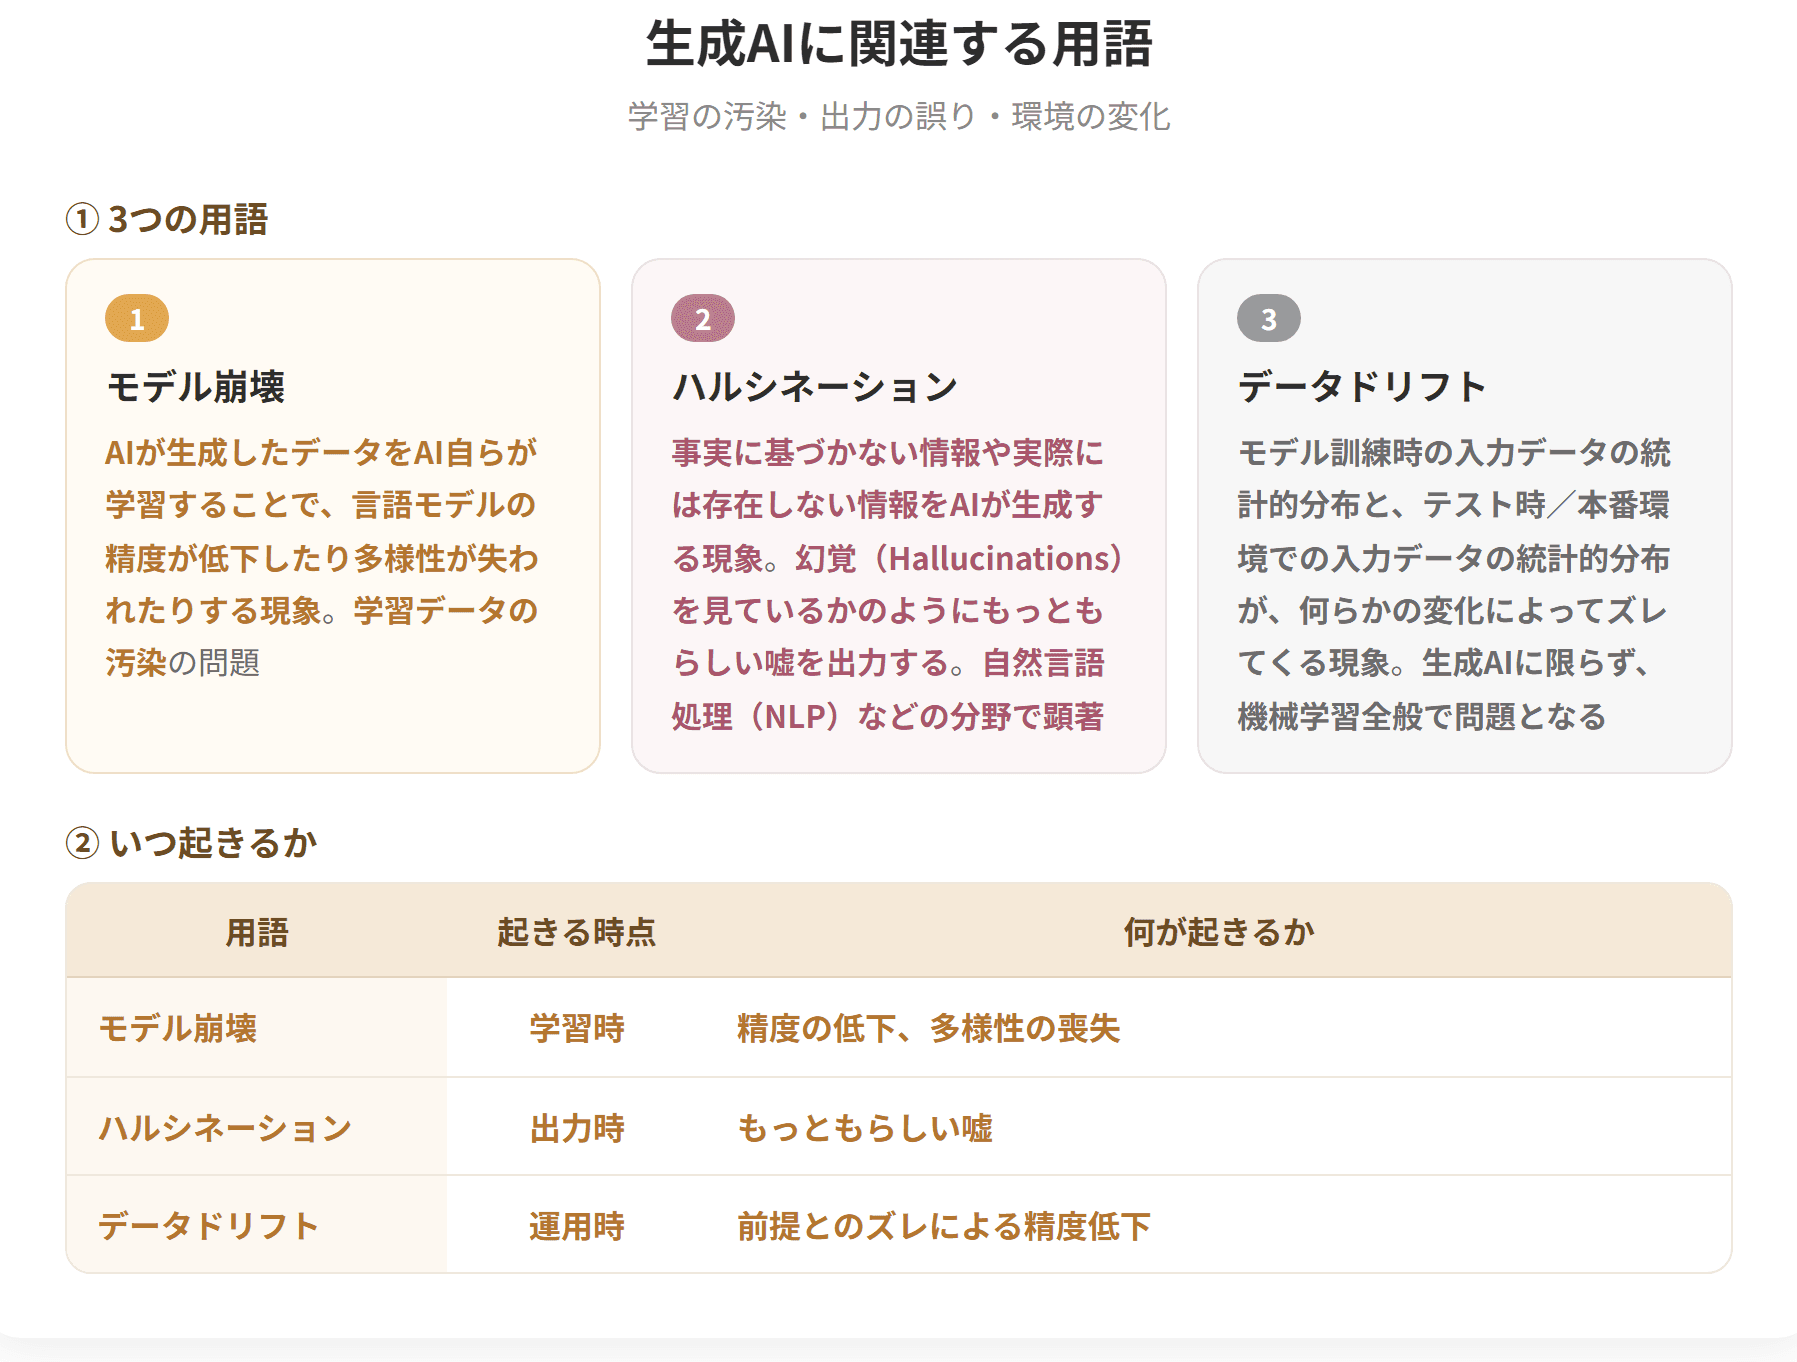
生成AIの用語は3つ! モデル崩壊・ハルシネーション・データドリフト。令和6年度第24問でまとめて出題されたよ。「AIが生成したデータをAI自らが学習」=モデル崩壊、が判別の鍵。
① 生成AIに関連する3つの用語
| 用語 |
|---|
| モデル崩壊 |
| ハルシネーション |
| データドリフト |
② モデル崩壊
AIが生成したデータをAI自らが学習することで、言語モデルの精度が低下したり多様性が失われたりする現象のことです。
簡単にいうと
計算問題で点が取れる分野! 混同行列(TP・FP・FN・TN)から4つの指標を出すよ。正解率・適合率・再現率・F値。「スパムメールなら適合率」「医療診断なら再現率」の対比が大事だよ。
① 二値分類問題の評価指標とは
二値分類問題における性能評価の指標は、モデルの予測精度を測るために用いられます。
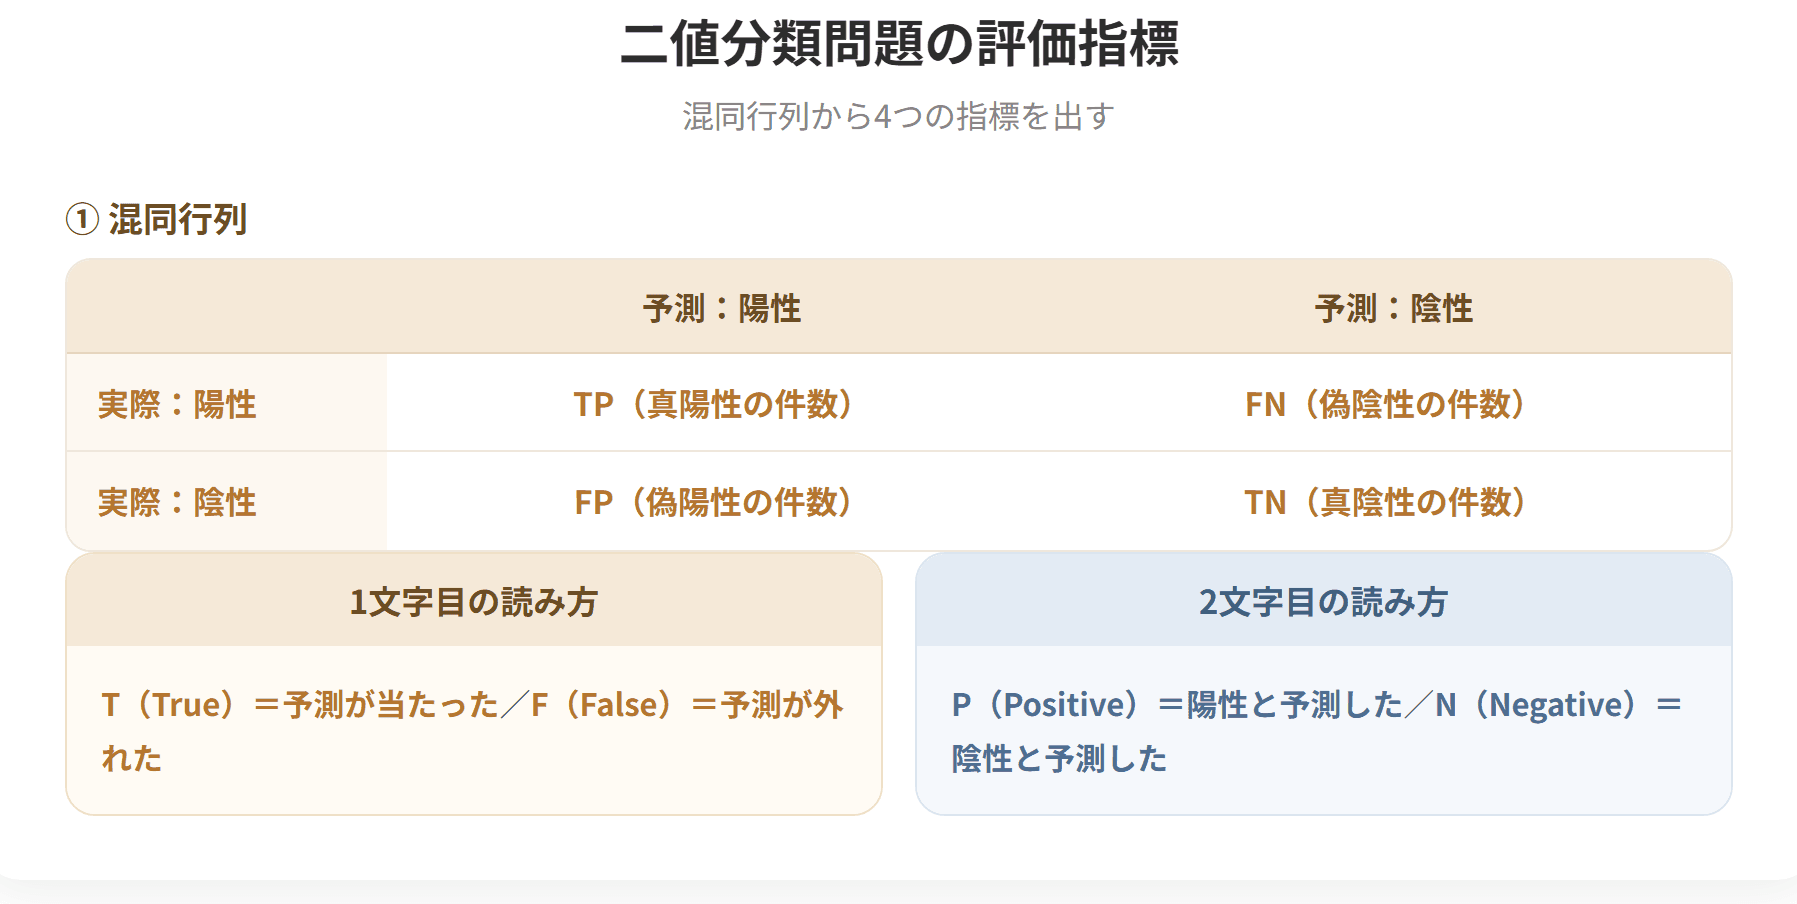
② 混同行列
陽性(Positive)と陰性(Negative)のどちらかに分類する二値分類タスクに対する性能評価を行う際に、混同行列とよばれる分割表が用いられます。
| 予測:陽性 | 予測:陰性 | ||
|---|---|---|---|
| 実際 |

動画・テキスト・過去問・AI添削まですべて網羅!
予備校代の1/10以下で、独学の不安をまるごと解決できます

 全7科目536節の解説動画539本・合計約41時間が見放題。連続再生・ブックマーク再生で、移動中も1本5分前後で進められます。プレミアム限定
 令和3〜7年度の1次過去問1,116問を、科目別・年度別に無制限で演習。問題の図・表と解説つきで、間違えた問題はマイページに残ります。プレミアム限定
 2次は事例I〜IVの114設問に何度でも書いて出せます。AIが設問ごとの基準で採点し、改善点は「どう書き直すか」の例と模範解答つき。プレミアム限定
 科目別のテキストPDFをダウンロードできます。印刷して書き込む、タブレットで持ち歩くなど、好きな使い方で。プレミアム限定
| エキスパートシステム |
| 機械学習 |
| 深層学習(ディープラーニング) |
③ 推論・探索
| 用語 | 内容 |
|---|---|
| 推論 | 人間の思考過程を記号で表現し実行するもの |
| 探索 | 解くべき問題をコンピュータに適した形で記述し、考えられる可能性を総当たりで検討したり、階層別に検索することで正しい解を提示する |
探索の例
たとえば、迷路を解くためには、迷路の道筋をツリー型の分岐として再構成した上でゴールにたどり着く分岐を順番に探し、ゴールに至る道を特定します。
探索の手法は、ロボットなどの行動計画を、前提条件・行動・結果の3要素によって記述する「プランニング」にも用いることができます。
| 用語 | 3要素 |
|---|---|
| プランニング | 前提条件・行動・結果 |
④ エキスパートシステム
知識をルールによって表現し、入力された知識を用いてコンピュータが専門家のように推論するシステムです。
専門分野の知識を取り込んだ上で推論することで、その分野の専門家のように振る舞うプログラムのことです。
| 項目 | 内容 |
|---|---|
| 知識の表し方 | ルールによって表現する |
| 振る舞い | その分野の専門家のように |
⑤ エキスパートシステムの歴史
1972年にスタンフォード大学で開発された「マイシン(MYCIN)」という医療診断を支援するシステムが世界初とされます。
| 年 | 出来事 |
|---|---|
| 1972年 | スタンフォード大学で「マイシン(MYCIN)」が開発される |
動作の例
たとえば、あらかじめ定めた病気に関する情報と判断のルールに沿って質問し、得られた回答に基づいて次の質問を選択するといった過程を繰り返すことで診断結果を提示します。
⑥ 機械学習
コンピュータが数値やテキスト、画像、音声などのさまざまかつ大量のデータからルールや知識を自ら学習する(見つけ出す)技術のことです。
| 項目 | 内容 |
|---|---|
| 対象データ | 数値やテキスト、画像、音声などのさまざまかつ大量のデータ |
| 何をする | ルールや知識を自ら学習する(見つけ出す) |
例
たとえば、消費者の一般的な購買データを大量に学習することで、消費者が購入した商品やその消費者の年齢等に適したオススメ商品を提示することが可能になります。
⑦ 深層学習(ディープラーニング)
機械学習のうち、多数の層からなるニューラルネットワークを用いるものです。
情報抽出を一層ずつ多階層にわたって行うことで、高い抽象化を実現します。
| 項目 | 内容 |
|---|---|
| 位置づけ | 機械学習のうち、多数の層からなるニューラルネットワークを用いるもの |
| 特徴 | 情報抽出を一層ずつ多階層にわたって行い、高い抽象化を実現 |
⑧ 従来の機械学習との違い
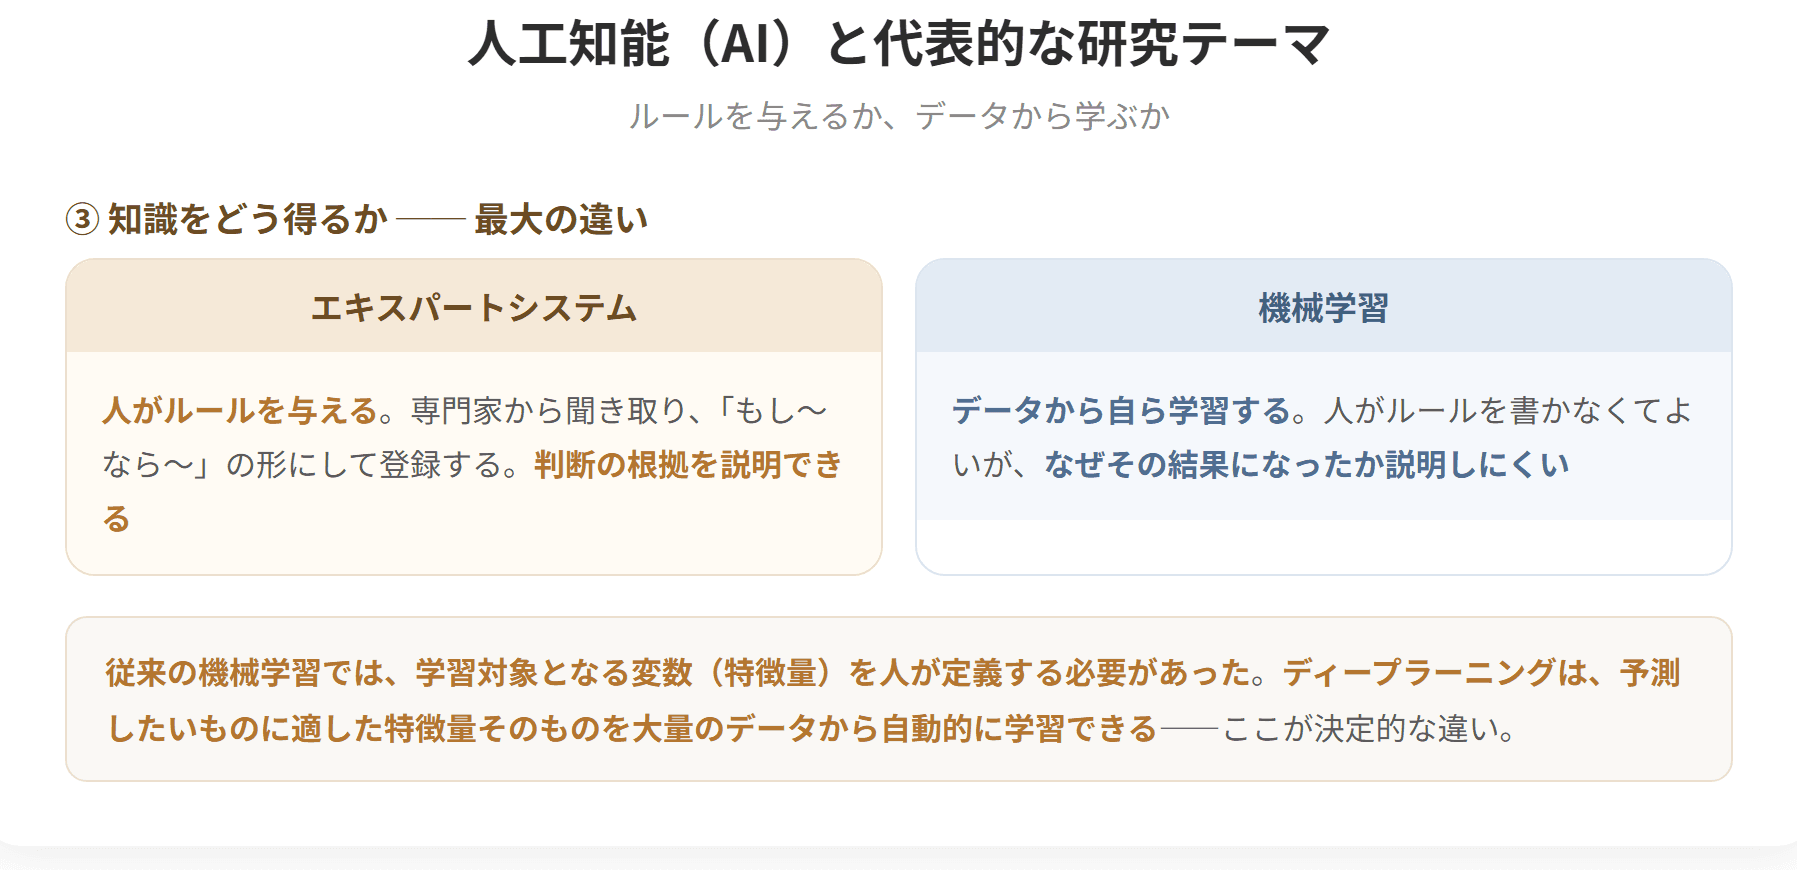
従来の機械学習では、学習対象となる変数(特徴量)を人が定義する必要がありました。
ディープラーニングは、予測したいものに適した特徴量そのものを大量のデータから自動的に学習することができる点に違いがあります。
| 従来の機械学習 | ディープラーニング | |
|---|---|---|
| 特徴量 | 人が定義する必要があった | 大量のデータから自動的に学習できる |
⑨ ディープラーニングに必要なもの
精度を上げる(ロバスト性を高める)手法と、その膨大な計算を可能にするだけのコンピュータの計算能力が重要になります。
| 必要なもの |
|---|
| 精度を上げる(ロバスト性を高める)手法 |
| 膨大な計算を可能にするだけのコンピュータの計算能力 |
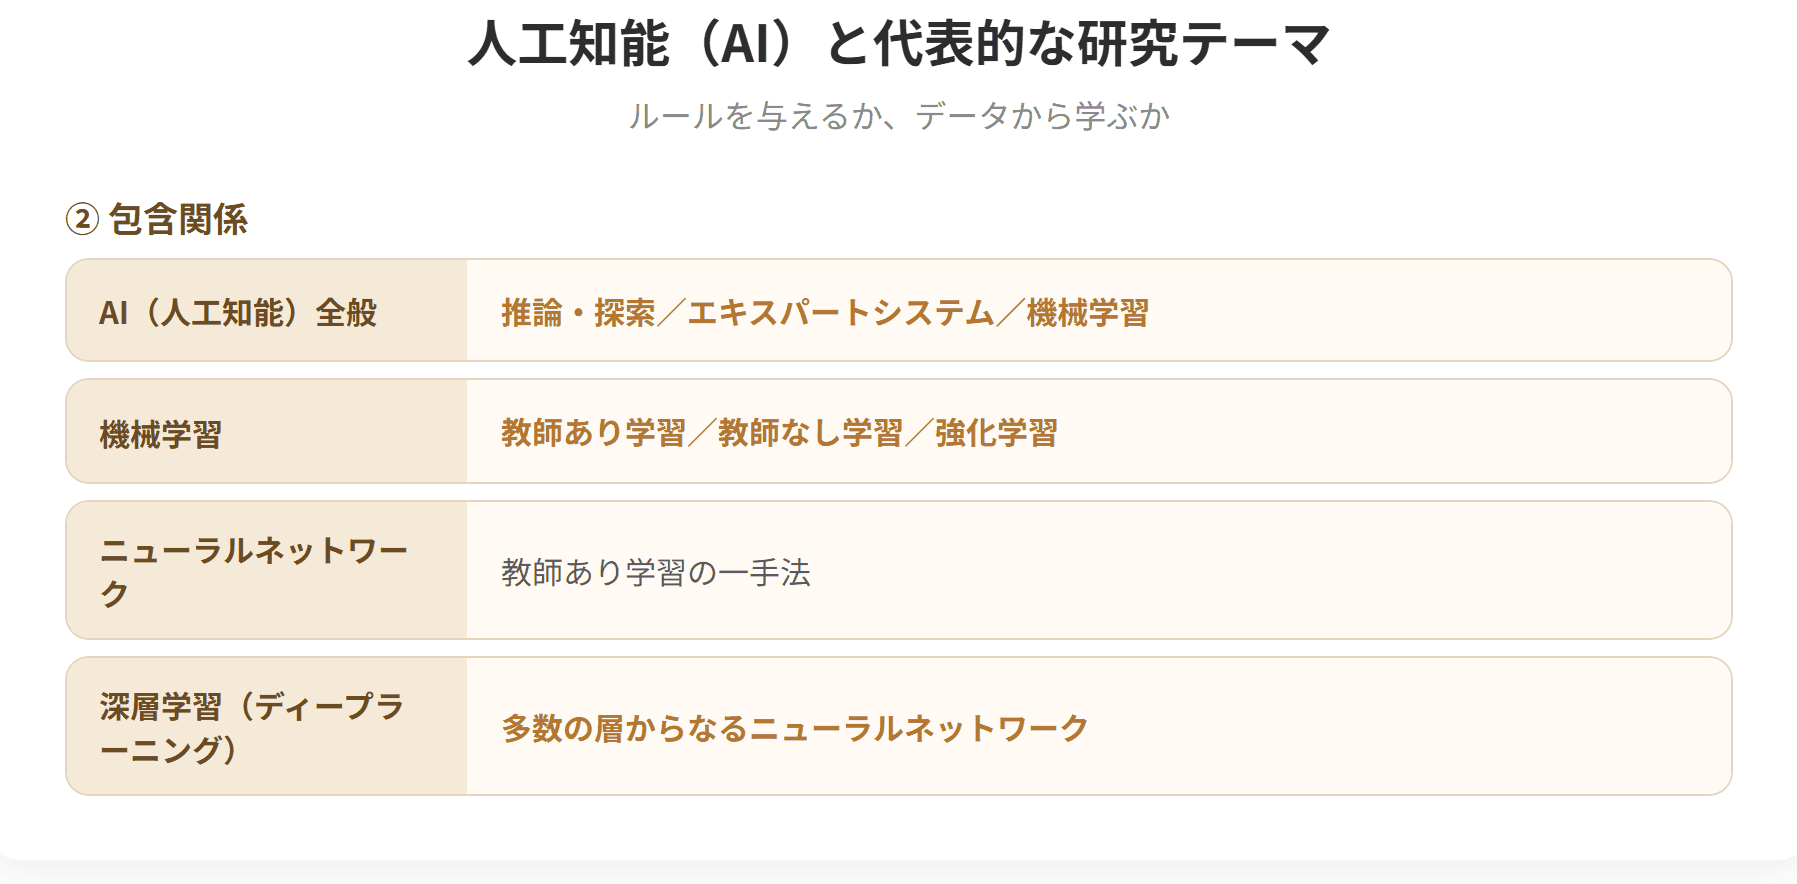
⑩ 4つの包含関係
| 大きさ | 用語 |
|---|---|
| 最も広い | AI(人工知能)全般 |
| その中 | 機械学習 |
| その中 | ニューラルネットワーク |
| 最も狭い | 深層学習(ディープラーニング) |
エキスパートシステムは機械学習の外側
| 用語 | 位置 |
|---|---|
| エキスパートシステム | AIの中だが、機械学習ではない |
| 推論・探索 | 同上 |
知識を人が与えるか、データから学ぶか
| エキスパートシステム | 機械学習 | |
|---|---|---|
| 知識の入手 | 人がルールを与える | データから自ら学習する |
⑪ 判別のキーワード
| 選択肢の語 | 対応する用語 |
|---|---|
| 知識をルールによって表現し、専門家のように推論する | エキスパートシステム |
| 大量のデータからルールや知識を自ら学習する | 機械学習 |
| 多数の層からなるニューラルネットワークを用いる | 深層学習(ディープラーニング) |
| 人間の思考過程を記号で表現し実行する | 推論 |
| 知識をルールで表現し専門家のように推論 |
| エキスパートシステム |
| c(強化学習) | 多数の層からなるニューラルネットワーク | 深層学習 |
| d(深層学習) | 試行錯誤し、得点や報酬を与える | 強化学習 |
cとdが入れ替わっている
| 用語 | 内容 |
|---|---|
| 深層学習 | 多数の層からなるニューラルネットワーク |
| 強化学習 | 試行錯誤、得点や報酬 |
判別の決め手
| キーワード | 用語 |
|---|---|
| ルール、専門家 | エキスパートシステム |
| 多数の層、ニューラルネットワーク | 深層学習 |
| 試行錯誤、得点や報酬 | 強化学習 |
エキスパートシステムと機械学習の本質的な違い
エキスパートシステムの場合
| 手順 | 内容 |
|---|---|
| ① | 専門家から知識を聞き取る |
| ② | 「もし〜なら〜である」というルールにする |
| ③ | ルールをシステムに登録する |
| ④ | 入力に対してルールを適用して推論する |
医療診断の例
| ルールの例 |
|---|
| もし発熱があり、かつ咳があるなら、呼吸器の疾患を疑う |
| もし呼吸器の疾患を疑い、かつ喀痰があるなら、次の検査を行う |
機械学習の場合
| 手順 | 内容 |
|---|---|
| ① | 過去の診断データを大量に集める |
| ② | 症状と診断結果の対応をデータから学習する |
| ③ | 新しい症状に対して結果を予測する |
それぞれの長所と短所
| エキスパートシステム | 機械学習 | |
|---|---|---|
| 必要なもの | 専門家の知識 | 大量のデータ |
| 説明のしやすさ | 高い(ルールを見れば分かる) | 低い(なぜその結果か分かりにくい) |
| 未知の状況 | 対応できない | ある程度対応できる |
| 構築の手間 | ルールを1つずつ作る | データを集めて学習させる |
「説明のしやすさ」が実務では重要
| 場面 | 求められること |
|---|---|
| 融資の審査 | なぜ断ったのかを説明する必要がある |
| 採用の判断 | 同上 |
| 医療の診断 | 判断の根拠が必要 |
機械学習の「説明できない」問題
| 状況 | 内容 |
|---|---|
| AIが「不可」と判定した | 理由が分からない |
| 顧客に説明できない | トラブルのもと |
この問題への対応として「説明可能なAI(XAI)」の研究が進んでいます。
中小企業でのAI活用
| 用途 | 手法 |
|---|---|
| 需要予測 | 機械学習(教師あり学習) |
| 不良品の検出 | 深層学習(画像認識) |
| 顧客の分類 | 機械学習(教師なし学習) |
| 問い合わせ対応 | チャットボット |
| 文書の作成・要約 | 生成AI |
導入の現実
| 自社で開発 | サービスを使う | |
|---|---|---|
| 費用 | 大きい | 小さい |
| 必要な人材 | データサイエンティスト | 不要 |
| 現実性 | 低い | 高い |
中小企業は「サービスとして使う」が基本
| サービス | 例 |
|---|---|
| 需要予測 | クラウドの分析サービス |
| 画像による検査 | AI検査装置 |
| 文書作成 | 生成AIサービス |
「AIを作る」のではなく「AIを使う」——この整理が実務的です。
AI導入で最も重要なこと
| 要素 | 内容 |
|---|---|
| データ | 量と質が結果を決める |
データがなければAIは使えない
| 状況 | 判断 |
|---|---|
| 過去3年分の販売データがある | 需要予測に使える |
| 紙の伝票しかない | まずデータ化から |
| データはあるが不正確 | まず整備から |
「まずデータを整える」——AI導入の相談を受けたとき、最初に確認すべき点です。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 人工知能(AI)とは、人工的にコンピュータ上で人間と同様の知能を実現しようとする試み、またはその技術の総称である。
> b エキスパートシステムでは、1972年にスタンフォード大学で開発された「マイシン(MYCIN)」という医療診断を支援するシステムが世界初とされる。
> c 従来の機械学習では、学習対象となる変数(特徴量)を大量のデータから自動的に学習することができた。
解答 a:○ b:○ c:×
| 強化学習 |
| reinforcement learning |
② 教師あり学習
教師あり学習は、あらかじめ正解の札が貼ってあるデータを使って学ばせるやり方です。
たとえば、写真データに「犬」や「猫」などの正解ラベルを含んでいるものです。
| 項目 | 内容 |
|---|---|
| データ | 正解ラベルが付いている |
③ 教師あり学習の典型的な手法
典型的な教師あり学習には、回帰分析、判別分析、ロジスティック回帰、決定木、ランダムフォレスト、サポートベクターマシン(SVM)などがあります。
| 手法 |
|---|
| 回帰分析 |
| 判別分析 |
| ロジスティック回帰 |
| 決定木 |
| ランダムフォレスト |
| サポートベクターマシン(SVM) |
④ 教師なし学習
教師なし学習とは、正解ラベルが付いていないデータに関する学習です。
| 項目 | 内容 |
|---|---|
| データ | 正解ラベルが付いていない |
⑤ 教師なし学習の典型的な手法
典型的な教師なし学習には、クラスター分析、主成分分析、因子分析などがあり、それぞれ目的によって、使い分ける必要があります。
| 手法 |
|---|
| クラスター分析 |
| 主成分分析 |
| 因子分析 |
⑥ 教師ありと教師なしの判別
令和4年度・令和7年度の本試験では、この分類が問われました。
| 手法 | 分類 |
|---|---|
| 回帰分析 | 教師あり |
| 判別分析 | 教師あり |
| ロジスティック回帰 | 教師あり |
| 決定木 | 教師あり |
| ランダムフォレスト | 教師あり |
| サポートベクターマシン(SVM) | 教師あり |
| クラスター分析 | 教師なし |
| 主成分分析 | 教師なし |
| 因子分析 | 教師なし |
覚え方
| 分類 | 手法の性格 |
|---|---|
| 教師あり | 予測する(結果が分かっているデータから学ぶ) |
| 教師なし | まとめる・要約する(正解がないデータの構造を見つける) |
⑦ 強化学習
強化学習とは、一定の環境の中で試行錯誤を行い、個々の行動に対して得点や報酬を与えることによって、ゴールの達成に向けた行動の仕方を獲得する機械学習の学習法のひとつです。
| 項目 | 内容 |
|---|---|
| 環境 | 一定の環境の中で試行錯誤を行う |
| 仕組み | 個々の行動に対して得点や報酬を与える |
| 獲得するもの | ゴールの達成に向けた行動の仕方 |
⑧ 3つの分類と主な用途
| 分類 | 手法の種類 | 主な用途 | まとめると |
|---|---|---|---|
| 教師あり学習 | 回帰 | 売上予測、人口予測、需要予測、不正検知 | 予測 |
| 教師あり学習 | 分類 | 故障診断、画像分類(画像認識)、文字分類(文字認識) | 予測 |
| 教師なし学習 | クラスタリング | 顧客セグメンテーション | グループ分け |
| 教師なし学習 | 次元削減 | 画像圧縮 | 要約 |
| 強化学習 | バンディットアルゴリズム | ゲームAI、広告AI、自動運転車、リアルタイム判断 | 最適化 |
| 強化学習 | Q学習 | 同上 | 最適化 |
⑨ 3つを一言で
| 分類 | 一言でいうと |
|---|---|
| 教師あり学習 | 予測 |
| 教師なし学習 | グループ分け・要約 |
| 強化学習 | 最適化 |
⑩ 回帰と分類の違い
教師あり学習は、さらに2つに分かれます。
| 回帰 | 分類 | |
|---|---|---|
| 予測するもの | 連続した数値 | カテゴリ |
| 例 | 来月の売上は何円か | この画像は犬か猫か |
⑪ 統計解析とのつながり
第14章の多変量解析で学ぶ手法が、そのまま機械学習の手法として登場します。
| 手法 | どこで学ぶか |
|---|---|
| 回帰分析 | 第14章 多変量解析 |
| 判別分析 | 同上 |
| クラスター分析 | 同上 |
| 主成分分析 | 同上 |
| 因子分析 | 同上 |
統計の手法が、機械学習の手法でもある——この対応関係を押さえておくと、両方の理解が深まります。
具体例
設例 機械学習の分類
> 次の記述の正誤を判定せよ。(令和4年度第15問、令和7年度第25問 改題)
> a 教師あり学習とは、データに正解ラベルが付いているものに対して機械学習を行う手法である。
> b クラスター分析は、典型的な教師あり学習の手法である。
> c 教師なし学習とは、正解ラベルが付いていないデータに関する学習である。
解答 a:○ b:× c:○
手法の分類が問われる
| 教師あり学習 | 教師なし学習 |
|---|---|
| 回帰分析 | クラスター分析 |
| 判別分析 | 主成分分析 |
| ロジスティック回帰 | 因子分析 |
| 決定木 | — |
| ランダムフォレスト | — |
| サポートベクターマシン(SVM) | — |
中小企業での応用を、3分類で考える
教師あり学習の例:需要予測
| 学習データ | 内容 |
|---|---|
| 入力 | 気温、曜日、天気、イベントの有無、前年同日の売上 |
| 正解ラベル | その日の実際の売上 |
学習後にできること
| 入力 | 出力 |
|---|---|
| 明日の気温と天気予報 | 明日の売上予測 |
効果
| 効果 | 内容 |
|---|---|
| 発注の精度が上がる | 欠品と廃棄が減る |
| シフトの計画が立つ | 人件費の最適化 |
飲食店・小売業で効果が大きい
| 業種 | 削減できるもの |
|---|---|
| 飲食 | 食材の廃棄 |
| 小売(生鮮) | 値引き・廃棄 |
| 製造 | 在庫 |
教師あり学習の例:不良品の検出(分類)
| 学習データ | 内容 |
|---|---|
| 入力 | 製品の画像 |
| 正解ラベル | 「良品」「不良品」 |
学習後にできること
| 入力 | 出力 |
|---|---|
| 新しい製品の画像 | 良品か不良品かの判定 |
必要なデータ量
| 項目 | 目安 |
|---|---|
| 良品の画像 | 数百〜数千枚 |
| 不良品の画像 | 数百枚以上 |
「不良品の画像が足りない」という問題
| 状況 | 内容 |
|---|---|
| 不良率が0.1% | 不良品の画像が集まらない |
| 学習できない | データ不足 |
対応
| 対応 | 内容 |
|---|---|
| 良品だけを学習させる | 「良品と違うもの」を検出する(異常検知) |
| 画像を加工して水増しする | 回転、明るさの変更など |
教師なし学習の例:顧客のグループ分け
| 入力データ | 内容 |
|---|---|
| 購買履歴 | 購入頻度、購入金額、購入商品 |
| 正解ラベル | なし |
結果
| クラスター | 特徴 |
|---|---|
| A群 | 高頻度・高単価 |
| B群 | 高頻度・低単価 |
| C群 | 低頻度・高単価 |
| D群 | 低頻度・低単価 |
「正解がない」ことの意味
| 教師あり | 教師なし | |
|---|---|---|
| 事前に決めること | 何を予測するか | いくつに分けるか(程度) |
| 結果 | 正解との比較で評価 | 人が解釈する必要がある |
「人が解釈する」のが教師なし学習の特徴
| 結果 | 解釈 |
|---|---|
| 4つのグループに分かれた | それぞれどういう顧客か考える |
| 意味が読み取れない分け方 | やり直す |
マーケティングとのつながり
企業経営理論で学ぶセグメンテーションが、データから自動的に行えるようになります。
| 従来 | クラスター分析 | |
|---|---|---|
| 分け方 | 年齢、性別など事前に決めた軸 | 実際の行動データから |
| 発見 | 予想の範囲 | 予想外の群が見つかる |
強化学習の例
| 用途 | 内容 |
|---|---|
| ゲームAI | 勝てば報酬、負ければ罰 |
| 広告の出し分け | クリックされたら報酬 |
| 自動運転 | 安全に走れば報酬 |
| 在庫の発注量 | 欠品も過剰も罰、適正なら報酬 |
中小企業で強化学習を使う場面は限られる
| 理由 | 内容 |
|---|---|
| 試行錯誤の場が必要 | 現実の業務では失敗できない |
| シミュレーション環境が要る | 構築が難しい |
教師あり学習と教師なし学習が中心——中小企業でのAI活用は、この2つが現実的です。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 典型的な教師あり学習には、回帰分析、判別分析、ロジスティック回帰、決定木、ランダムフォレスト、サポートベクターマシンなどがある。
> b 典型的な教師なし学習には、クラスター分析、主成分分析、因子分析などがある。
> c 強化学習とは、一定の環境の中で試行錯誤を行い、個々の行動に対して得点や報酬を与えることによって、ゴールの達成に向けた行動の仕方を獲得する学習法である。
解答 a:○ b:○ c:○
いずれも正しい記述です。どの手法がどの分類に属するかを、一覧で押さえておきましょう。
AI・機械学習の分類
試験のポイント
| 隠れ層(中間層) |
| 入口と出口にはさまれた層。ここが厚いほど「深い」 |
| 出力層 | いちばん奥。予測や分類の答えを出す |
③ ディープニューラルネットワーク
特に隠れ層が複数あるニューラルネットワークはディープニューラルネットワークとよばれます。
| ニューラルネットワーク | ディープニューラルネットワーク | |
|---|---|---|
| 隠れ層 | 1層 | 複数 |
「深い(ディープ)」とは、層が多いこと——これがディープラーニングの名前の由来です。
④ ニューロン(ノード)
| 用語 | 内容 |
|---|---|
| ニューロン(ノード) | ニューラルネットワークの基本的な処理単位 |
⑤ 重み
| 用語 | 内容 |
|---|---|
| 重み | ニューロン間の関係の強さ |
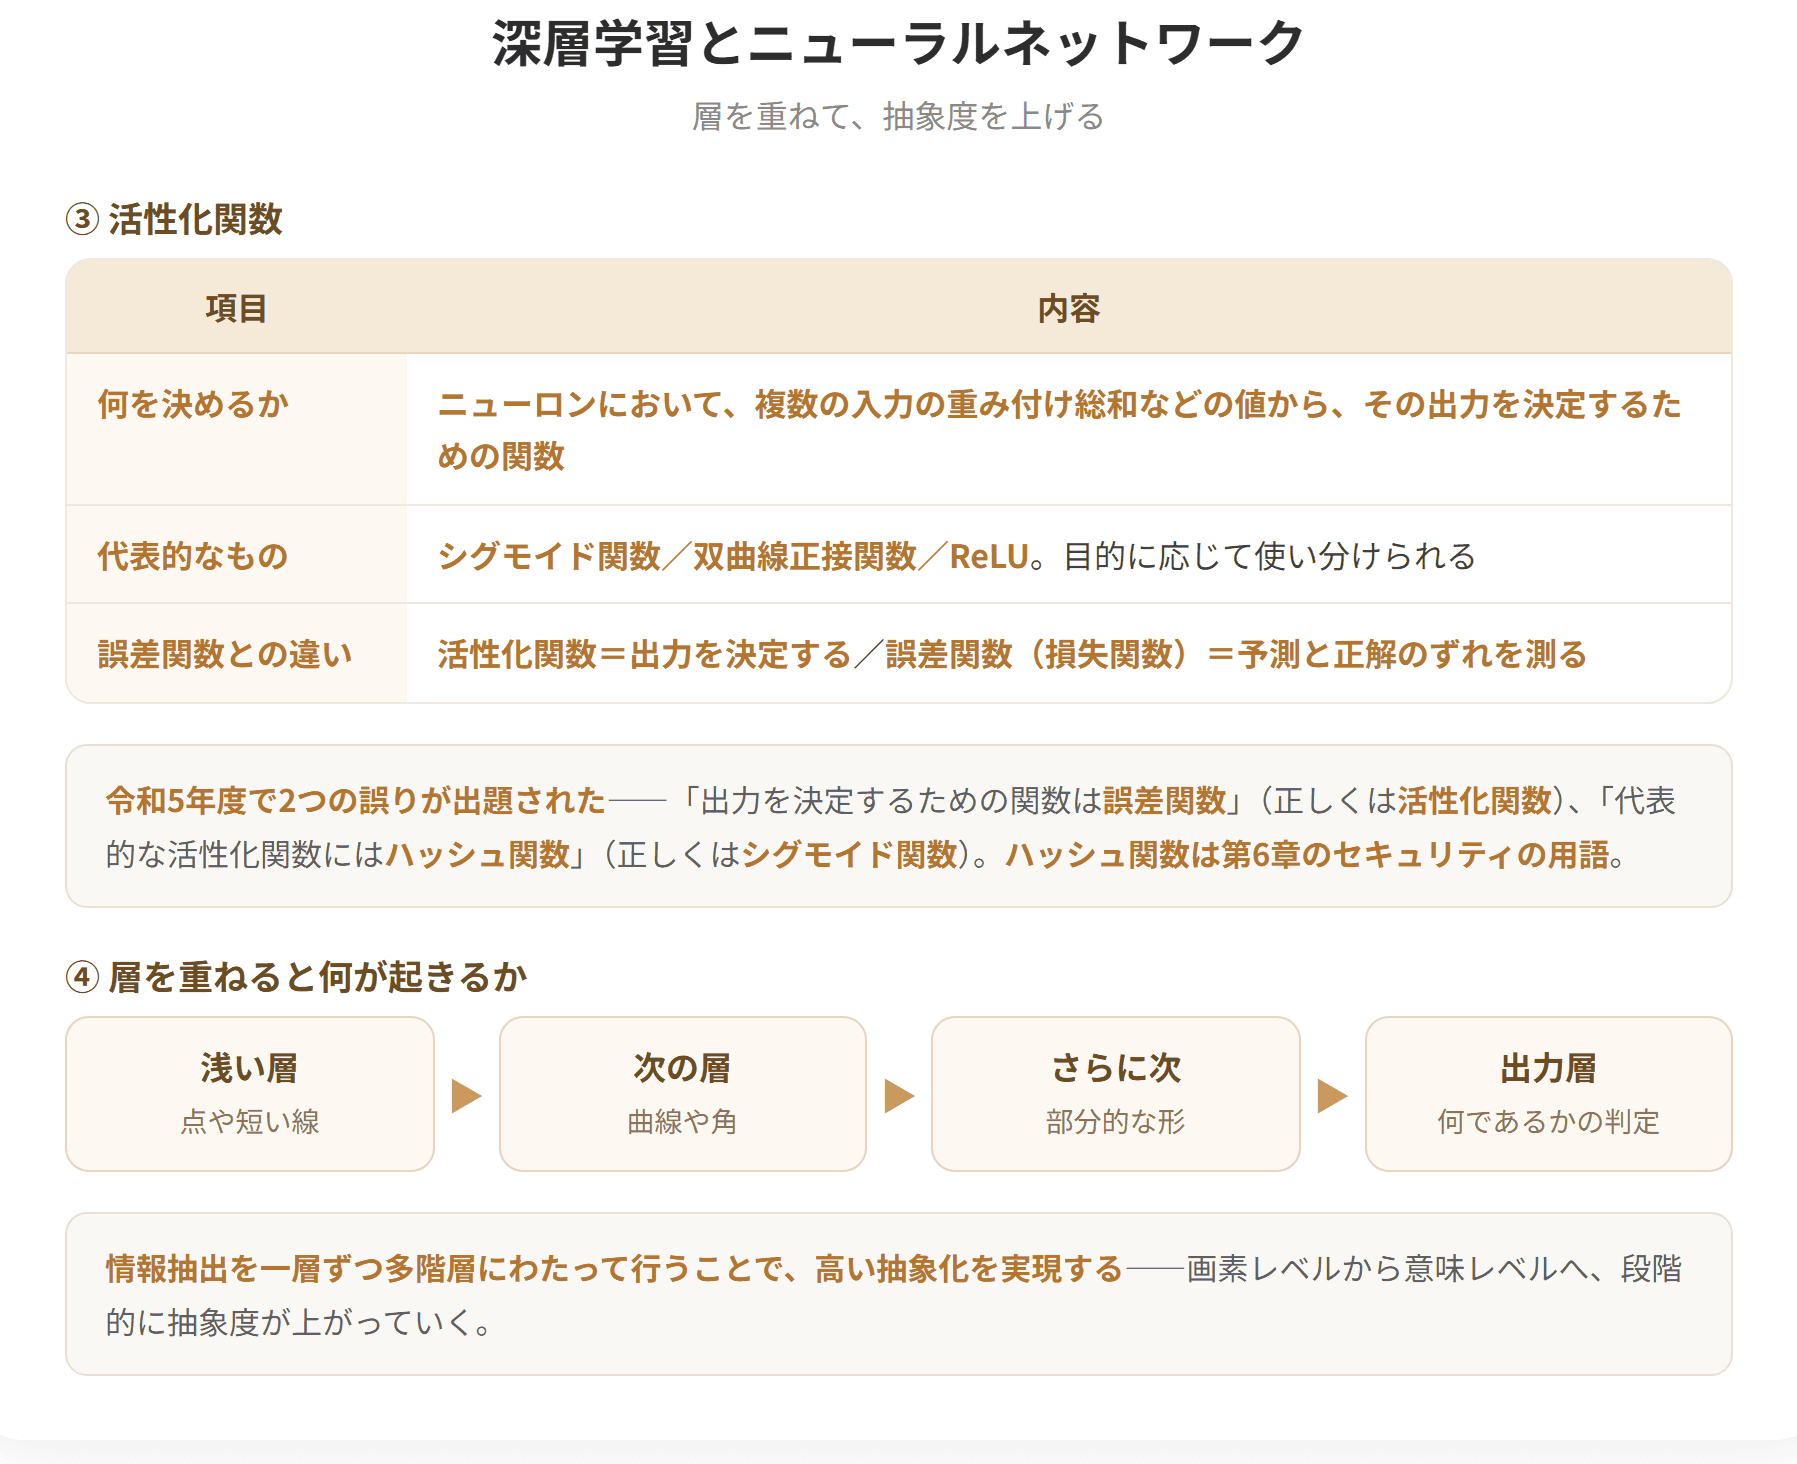
⑥ 活性化関数
ニューラルネットワークの中のニューロンにおいて、複数の入力の重み付け総和などの値から、その出力を決定するための関数は活性化関数とよばれます。
| 項目 | 内容 |
|---|---|
| 何を決めるか | その出力 |
| 何から決めるか | 複数の入力の重み付け総和などの値 |
⑦ 代表的な活性化関数
代表的な活性化関数には、シグモイド関数、双曲線正接関数、ReLUなどがあり、これらは目的に応じて使い分けられます。
| 活性化関数 |
|---|
| シグモイド関数 |
| 双曲線正接関数 |
| ReLU |
令和5年度の本試験では、「ハッシュ関数」が代表的な活性化関数として出題され、誤りとされました。
| 関数 | 何に使うか |
|---|---|
| ハッシュ関数 | 第6章のセキュリティ対策(メッセージダイジェストの生成) |
| シグモイド関数・双曲線正接関数・ReLU | 活性化関数 |
⑧ 「活性化関数」と「誤差関数」の違い
令和5年度では、「出力を決定するための関数は誤差関数とよばれる」という記述が誤りとされました。
| 用語 | 役割 |
|---|---|
| 活性化関数 | 出力を決定する |
| 誤差関数(損失関数) | 予測と正解のずれを測る |
「出力を決定する」のは活性化関数——この一点が判別の決め手です。
⑨ ニューラルネットワークの動き
| 順 | 内容 |
|---|---|
| ① | 入力層が外部からデータを受け取る |
| ② | 各ニューロンが、入力に重みを掛けて合計する |
| ③ | 活性化関数が、その値から出力を決定する |
| ④ | 次の層へ渡す |
| ⑤ | 出力層が最終的な予測や分類の結果を出力する |
⑩ 学習とは何をするのか
| 対象 | 内容 |
|---|---|
| 学習で調整するもの | 重み |
学習の流れ
| 順 | 内容 |
|---|---|
| ① | データを入力して予測を出す |
| ② | 正解と比べて誤差を測る(誤差関数) |
| ③ | 誤差が小さくなるように重みを調整する |
| ④ | ①へ戻る |
大量のデータでこれを繰り返すことで、精度が上がっていく——これが「学習」の中身です。
⑪ 深層学習が強い分野
| 分野 | 内容 |
|---|---|
| 画像認識 | 写真から物体を識別する |
| 音声認識 | 音声を文字にする |
| 自然言語処理 | 文章を理解・生成する |
⑫ 深層学習が必要とするもの
| 必要なもの | 内容 |
|---|---|
| 大量のデータ | 数万〜数百万件 |
| 計算能力 | 膨大な計算を可能にするコンピュータ |
| 精度を上げる手法 | ロバスト性を高める |
この3つが揃わないと実用にならない——中小企業が自前で深層学習モデルを作るのが難しい理由がここにあります。
具体例
設例 ニューラルネットワーク
> 次の記述の正誤を判定せよ。(令和5年度第3問 改題)
> a ニューラルネットワークは、入力層、隠れ層、出力層の3つの層から構成されるが、特に隠れ層が複数あるニューラルネットワークはディープニューラルネットワークとよばれる。
> b ニューラルネットワークの中のニューロンにおいて、複数の入力の重み付け総和などの値から、その出力を決定するための関数は誤差関数とよばれる。
> c ニューラルネットワークにおいて出力を決定するために用いられる代表的な活性化関数には、ハッシュ関数、双曲線正接関数、ReLUなどがあり、これらは目的に応じて使い分けられる。
解答 a:○ b:× c:×
2つの誤りの型
| 選択肢 | 誤りの内容 |
|---|---|
| b | 用語を別のものに差し替えている(活性化関数 → 誤差関数) |
| c | 3つのうち1つだけを差し替えている(シグモイド関数 → ハッシュ関数) |
cの誤りが巧妙
| 正しい3つ | 選択肢の3つ |
|---|---|
| シグモイド関数 | ハッシュ関数 |
| 双曲線正接関数 | 双曲線正接関数 |
| ReLU | ReLU |
2つが正しいので見逃しやすい——3つとも確認する習慣が必要です。
ハッシュ関数がどこで出てきたか
| 章 | 用途 |
|---|---|
| 第6章 セキュリティ対策 | メッセージダイジェストの生成、デジタル署名 |
別の分野の用語を持ち込む——これが出題者のよく使う手です。
ニューラルネットワークを、具体例で追う
例:手書き数字の認識
| 層 | 内容 |
|---|---|
| 入力層 | 画像の各画素の明るさ(28×28なら784個のニューロン) |
| 隠れ層 | 特徴を抽出する層(複数) |
| 出力層 | 0〜9の10個のニューロン |
出力の読み方
| ニューロン | 出力値 |
|---|---|
| 「0」 | 0.01 |
| 「1」 | 0.02 |
| … | — |
| 「7」 | 0.89 |
| … | — |
最も値が大きいニューロンが答え——この例では「7」と判定されます。
隠れ層が何をしているか
| 層 | 抽出する特徴 |
|---|---|
| 1層目 | 点や短い線 |
| 2層目 | 曲線や角 |
| 3層目 | 数字の部分的な形 |
| 出力層 | どの数字か |
「情報抽出を一層ずつ多階層にわたって行うことで、高い抽象化を実現する」
| 段階 | 抽象度 |
|---|---|
| 浅い層 | 低い(画素レベル) |
| 深い層 | 高い(意味レベル) |
「特徴量を人が定義する必要がない」ことの意味
従来の機械学習の場合
| 手順 | 内容 |
|---|---|
| ① | 人が「この特徴を見よう」と決める(線の数、曲がり方など) |
| ② | その特徴を計算するプログラムを書く |
| ③ | その特徴量を機械学習に入力する |
①と②に専門的な知識と手間がかかる
ディープラーニングの場合
| 手順 | 内容 |
|---|---|
| ① | 画像をそのまま入力する |
| ② | どの特徴を見るかは、学習の中で自動的に決まる |
画像認識が飛躍的に進歩した理由がここにあります。
中小企業での画像認識の活用
| 用途 | 内容 |
|---|---|
| 外観検査 | 傷、汚れ、変形の検出 |
| 仕分け | 商品の種類の判別 |
| 数量のカウント | 部品の個数 |
| 来店者の分析 | 人数、年代の推定 |
導入の形
| 自社で学習させる | 既製品を使う | |
|---|---|---|
| 必要なデータ | 数千枚 | 少量で調整 |
| 費用 | 大きい | 小さい |
| 期間 | 長い | 短い |
「既製品を自社データで少し調整する」が現実的
| 手法 | 内容 |
|---|---|
| 転移学習 | 既に学習済みのモデルに、自社のデータを少し追加学習させる |
必要なデータが大幅に減る
| ゼロから学習 | 転移学習 | |
|---|---|---|
| 必要な画像 | 数万枚 | 数百枚 |
これにより、中小企業でも画像認識が使えるようになりました。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 入力層は、ニューラルネットワークの初めの層で、外部からのデータを受け取る層である。
> b ニューロン(ノード)は、ニューラルネットワークの基本的な処理単位である。
> c 重みとは、ニューロンにおいて出力を決定するための関数である。
解答 a:○ b:○ c:×
深層学習とニューラルネットワーク(1/2)
深層学習とニューラルネットワーク(2/2)
試験のポイント
| 内容 |
|---|
| 原因 | AIが生成したデータをAI自らが学習すること |
| 結果 | 言語モデルの精度が低下したり多様性が失われたりする |
③ なぜモデル崩壊が起きるのか
| 段階 | 内容 |
|---|---|
| ① | AIが文章を生成する |
| ② | その文章がインターネット上に公開される |
| ③ | 次世代のAIがそれを学習データとして取り込む |
| ④ | AIが生成したものを学習することで、偏りが増幅される |
コピーのコピーを繰り返すようなもの
| 回数 | 品質 |
|---|---|
| 1回目 | 元の品質 |
| 2回目 | やや劣化 |
| 3回目以降 | さらに劣化 |
④ ハルシネーション
事実に基づかない情報や実際には存在しない情報をAIが生成する現象のことです。
AIが幻覚(Hallucinations)を見ているかのように、もっともらしい嘘(事実とは異なる内容)を出力するため、このようによばれています。
この問題は自然言語処理(NLP)などの分野で顕著に現れます。
| 項目 | 内容 |
|---|---|
| 現象 | 事実に基づかない情報や実際には存在しない情報を生成する |
| 語源 | 幻覚(Hallucinations) |
| 特徴 | もっともらしい嘘を出力する |
| 顕著な分野 | 自然言語処理(NLP) |
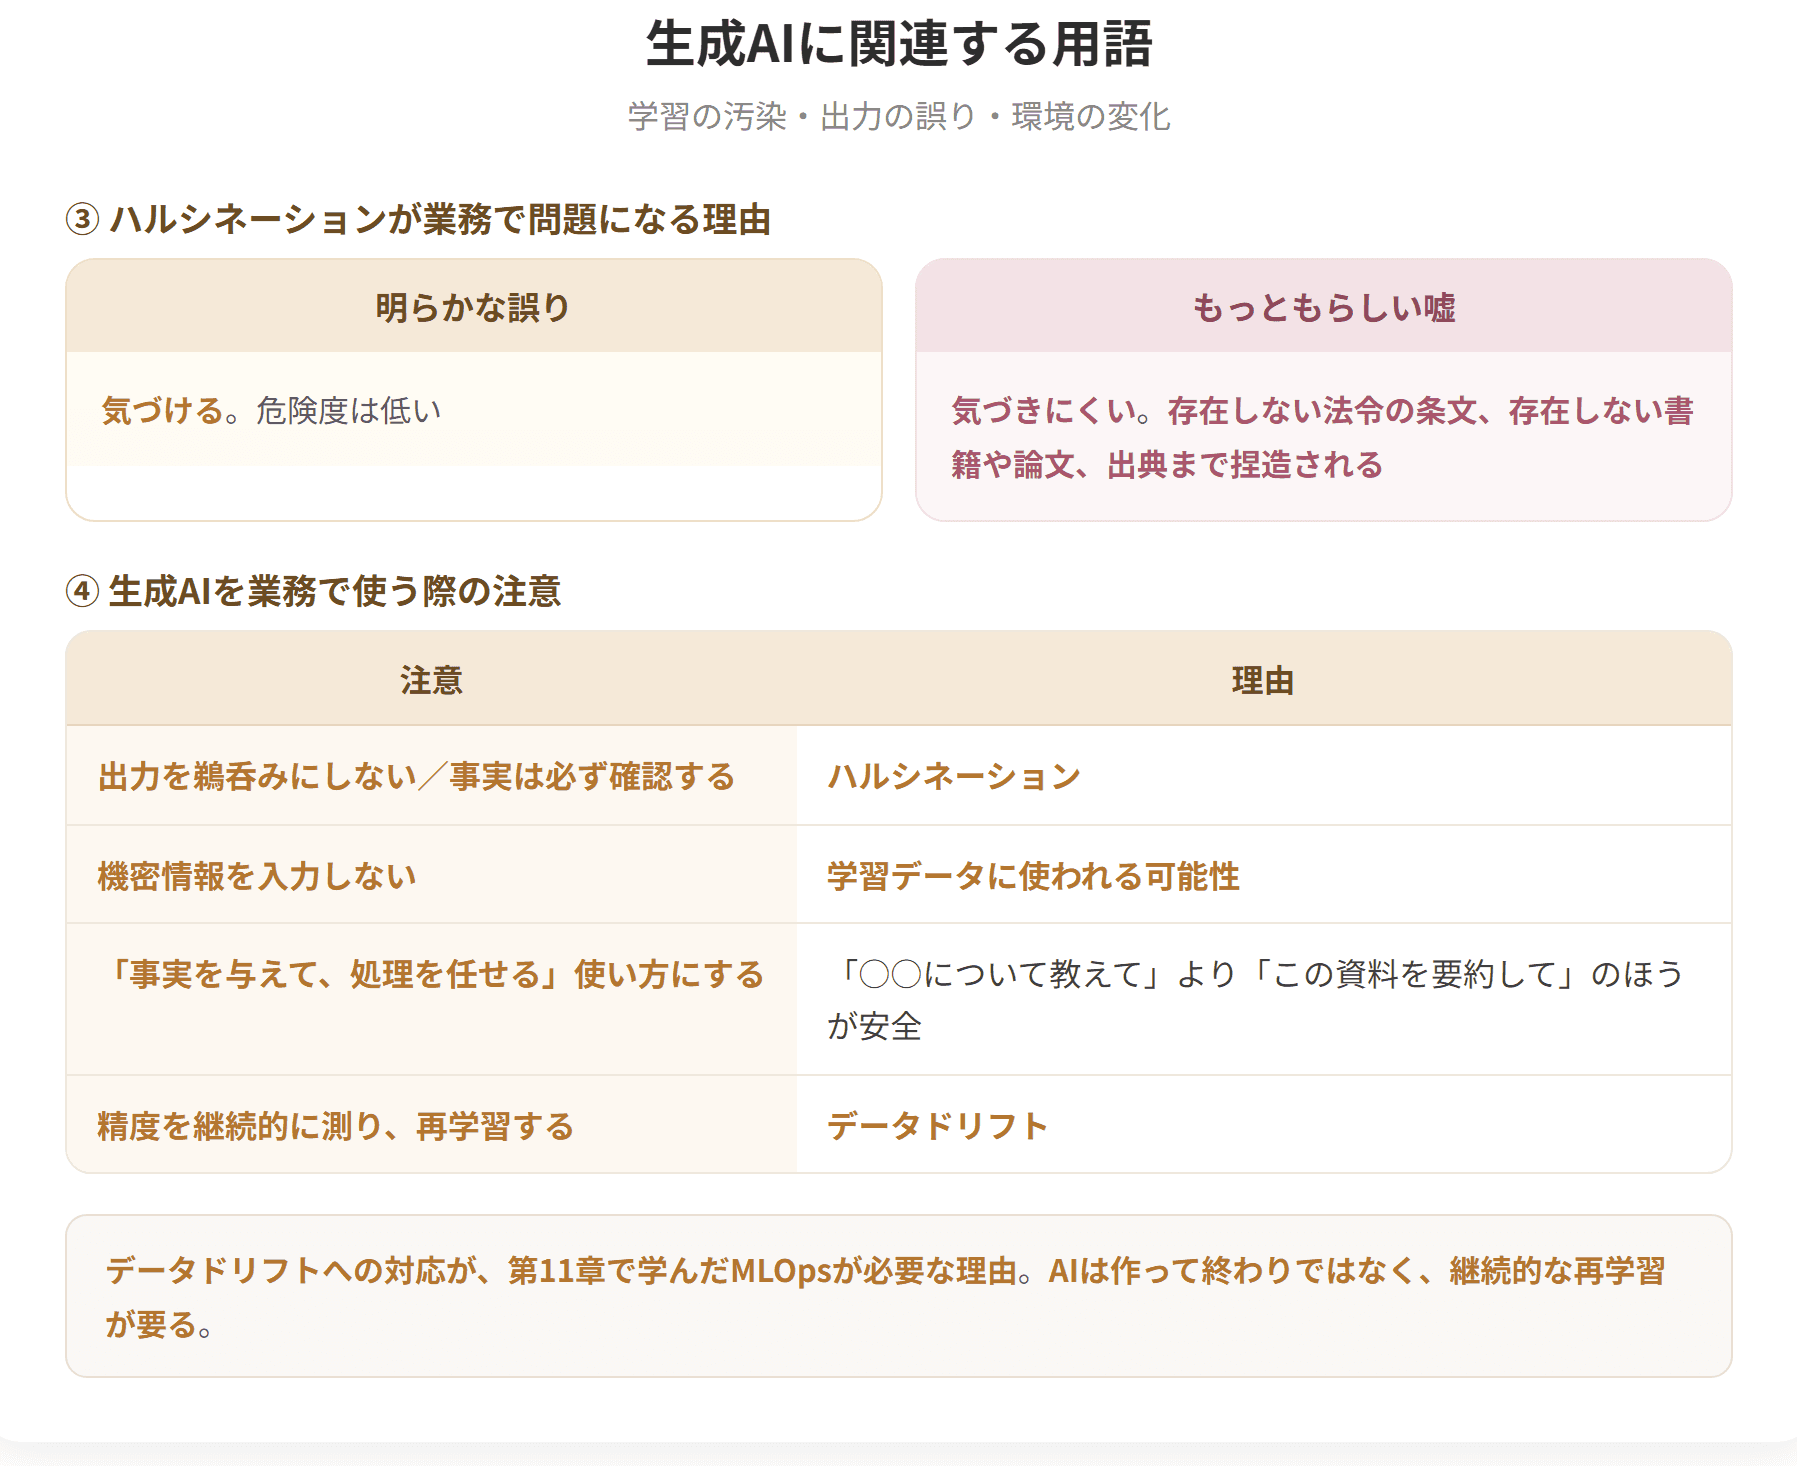
⑤ 「もっともらしい」ことが問題
| 明らかな誤り | もっともらしい嘘 | |
|---|---|---|
| 気づけるか | 気づける | 気づきにくい |
| 危険度 | 低い | 高い |
実際に起きる例
| 内容 | 状況 |
|---|---|
| 存在しない法令の条文を答える | もっともらしい条番号と内容 |
| 存在しない書籍や論文を挙げる | 著者名も出典も具体的 |
| 存在しない企業の事例を語る | 数字まで詳細 |
⑥ データドリフト
モデル訓練時の入力データの統計的分布と、テスト時/本番環境での入力データの統計的分布が、何らかの変化によってズレてくる現象のことです。
生成AIに限らず、機械学習全般で問題となる現象です。
| 項目 | 内容 |
|---|---|
| 何がズレるか | 入力データの統計的分布 |
| いつと比べて | モデル訓練時と、テスト時/本番環境 |
| 範囲 | 生成AIに限らず、機械学習全般で問題となる |
⑦ データドリフトが起きる例
| 状況 | 内容 |
|---|---|
| 消費者の好みが変わった | 需要予測の前提が崩れる |
| 製造ラインを変更した | 不良品検出の画像が変わる |
| 経済環境が変わった | 与信判断の前提が崩れる |
| 季節が変わった | データの傾向が変わる |
⑧ 3つの用語の判別
| キーワード | 対応する用語 |
|---|---|
| AIが生成したデータをAI自らが学習する | モデル崩壊 |
| 事実に基づかない情報を生成する、もっともらしい嘘 | ハルシネーション |
| 入力データの統計的分布がズレてくる | データドリフト |
⑨ 3つの性格の違い
| 用語 | 何の問題か |
|---|---|
| モデル崩壊 | 学習データの汚染 |
| ハルシネーション | 出力の誤り |
| データドリフト | 環境の変化への追随 |
⑩ 第9章のMLOpsとのつながり
第9章で学んだMLOps——機械学習と運用を組み合わせた開発の方法論——が必要になる理由が、このデータドリフトです。
| 問題 | 対応 |
|---|---|
| データドリフトによる精度の低下 | 継続的な再学習 |
| それを行う体制 | MLOps |
「AIは作って終わりではない」
| 誤解 | 実際 |
|---|---|
| 一度作れば動き続ける | 精度が落ちていく |
| 保守は不要 | 継続的な再学習が必要 |
⑪ 生成AIを業務で使う際の注意
| 注意 | 理由 |
|---|---|
| 出力を鵜呑みにしない | ハルシネーション |
| 事実は必ず確認する | 同上 |
| 機密情報を入力しない | 学習データに使われる可能性 |
| 著作権に注意する | 生成物の扱い |
具体例
設例 生成AIに関連する用語
> 次の記述の正誤を判定せよ。(令和6年度第24問 改題)
> a モデル崩壊とは、AIが生成したデータをAI自らが学習することで、言語モデルの精度が低下したり多様性が失われたりする現象のことである。
> b ハルシネーションとは、事実に基づかない情報や実際には存在しない情報をAIが生成する現象のことである。
> c データドリフトとは、生成AIに特有の現象であり、機械学習全般では問題とならない。
解答 a:○ b:○ c:×
3つを対比する
| 用語 | いつ起きるか | 何が起きるか |
|---|---|---|
| モデル崩壊 | 学習時 | 精度の低下、多様性の喪失 |
| ハルシネーション | 出力時 | もっともらしい嘘 |
| データドリフト | 運用時 | 前提とのズレによる精度低下 |
ハルシネーションが業務で問題になる場面
例1:法令の確認
| 状況 | 内容 |
|---|---|
| 生成AIに法令を尋ねた | もっともらしい条文が返る |
| 実際には存在しない | または内容が違う |
| それを基に判断した | 法令違反のおそれ |
対応
| 対応 | 内容 |
|---|---|
| 必ず原典を確認する | e-Gov法令検索など |
| AIは「あたりをつける」ために使う | 最終確認は人 |
例2:顧客への回答
| 状況 | 内容 |
|---|---|
| チャットボットが誤った回答をした | 顧客が損害を被る |
| 「AIが言った」では済まない | 企業の責任 |
対応
| 対応 | 内容 |
|---|---|
| 回答範囲を限定する | FAQの範囲内で答える |
| 自信がないときは人につなぐ | エスカレーション |
| 免責を明示する | 「参考情報です」 |
例3:資料の作成
| 状況 | 内容 |
|---|---|
| 統計データを尋ねた | もっともらしい数字が返る |
| 出典も示された | しかし存在しない |
| 資料に使った | 信用の失墜 |
「出典まで捏造される」ことを知っておく
| 誤解 | 実際 |
|---|---|
| 出典が示されているから正しい | 出典自体が存在しないことがある |
生成AIの適切な使い方
| 向く用途 | 理由 |
|---|---|
| 文章の下書き | 人が確認・修正する |
| 要約 | 元の文章が手元にある |
| 言い換え・整理 | 事実は元の文章から |
| アイデア出し | 正確さより発想 |
| プログラムの下書き | 動作を確認できる |
向かない用途
| 向かない用途 | 理由 |
|---|---|
| 事実の調査 | ハルシネーション |
| 最新情報の取得 | 学習データの時点が古い |
| 計算 | 誤ることがある |
| 法的・医学的な判断 | 責任の所在 |
「事実は与える、処理を任せる」
| 使い方 | 結果 |
|---|---|
| 「○○について教えて」 | ハルシネーションのリスク |
| 「この資料を要約して」 | リスクが小さい |
データドリフトへの対応
状況:需要予測モデルを導入して2年
| 時期 | 予測の精度 |
|---|---|
| 導入直後 | 誤差5% |
| 1年後 | 誤差8% |
| 2年後 | 誤差15% |
原因を調べると
| 変化 | 内容 |
|---|---|
| 主力商品が変わった | 学習時とは別の商品構成 |
| 客層が変わった | 近隣に競合が出店 |
| 営業時間を変更した | 時間帯別の傾向が変化 |
対応
| 対応 | 内容 |
|---|---|
| 直近のデータで再学習する | 新しい傾向を反映 |
| 定期的に再学習する仕組みを作る | 月次、四半期ごと |
| 精度を継続的に監視する | 閾値を下回ったら警告 |
「AIの精度を測り続ける」
| 指標 | 内容 |
|---|---|
| 予測と実績の誤差 | 毎月記録する |
| 誤差の推移 | 悪化していないか |
第11章で学んだデジタルガバナンス・コードの第4の柱——成果指標の設定・見直し——が、AIの運用でも必要になります。
モデル崩壊が示唆すること
| 状況 | 内容 |
|---|---|
| インターネット上にAI生成の文章が増える | 次世代のAIの学習データが汚染される |
これは社会全体の問題
| 対応 | 内容 |
|---|---|
| AI生成物の明示 | 人が書いたものと区別する |
| 学習データの選別 | 信頼できる情報源に限る |
企業としてできること
| 対応 | 内容 |
|---|---|
| 公開する文書は人が確認する | 誤情報を広げない |
| AI生成である旨を示す | 必要に応じて |
確認してみましょう
> 次の記述の正誤を判定せよ。
> a ハルシネーションは、AIが幻覚を見ているかのように、もっともらしい嘘を出力するため、このようによばれている。
> b ハルシネーションの問題は、自然言語処理(NLP)などの分野で顕著に現れる。
> c モデル崩壊とは、モデル訓練時と本番環境での入力データの統計的分布がズレてくる現象のことである。
解答 a:○ b:○ c:×
生成AIに関連する用語(1/2)
生成AIに関連する用語(2/2)
試験のポイント
| 陽性 |
| TP(真陽性の件数) |
| FN(偽陰性の件数) |
| 実際 | 陰性 | FP(偽陽性の件数) | TN(真陰性の件数) |
③ 4つの略語
| 略語 | 英語 | 意味 |
|---|---|---|
| TP | True Positive | 真陽性(実際も予測も陽性) |
| FP | False Positive | 偽陽性(実際は陰性なのに陽性と予測) |
| FN | False Negative | 偽陰性(実際は陽性なのに陰性と予測) |
| TN | True Negative | 真陰性(実際も予測も陰性) |
④ 略語の読み方
| 1文字目 | 意味 |
|---|---|
| T(True) | 予測が当たった |
| F(False) | 予測が外れた |
| 2文字目 | 意味 |
|---|---|
| P(Positive) | 陽性と予測した |
| N(Negative) | 陰性と予測した |
「当たったか外れたか」+「何と予測したか」——この2要素で読み解けます。
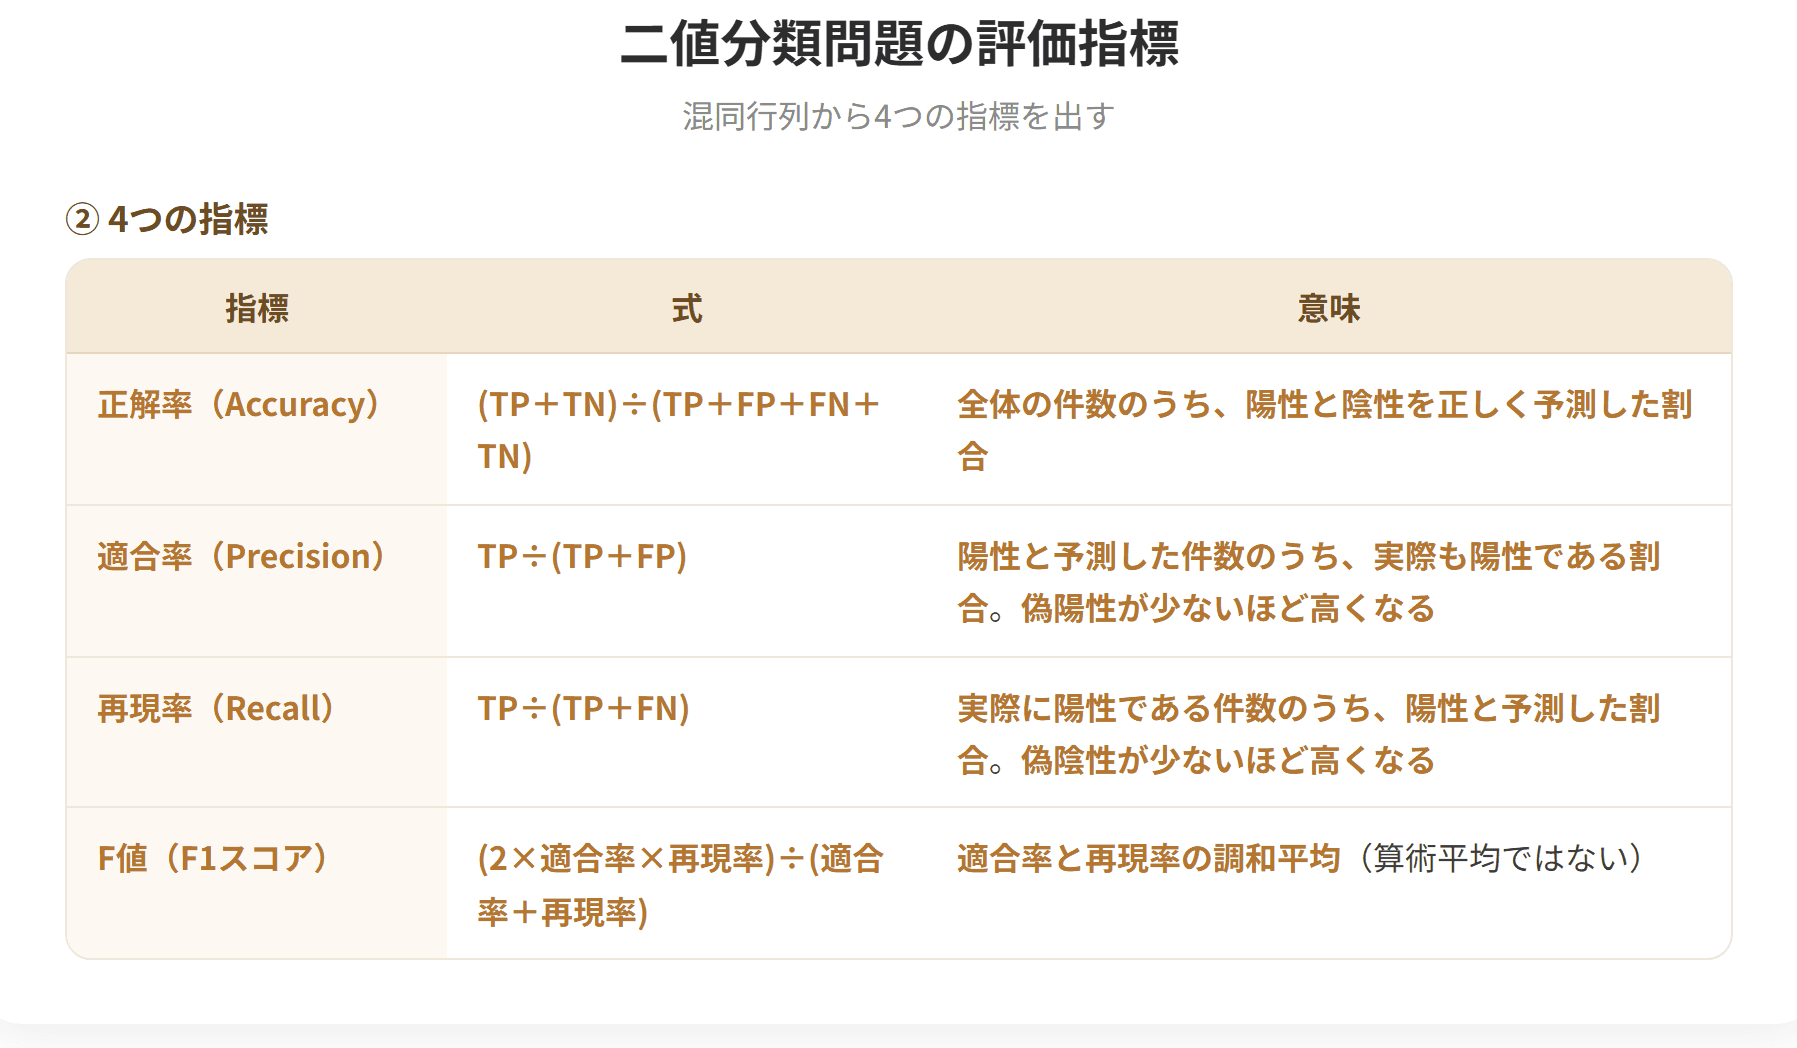
⑤ 代表的な4つの指標
代表的な指標として「正解率(Accuracy)」「適合率(Precision)」「再現率(Recall)」「F値(F1スコア)」があります。
⑥ 正解率(Accuracy)
全体の件数のうち、陽性と陰性を正しく予測した割合です。
モデルが正しく予測したデータの割合を表します。全体のデータ数に対して、正しく分類されたサンプルの割合を示します。
| 分子 | 分母 |
|---|---|
| 正しく予測した件数(TP+TN) | 全体の件数 |
⑦ 適合率(Precision)
陽性と予測した件数のうち、実際も陽性である割合です。
モデルが正例と予測したものの中で、実際に正例であったものの割合を示します。
偽陽性(FP:False Positive)の件数が少ないモデルほど、適合率が高くなります。
⑧ 適合率が重視される場面
スパムメールフィルタリングは、受信メールが「スパム」か「スパムでないか」に分類します。
この場合、スパムでないメールが誤ってスパムとして分類されると、重要なメールが見逃されてしまう可能性があります。
つまり、偽陽性になると影響が大きくなるため、適合率が重視されます。
| 場面 | 重視する指標 |
|---|---|
| スパムメールフィルタリング | 適合率 |
⑨ 再現率(Recall)
実際に陽性である件数のうち、陽性と予測した割合です。
実際に陽性であるデータで、モデルがどれだけ正しく陽性と予測できたかを示す指標です。
これは、偽陰性(FN:False Negative)が少ないモデルほど、再現率が高くなります。
⑩ 再現率が重視される場面
医療診断において、特定の病気(例:がん)を検出するような場合、病気を見落としてしまうと問題です。
つまり、偽陰性になると問題になるため、再現率が重視されます。
| 場面 | 重視する指標 |
|---|---|
| 医療診断(病気の検出) | 再現率 |
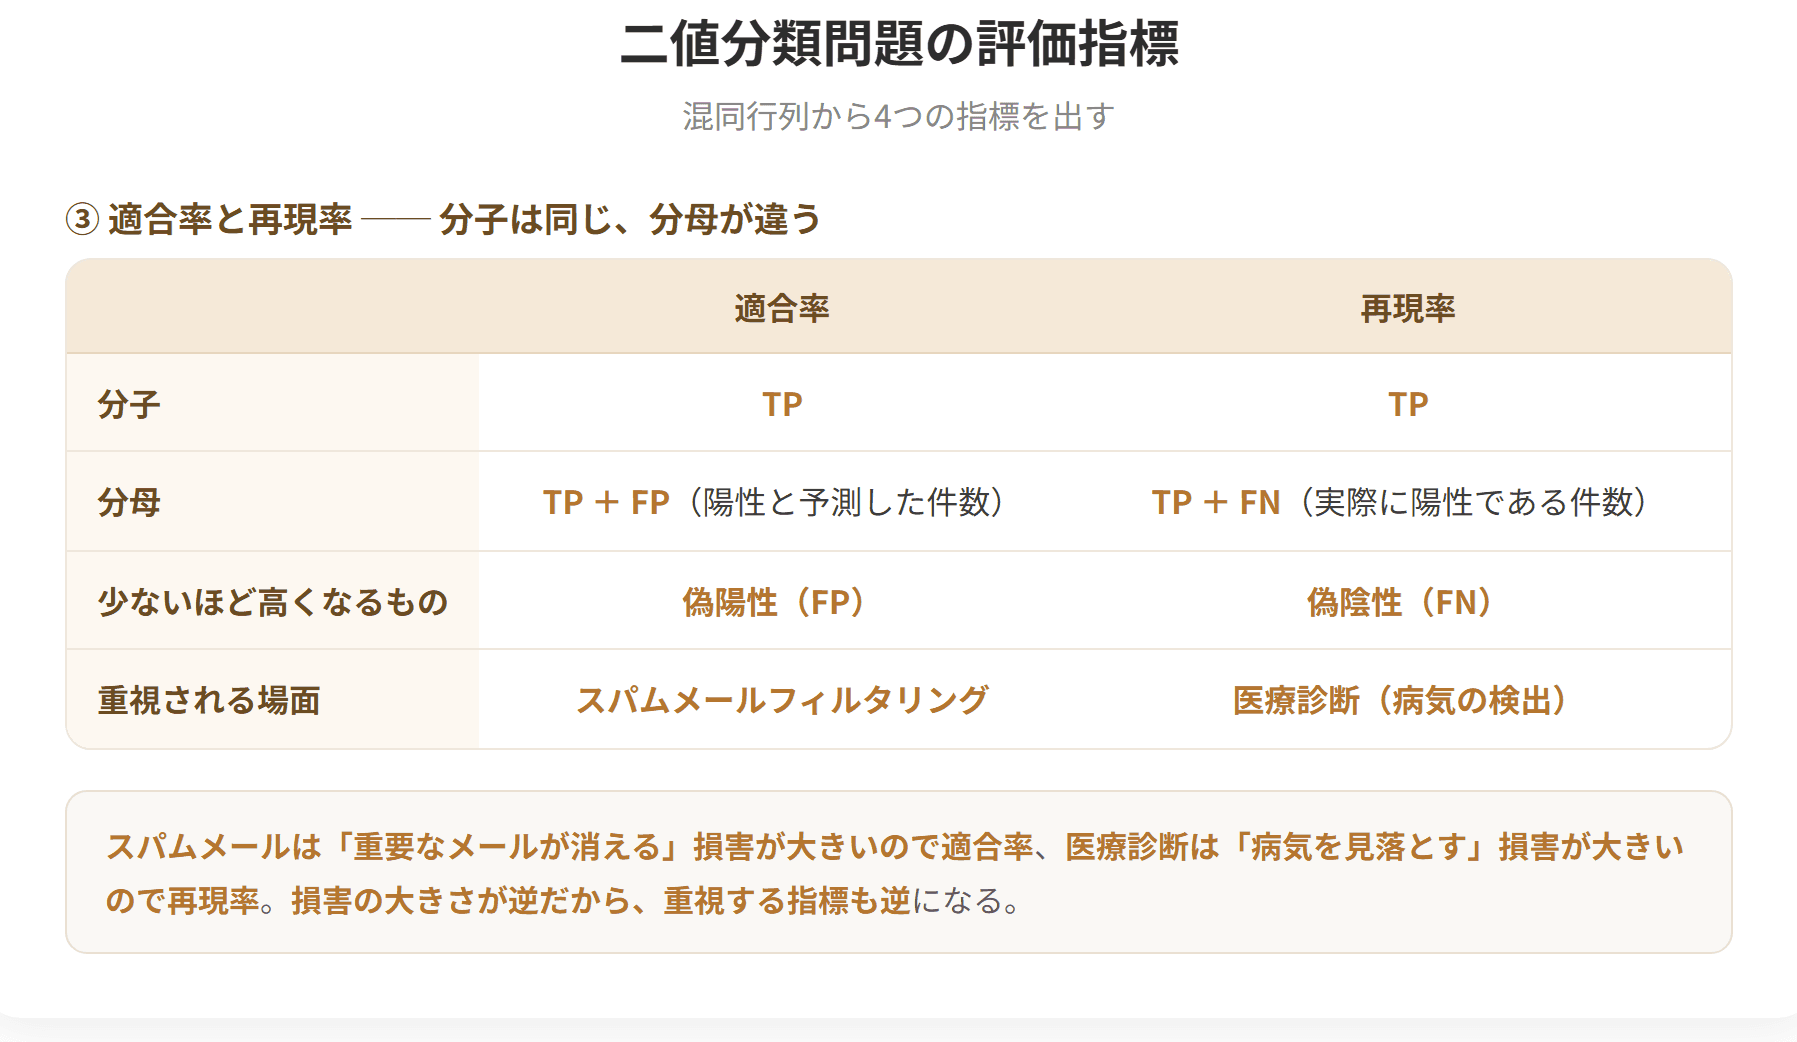
⑪ 適合率と再現率の対比
| 適合率 | 再現率 | |
|---|---|---|
| 分母 | TP + FP(陽性と予測した件数) | TP + FN(実際に陽性である件数) |
| 少ないほど高くなるもの | 偽陽性(FP) | 偽陰性(FN) |
| 重視される場面 | スパムメールフィルタリング | 医療診断 |
分子はどちらもTP——分母が違うだけです。
⑫ F値(F1スコア)
適合率と再現率はトレードオフの関係にあるため、適合率と再現率の調和平均を計算した値です。
適合率と再現率のバランスをとるためにF値という指標もよく用いられます。
⑬ トレードオフの関係
| 判定を厳しくすると | 判定を緩くすると |
|---|---|
| 陽性と判定する件数が減る | 陽性と判定する件数が増える |
| 偽陽性が減る → 適合率が上がる | 偽陰性が減る → 再現率が上がる |
| 偽陰性が増える → 再現率が下がる | 偽陽性が増える → 適合率が下がる |
両立しないため、バランスを取る指標としてF値が使われます。
⑭ 4つの式のまとめ
| 指標 | 式 |
|---|---|
| 正解率 | (TP + TN) ÷ (TP + FP + FN + TN) |
| 適合率 | TP ÷ (TP + FP) |
| 再現率 | TP ÷ (TP + FN) |
| F値 | (2 × 適合率 × 再現率) ÷ (適合率 + 再現率) |
具体例
指標を実際に計算する
状況:不良品の検出モデル。製品1,000個を検査した
混同行列
| 予測:不良(陽性) | 予測:良品(陰性) | ||
|---|---|---|---|
| 実際 | 不良(陽性) | TP=45 | FN=5 |
| 実際 | 良品(陰性) | FP=30 | TN=920 |
正解率
96.5%
適合率
60%
再現率
90%
F値
72%
結果の読み取り
| 指標 | 値 | 意味 |
|---|---|---|
| 正解率 | 96.5% | 全体としては高い |
| 適合率 | 60% | 不良と判定したうち4割は良品 |
| 再現率 | 90% | 実際の不良の9割は検出できている |
「正解率が高いのに、適合率が低い」
| 理由 | 内容 |
|---|---|
| 良品が圧倒的に多い | 950個中920個を正しく良品と判定 |
| 全体の正解率は高くなる | しかし不良の判定精度は別 |
正解率だけを見てはいけない
| 極端な例 | 内容 |
|---|---|
| すべて「良品」と判定するモデル | 正解率95% |
| しかし不良を1つも検出できない | 役に立たない |
不均衡なデータでは正解率は意味を持たない——これが適合率・再現率が必要な理由です。
この検査モデルをどう評価するか
| 観点 | 判断 |
|---|---|
| 不良を見逃したくない | 再現率90%。5個見逃している |
| 良品を不良と判定したくない | 適合率60%。30個を誤って不良とした |
どちらを重視するか
| 状況 | 重視する指標 |
|---|---|
| 不良品が客先に行くと重大 | 再現率(見逃しを減らす) |
| 再検査のコストが高い | 適合率(誤判定を減らす) |
判定の基準を調整する
| 調整 | 結果 |
|---|---|
| 不良と判定する基準を緩くする | 再現率↑、適合率↓ |
| 不良と判定する基準を厳しくする | 適合率↑、再現率↓ |
基準を緩くした場合
| 予測:不良 | 予測:良品 | ||
|---|---|---|---|
| 実際 | 不良 | TP=49 | FN=1 |
| 実際 | 良品 | FP=80 | TN=870 |
| 指標 | 変化 |
|---|---|
| 再現率 | 90% → 98% |
| 適合率 | 60% → 38% |
見逃しは減るが、誤判定が大幅に増える
実務での判断
| 考えること | 内容 |
|---|---|
| 見逃しの損害 | クレーム、回収費用、信用 |
| 誤判定の損害 | 再検査の工数、良品の廃棄 |
| どちらが大きいか | 金額で比較する |
金額で比較する例
| 項目 | 金額 |
|---|---|
| 不良品1個を出荷した場合の損害 | 50,000円 |
| 良品1個を誤って不良とした場合の損失 | 2,000円 |
基準を厳しくした場合(適合率重視)
| 項目 | 件数 | 損害 |
|---|---|---|
| 見逃し(FN) | 12個 | 600,000円 |
| 誤判定(FP) | 10個 | 20,000円 |
| 合計 | — | 620,000円 |
基準を緩くした場合(再現率重視)
| 項目 | 件数 | 損害 |
|---|---|---|
| 見逃し(FN) | 1個 | 50,000円 |
| 誤判定(FP) | 80個 | 160,000円 |
| 合計 | — | 210,000円 |
この場合は再現率を重視するのが合理的
「損害の大きさで基準を決める」——これが実務的な判断です。
スパムメールと医療診断の対比が示すもの
| 場面 | 見逃しの損害 | 誤判定の損害 |
|---|---|---|
| スパムメール | 迷惑メールが届く(小) | 重要なメールが消える(大) |
| 医療診断 | 病気を見落とす(大) | 再検査が必要になる(小) |
損害の大小が逆——だから重視する指標も逆になります。
確認してみましょう
> 次の記述の正誤を判定せよ。(令和6年度第23問、令和5年度第24問 改題)
> a 適合率は、陽性と予測した件数のうち、実際も陽性である割合であり、TP ÷(TP + FP)で求められる。
> b 再現率は、実際に陽性である件数のうち、陽性と予測した割合であり、TP ÷(TP + FN)で求められる。
> c F値は、適合率と再現率の算術平均を計算した値である。
解答 a:○ b:○ c:×
二値分類問題の評価指標(1/3)
二値分類問題の評価指標(2/3)
二値分類問題の評価指標(3/3)
試験のポイント

 科目別の正答率と連続学習日数がマイページに出るので、次にどの科目をやるかで迷いません。プレミアム限定
プレミアムプラン
¥9,800〜/ 買い切り・自動更新なし(税込)
決済はStripe(世界最高水準・PCI-DSS準拠)で安全に処理されます。カード情報は当サービスに保存されません。
