ハードウェア
下の動画はこの節の解説ではありません。 解説動画の雰囲気を知っていただくための見本として、「AI・機械学習」の動画を再生します。
この節の解説動画はプレミアム限定です。プレミアムなら全科目・全節が見放題!
プレミアムで見るCPUはコンピュータの頭脳にあたる部品です。ただし「頭脳」という比喩は、ともすると何でも自分で考えてくれる存在のように聞こえてしまいます。実際のCPUがやっているのは、主記憶装置から命令を1つ取り出し、それが何の命令かを読み解き、指示どおりに計算して、結果を書き戻す——この地味な繰り返しだけです。この節では、まずその繰り返しを制御機能と演算機能という2つの役割に分けて整理します。次に、その繰り返しの速さを測る物差しとしてクロック周波数・CPI・MIPS・FLOPSを取り上げ、計算問題で使えるところまで持っていきます。最後に、繰り返しを少しでも速くするために考え出されたパイプライン制御やマルチコアのしくみを見ていきます。


簡単にいうと
CPUは「考える人」じゃなくて「指示どおりに動く人」!その中身は、段取りをつける制御機能と、実際に計算する演算機能の2人組なの。この2人が主記憶装置とどうやり取りしているかを、まず押さえよう!
① CPUは2つの機能をもつ
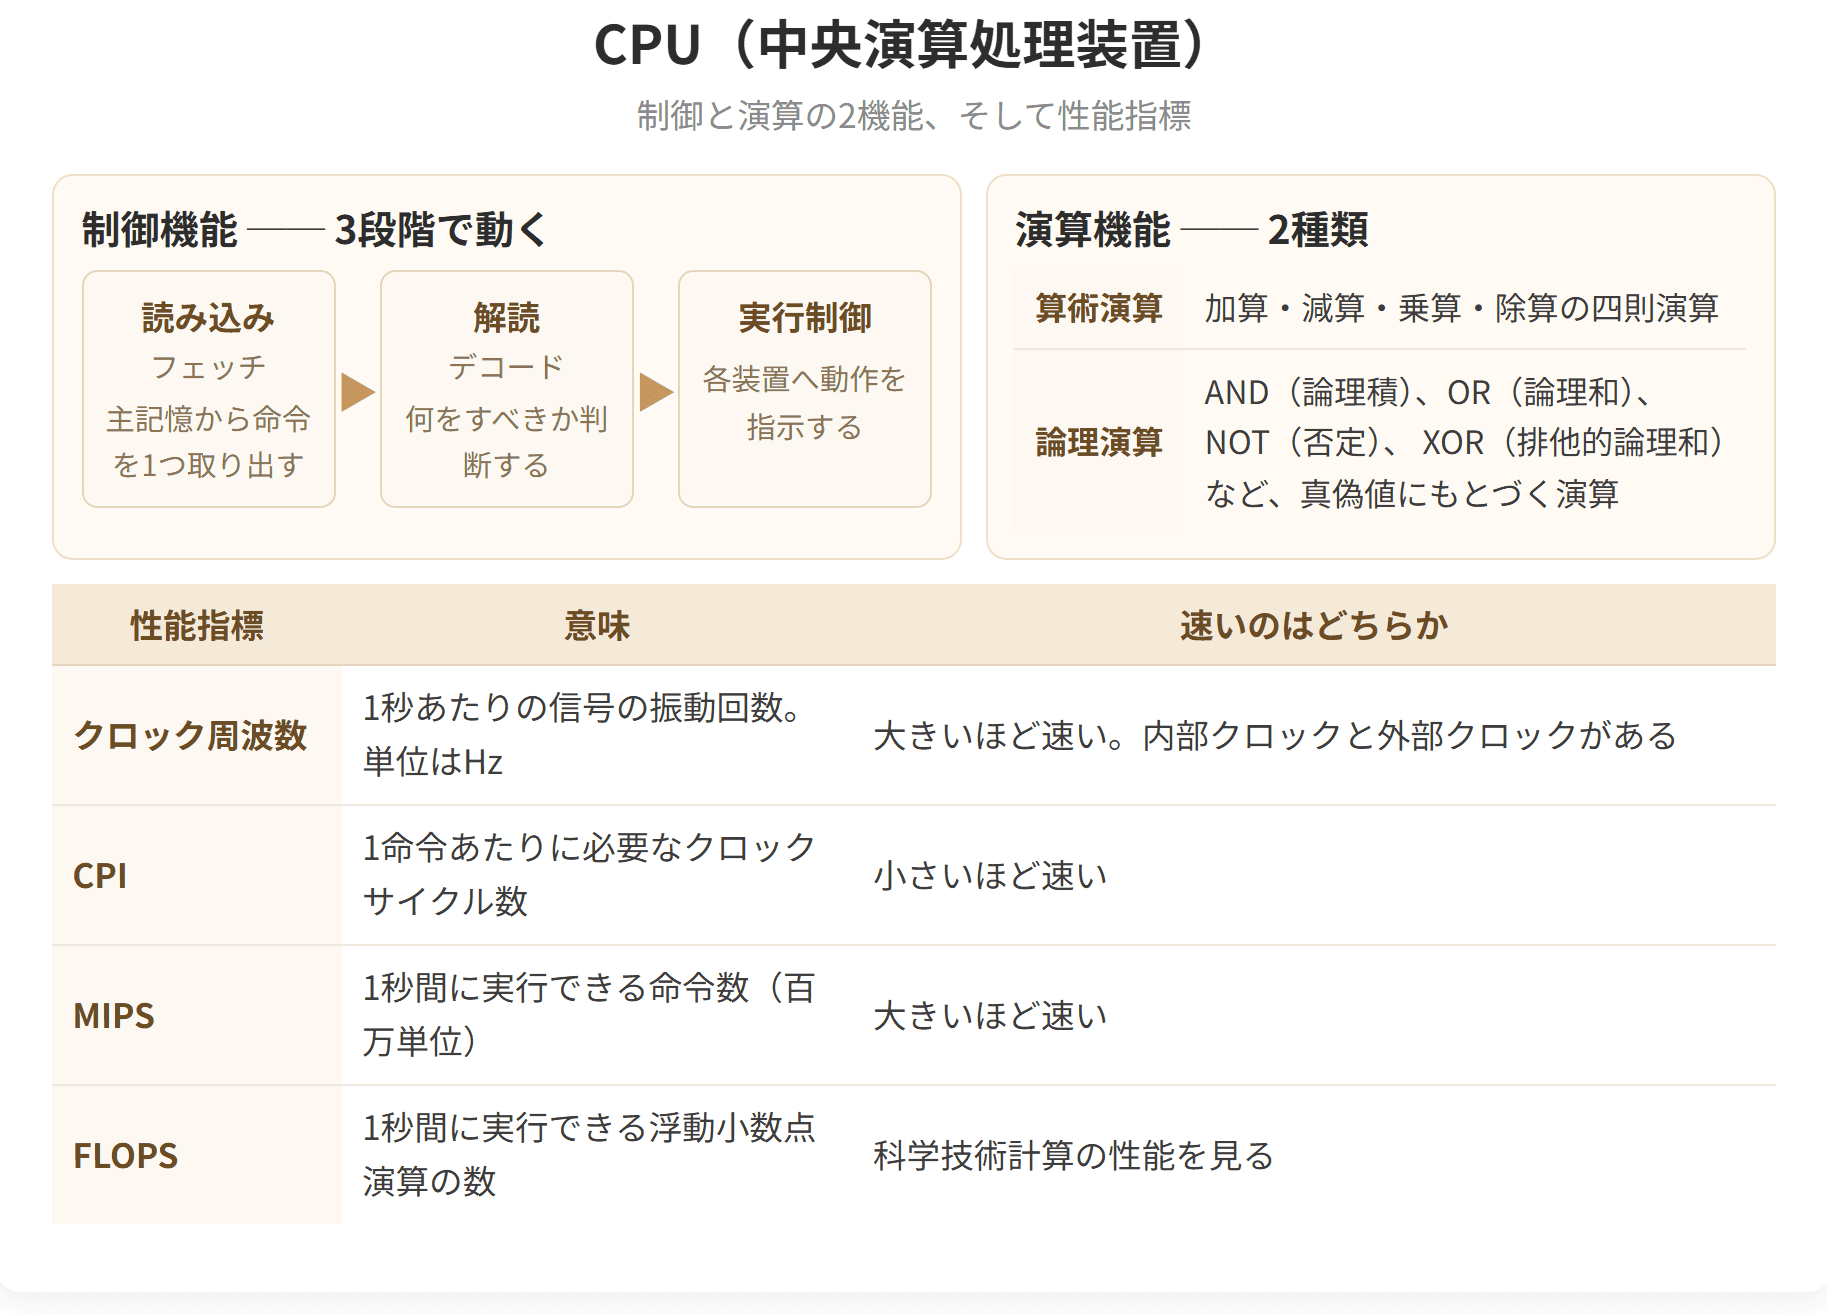
CPU(Central Processing Unit:中央演算処理装置)は、コンピュータの主要構成要素のひとつであり、演算機能と制御機能の2つをもちます。5大装置でいえば演算装置と制御装置がひとまとめになった部品です。
CPUの中には「命令読込」「命令解読(解釈)」などを行う箇所があります。ここでいう命令とは、「足し算や引き算を行え」などコンピュータに対して動作を指示するもので、この命令の集まりがプログラムです。プログラムは補助記憶装置から主記憶装置に読み込まれ、CPUはプログラムの中から命令を読み込み、それを解釈し、実行して結果を格納します。
② 制御機能
制御機能は、主記憶(記憶装置)から命令を取り出し、解読し、実行するとともに、入力装置・出力装置の制御を行う機能です。具体的には次の3段階を延々と繰り返しています。
| 段階 | 英語での呼び名 | やっていること |
|---|---|---|
| 命令の読み込み | フェッチ | 主記憶装置からプログラムの命令を1つ取り出す |
| 命令の解読 | デコード | 取り出した命令が何を指示しているのかを解読する |
具体例
CPUの仕事ぶりを、レジ係の作業に置き換えて確かめてみましょう。
場面……コンビニのレジで、店員が手順書に従って会計を進めています。手順書は「①商品のバーコードを読む ②金額を合計に足す ③次の商品があれば①へ戻る ④なければ合計を表示する」と書かれています。
| コンピュータ | レジの場面 |
|---|---|
| 主記憶装置 | 手元に広げた手順書と、途中まで足した合計のメモ |
| 制御機能 | 手順書の何行目を実行中かを管理し、次に何をするか判断する |
| 演算機能 | 「合計+商品の金額」を計算する |
| 補助記憶装置 | 事務所の棚にしまってある手順書の原本 |
ここで注目したいのは③の分岐です。「次の商品があれば①へ戻る」という判断は、演算機能が行う論理演算の結果を受けて、制御機能が「次に読む手順書の行」を切り替えることで実現されます。計算するのは演算機能、どこへ進むかを決めるのは制御機能——この分担が、プログラムの繰り返し処理や条件分岐を支えています。
確認してみましょう
CPUの2つの機能と性能指標

試験のポイント

簡単にいうと
「このCPU、速いの?」に答えるための物差しが4つあるよ。大事なのは、CPIだけが「小さいほど速い」という逆向きだってこと!MIPSの計算式も出るから、手を動かして覚えよう。
① 4つの物差し
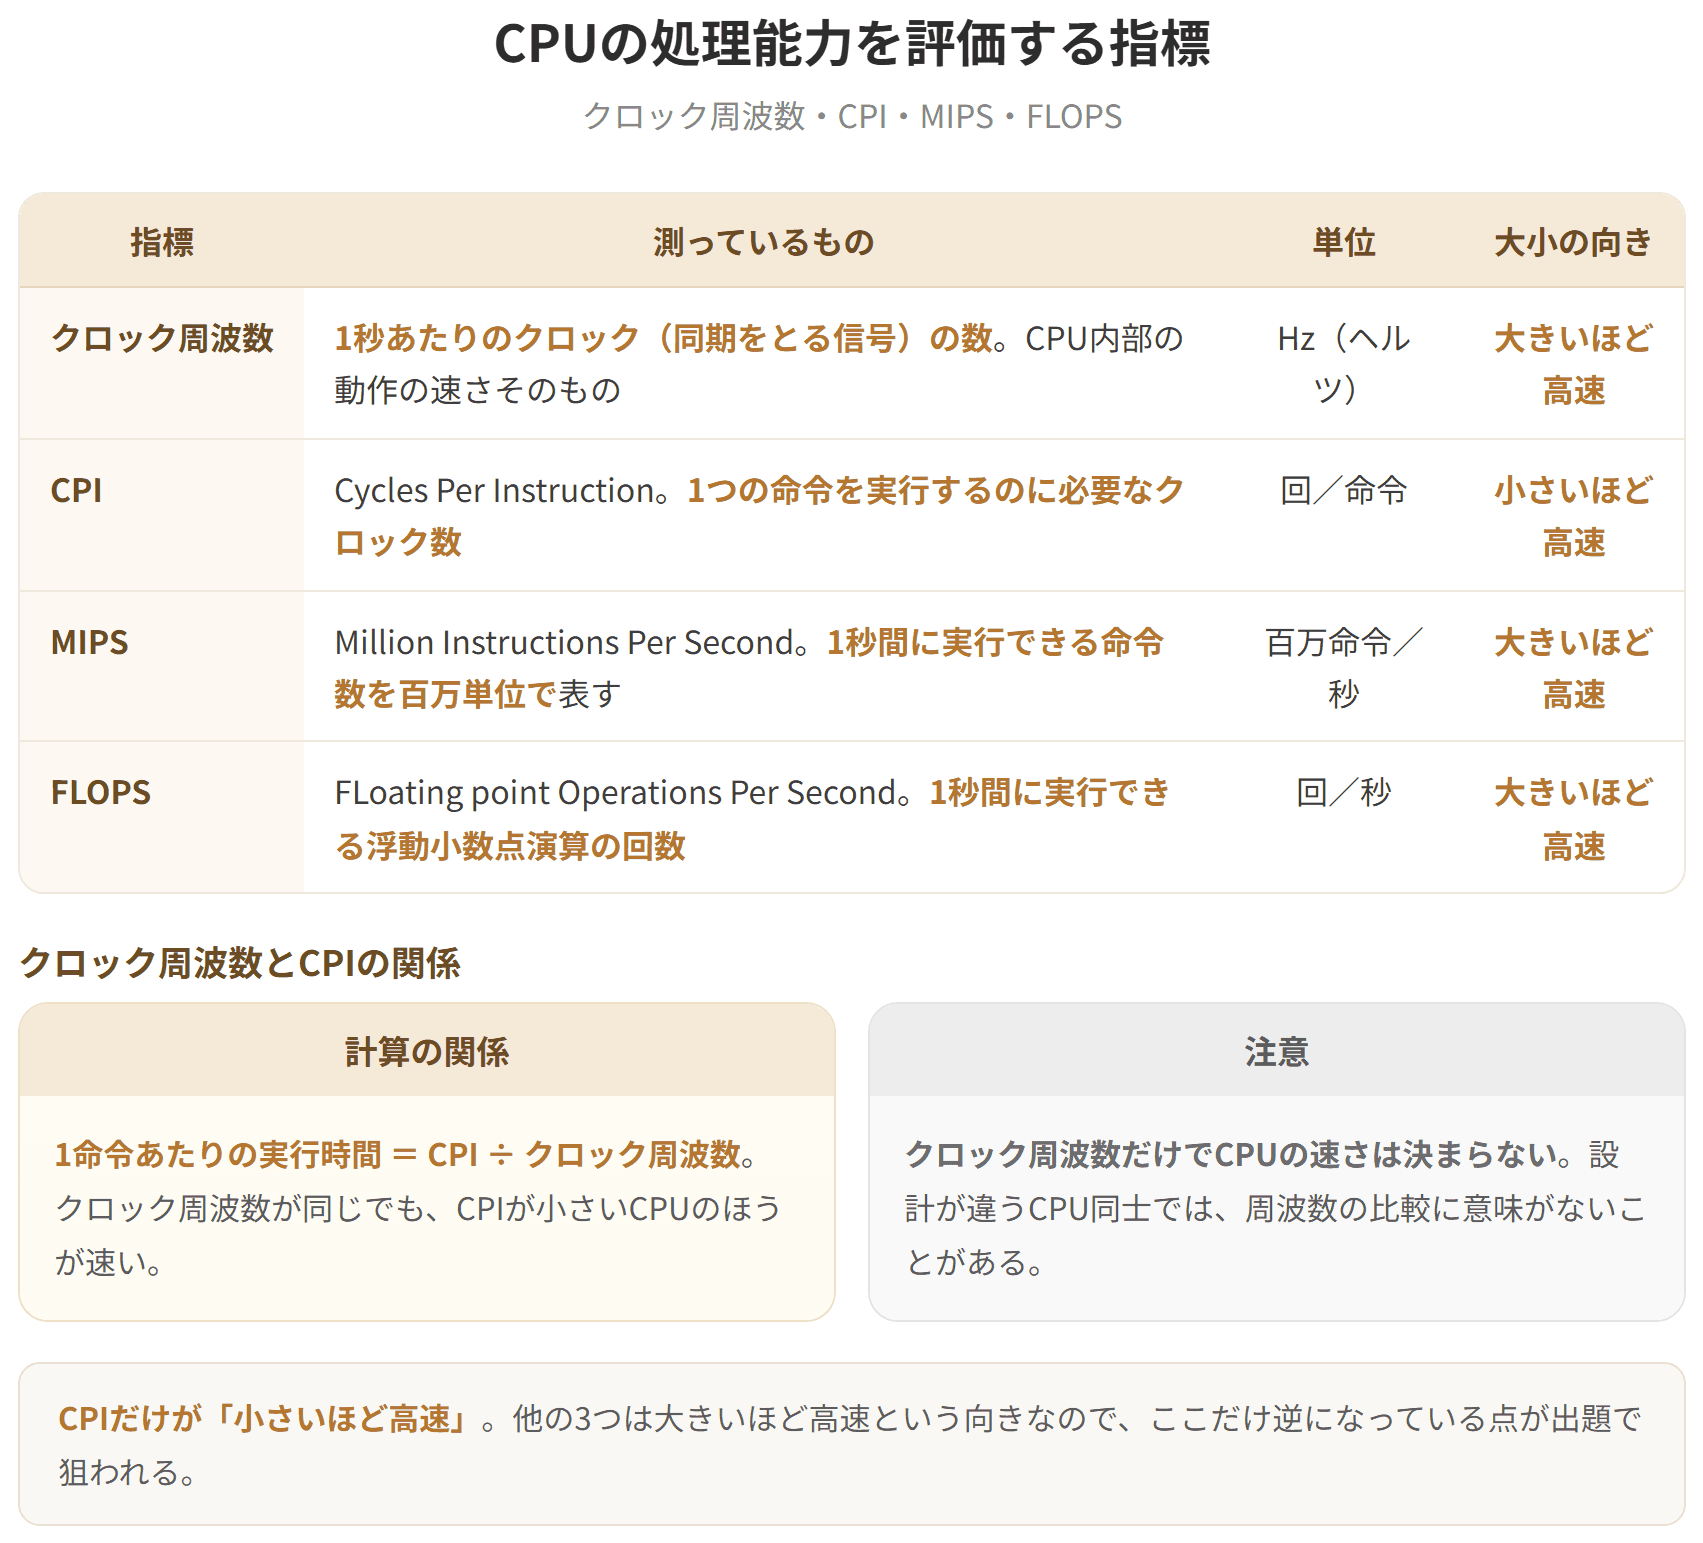
CPUの処理能力を評価する代表的な指標は4つです。まず全体像を押さえます。
| 指標 | 意味 | 単位 | 向き |
|---|---|---|---|
| クロック周波数 | 1秒あたりの信号の振動回数 | Hz |
簡単にいうと
CPUを速くする方法は2つ。1人の作業を流れ作業に変えるか、人数そのものを増やすか!前者がパイプライン、後者がマルチプロセッサとマルチコアだよ。
① パイプライン制御
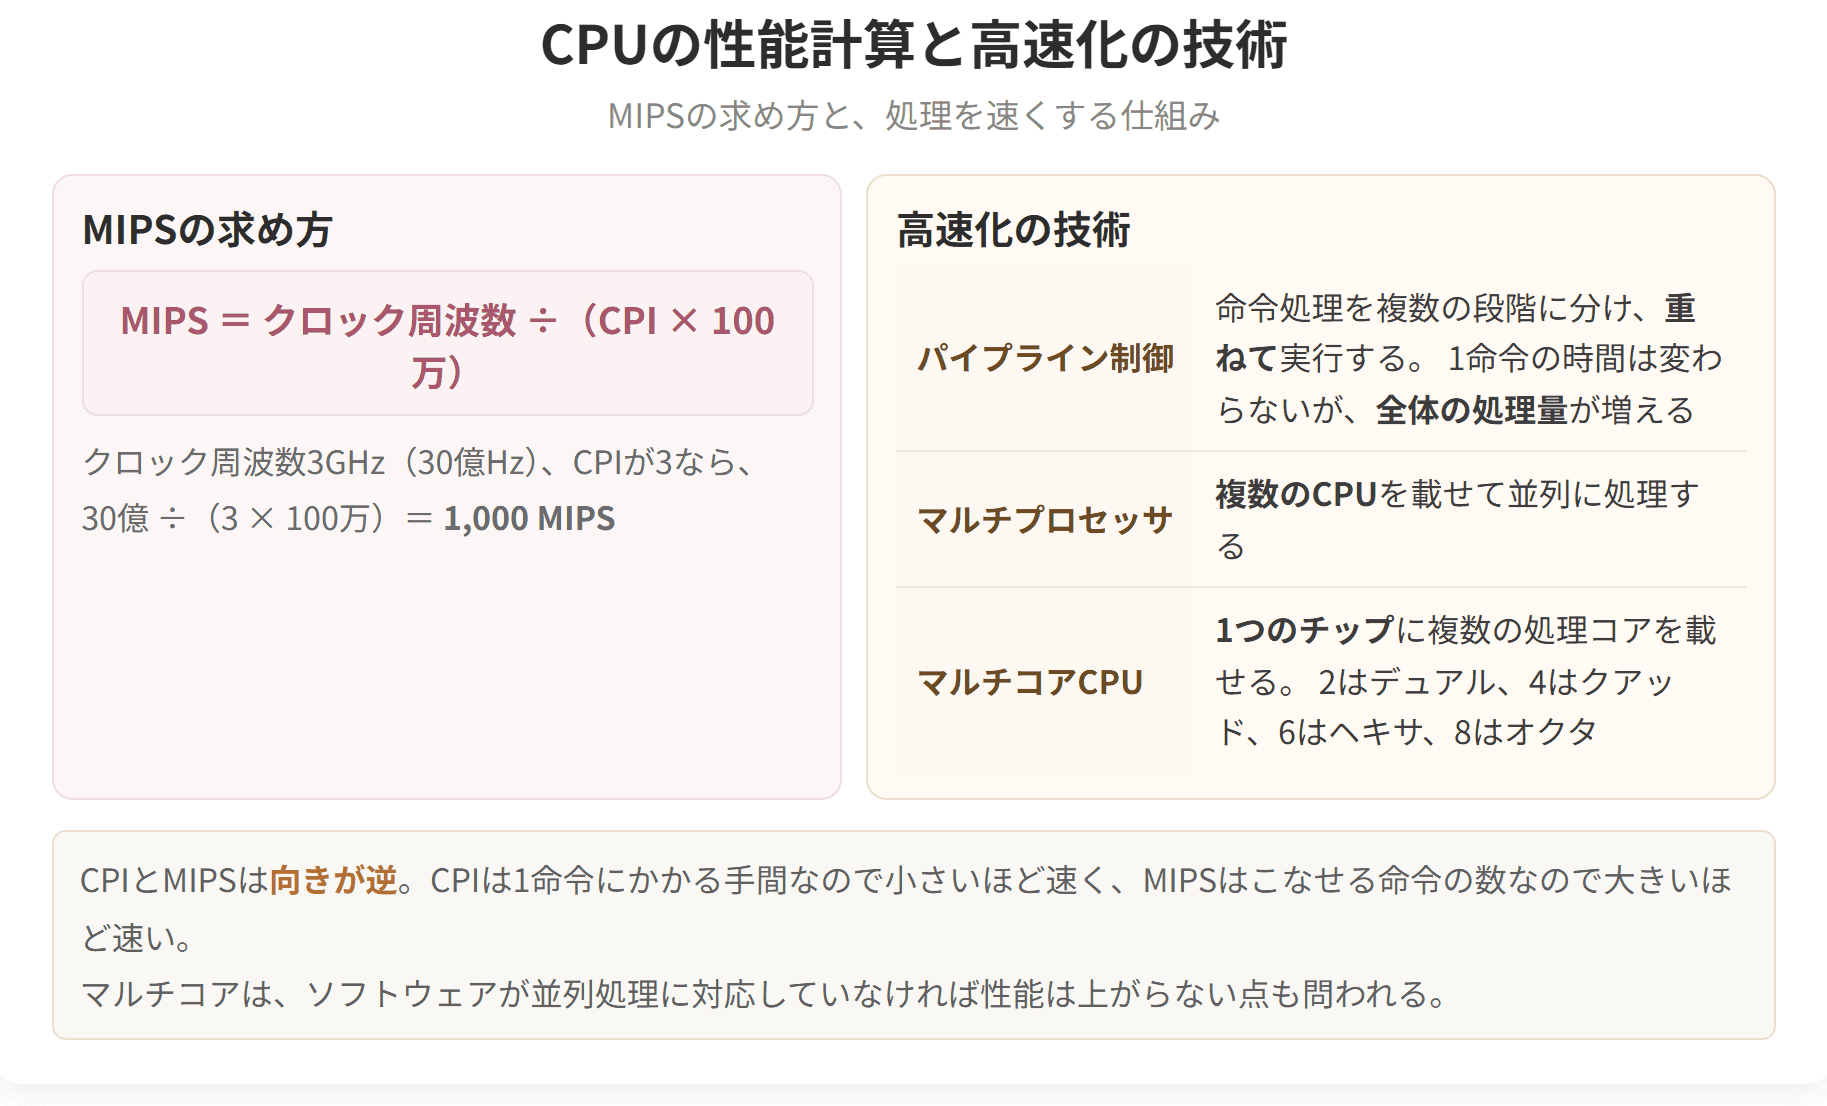
CPUは(1)命令読込、(2)解釈、(3)実行、(4)結果格納、といった手順で作業を行っています。通常は1つの命令についてこの4段階を順に終えてから次の命令に移りますが、これを並行処理することによって高速化を図るのがパイプライン制御です。
工場のベルトコンベア(流れ作業)を思い浮かべてください。1人の職人が最初から最後まで1個ずつ作るのではなく、工程ごとに担当を分ければ、前の工程が空いた瞬間に次の製品を流し込めます。CPUも同じで、命令1が「解釈」に進んだ時点で、「命令読込」の担当は空きます。そこへ命令2を流し込むわけです。
ここで大切なのは、個々の命令の処理時間そのものは変わらないという点です。1つの命令が4段階を終えるのに必要な時間は4クロックのままです。速くなるのはスループット(単位時間あたりの処理量)のほうです。
所要クロック数の求め方

動画・テキスト・過去問・AI添削まですべて網羅!
予備校代の1/10以下で、独学の不安をまるごと解決できます

 全7科目536節の解説動画539本・合計約41時間が見放題。連続再生・ブックマーク再生で、移動中も1本5分前後で進められます。プレミアム限定
 令和3〜7年度の1次過去問1,116問を、科目別・年度別に無制限で演習。問題の図・表と解説つきで、間違えた問題はマイページに残ります。プレミアム限定
 2次は事例I〜IVの114設問に何度でも書いて出せます。AIが設問ごとの基準で採点し、改善点は「どう書き直すか」の例と模範解答つき。プレミアム限定
 科目別のテキストPDFをダウンロードできます。印刷して書き込む、タブレットで持ち歩くなど、好きな使い方で。プレミアム限定
| 実行制御 | — | 演算装置や各装置に対して具体的な動作を指示する |
この繰り返しを命令サイクルといいます。人間が料理をするときに、レシピを1行読み(フェッチ)、何をするのか理解し(デコード)、手を動かす(実行)のを繰り返すのと同じ構造です。
③ 演算機能
演算機能は、データの算術演算や論理演算を行う機能です。
論理演算は、たとえば「会員であり、かつ、購入金額が1万円以上」という絞り込みをコンピュータが処理するときの土台になります。データベースのWHERE句でANDやORを使う場面が、そのまま演算機能の出番です。
④ 主記憶装置とのやり取り
CPUと主記憶装置の間では、3種類のやり取りが行われます。
| 向き | 内容 |
|---|---|
| 主記憶装置 → CPU | プログラム(命令)を読み込み、解読する |
| 主記憶装置 → CPU | 処理に使うデータを読み込む |
| CPU → 主記憶装置 | 実行結果を格納する |
CPUが直接やり取りできるのは主記憶装置だけです。補助記憶装置にあるプログラムやデータは、必ずいったん主記憶装置に読み込まれてから処理されます。この一本道が、のちに学ぶキャッシュメモリや仮想記憶の話の前提になります。
> a CPUは、算術演算と論理演算を行う演算機能と、命令の解読や各装置の制御を行う制御機能をもつ。
> b CPUは補助記憶装置に記録されたプログラムを直接読み込んで実行する。
> c 命令の解読はデコード、命令の取り出しはフェッチとよばれる。
解答 a:○ b:× c:○
| CPI | 1命令の実行に必要な平均クロック周期数 | 回 | 小さいほど高速 |
| MIPS | 1秒間に実行できる命令数(百万単位) | MIPS | 大きいほど高速 |
| FLOPS | 1秒間に実行できる浮動小数点演算の数 | FLOPS | 大きいほど高速 |
CPIだけが「小さいほど速い」という点が、いちばん狙われるところです。4つのうち3つは「大きいほど速い」ので、うっかりCPIも同じ向きだと思い込むと、比較問題で真逆の答えを選んでしまいます。
② クロック周波数
CPUは、水晶など安定した基準パルス発生器が発生するクロックパルスに合わせて作動しています。この周波数をクロック周波数(内部クロック周波数)とよび、単位は[Hz]で表されます。クロック周波数はCPUが作動する基本のリズムのようなもので、値が大きいほど高速になります。
一方、CPUと主記憶装置などを結ぶ伝送路(バス)の動作周波数を外部クロック周波数といいます。こちらも値が大きいほどデータの転送速度が高速になります。内部と外部の2つがある、という点を押さえてください。メトロノームのテンポが内部クロック、CPUと部屋の外をつなぐ廊下の混み具合が外部クロック、というイメージです。
③ CPI(Cycles Per Instruction)
CPIは、1命令を実行する際に必要となる平均のクロック周期数を表したものです。値が小さいほど演算処理速度が速くなります。
ここでいうクロック周期とは、1クロックあたりの時間を意味します。クロック周波数とクロック周期は逆数の関係にあり、
となります。たとえばクロック周波数が2GHz( Hz)なら、クロック周期は
④ MIPS(Million Instructions Per Second)
MIPSは、1秒間に実行できる命令(Instruction)数を百万単位で表したものです。1MIPSは「1秒間に100万命令実行できる」性能を意味します。
クロック周波数とCPIが与えられれば、MIPSは次の式で求められます。
分母に があるのは、単位を「百万命令」にそろえるためです。式を丸暗記するよりも、「1秒間に何クロック進むか(=クロック周波数)を、1命令に何クロックかかるか(=CPI)で割れば、1秒間の命令数が出る」と意味で覚えるほうが、応用が利きます。
⑤ FLOPS(FLoating point Operations Per Second)
FLOPSは、1秒間に実行できる浮動小数点演算の数を表したものです。浮動小数点演算は、主に科学技術計算で用いられます。たとえば1GFLOPSは「1秒間に10億回の浮動小数点演算が実行できる」性能ということを表します。
MIPSが命令の本数を数えるのに対し、FLOPSは小数の計算の回数を数えます。気象予測や構造解析のように小数計算が大量に出てくる分野では、命令の本数よりも小数計算の回数のほうが実態に近いため、FLOPSが使われます。スーパーコンピュータの性能がペタFLOPSやエクサFLOPSで語られるのは、この理由によります。
具体例
設例1 MIPSを求める
> クロック周波数3GHz、CPI=3 のCPUがある。このCPUのMIPS値を求めよ。
解答 1,000 MIPS
3GHzということは、1秒間に30億回のクロックが刻まれます。1命令に3クロック必要なので、1秒間に実行できる命令数は 命令。百万単位に直すと1,000MIPS、という順番で考えても同じ答えにたどり着きます。
設例2 処理時間を求める
> 1命令の平均実行時間が 秒のCPUで、500万命令からなるプログラムを実行するのに必要な時間を求めよ。
解答 0.1秒
このタイプは、MIPSに直してから解くこともできます。1命令に 秒ということは、1秒間に
設例3 どちらが速いか
> CPU甲はクロック周波数2GHz・CPI=2、CPU乙はクロック周波数3GHz・CPI=4である。どちらの処理能力が高いか。
解答 CPU甲
クロック周波数だけを見れば乙のほうが大きいので、乙が速いと早合点しがちです。しかしCPIは小さいほど速いので、CPIが2倍になっている乙は不利になります。クロック周波数とCPIはセットで見る、という姿勢がこの設例の教訓です。
CPUの処理能力を評価する指標
試験のポイント
となります。最初の1命令が クロックかけてパイプラインを通り抜け、そのあとは1クロックごとに1命令ずつ完成していく、という構造から導かれる式です。命令数 が大きくなるほど、パイプラインの効果は大きくなります。
なお、条件分岐が起きて「次に読み込むはずだった命令」が無駄になると、パイプラインの中身を捨てて詰め直すことになります。これをパイプラインハザードといい、分岐の多いプログラムでは期待したほど速くならない原因になります。
② マルチプロセッサ
マルチプロセッサは、複数の処理装置(CPU)で、主記憶装置と補助記憶装置を共有することにより並列処理を可能にしたシステム構成です。1台のコンピュータにCPUを2つ以上載せる構成で、サーバやワークステーションで採用されることが多く、負荷を分散させることで全体の処理能力を高めます。
CPUが2つあるものをデュアルプロセッサとよびます。マザーボード上にCPUソケットが2つあり、それぞれに物理的なCPUを載せる形です。
③ マルチコアCPU
マルチコアCPUは、1つのCPUに2つ以上のコアプロセッサ(中枢機構)を集積したCPUです。
1台のコンピュータに2つ以上のCPUを搭載するマルチプロセッサ構成とほぼ同じ性能になります。ただし作りは違います。マルチプロセッサはマザーボード上に2つのCPUを載せるのに対し、デュアルコアCPUはCPU内に2つのコアを搭載し、2次キャッシュを共有する場合もあります。
CPU製造者(米インテル社など)は、かつてはクロック周波数の高速化により処理能力の向上を目指していましたが、近年はコアプロセッサ数を増やすことにより処理能力の向上を図っています。周波数を上げると発熱と消費電力が急増して頭打ちになるため、方向転換したわけです。
④ コア数による呼び名
コア数に応じて次のようによばれます。接頭語はギリシャ語・ラテン語の数詞に由来しています。
| コア数 | 名称 | 接頭語の意味 |
|---|---|---|
| 2 | デュアルコアCPU | デュアル(Dual)=2 |
| 4 | クアッドコアCPU | クアッド(Quad)=4 |
| 6 | ヘキサコアCPU | ヘキサ(Hexa)=6 |
| 8 | オクタコアCPU | オクタ(Octa)=8 |
| 10 | デカコアCPU | デカ(Deca)=10 |
| 12 | ドデカコアCPU | ドデカ(Dodeca)=12 |
コア数が多いほど同時に処理できるタスクが増えますが、ソフトウェアが並列処理に対応していなければ性能向上にはつながりません。1人でしかできない作業に10人を割り当てても、9人は手持ち無沙汰になるのと同じことです。「コアを増やせば必ず速くなる」と書かれた選択肢は誤りです。
具体例
設例 パイプライン制御の効果
> 1つの命令を処理するのに4ステージ(各ステージ1クロック)かかるCPUがある。3つの命令を処理するのに必要なクロック数を、パイプライン制御を使わない場合と使う場合それぞれについて求めよ。
解答 使わない場合:12クロック/使う場合:6クロック
パイプラインを使わない場合
1命令あたり4クロックを、3命令ぶん順番に繰り返します。
(クロック)
パイプライン制御を使う場合
各ステージが重複して実行されるため、次のように進みます。
| 1 | 2 | 3 | 4 | 5 | 6 | |
|---|---|---|---|---|---|---|
| 命令1 | (1) | (2) | (3) | (4) | ||
| 命令2 | (1) | (2) | (3) | (4) | ||
| 命令3 | (1) | (2) | (3) | (4) |
3つの命令が6クロックで完了します。公式で確かめると、、 なので
CPUの性能計算と高速化の技術
試験のポイント

 科目別の正答率と連続学習日数がマイページに出るので、次にどの科目をやるかで迷いません。プレミアム限定
プレミアムプラン
¥9,800〜/ 買い切り・自動更新なし(税込)
決済はStripe(世界最高水準・PCI-DSS準拠)で安全に処理されます。カード情報は当サービスに保存されません。
12クロック→6クロックと、処理時間が半分になりました。
命令数が増えるとどうなるか
同じ4ステージのパイプラインで100命令を処理すると、 クロックです。パイプラインを使わなければ クロックですから、約4分の1、つまりステージ数に近い倍率まで効果が伸びています。命令数が多いほどステージ数ぶんの高速化に近づく、というのがパイプラインの性質です。
注意しておきたいこと
命令1が完了するのは、パイプラインを使っても使わなくても4クロック目です。1つの命令が速く終わるわけではないという点は、試験でも「個々の命令の処理時間が短縮される」という誤りの選択肢として登場します。速くなるのは全体のスループットです。
