データベース
下の動画はこの節の解説ではありません。 解説動画の雰囲気を知っていただくための見本として、「AI・機械学習」の動画を再生します。
この節の解説動画はプレミアム限定です。プレミアムなら全科目・全節が見放題!
プレミアムで見るデータベースに蓄積されたデータを分析し、経営の意思決定に有益な情報を生み出す取組みが進んでいます。かつてのデータ分析は、社内の整った数値を集計することが中心でした。ところが情報システムや情報機器から取得できるデータの種類と量が大幅に増えたことで、文章や画像、センサーの記録までを分析の対象にする動きが広がりました。この節では、BIとビッグデータという2つの概念から出発し、データをためる技術、多次元で切り取る技術、そして使える形に整える技術を順に押さえます。用語の数は多いのですが、「データがどこからどこへ流れ、どの段階で何をされるのか」という1本の道筋に並べると、すっきり整理できます。


簡単にいうと
昔のデータ分析はBI、いまはビッグデータ。何が変わったかというと、扱えるデータの「種類」と「量」なんだ。この違いが分かると、あとの用語もつながって見えてくるよ!
① 2つの概念の関係
データ分析の代表的な概念について整理します。
> 従来のデータ分析はBIと位置づけられていましたが、情報システムや情報機器から取得され、取り扱うことが可能なデータの種類と量が大幅に増加するにつれ、ビッグデータという概念が登場しました。
つまり、BIが先にあり、その延長線上にビッグデータがあるという関係です。両者は対立するものではなく、対象とするデータの幅が広がった、と捉えてください。
② BI(Business Intelligence)
BIとは、ビジネス上における企業内外の事実に基づくデータを組織的かつ系統的に蓄積、分類、検索、分析、加工して、各種の意思決定に有用な知識を生み出す概念や仕組みです。
これらを実現するためのソフトウェアをBIツールとよびます。
定義文の中に動詞が5つ並んでいることに注目してください。
| 動詞 | 何をするか |
|---|---|
| 蓄積 | データをためる |
| 分類 | 整理する |
具体例
BIとビッグデータの違いを、具体例で確かめる
ある小売チェーンが「売上が伸び悩んでいる」という課題を抱えているとします。
BIで分かること
| 分析 | 使うデータ | 分かること |
|---|---|---|
| 店舗別の売上比較 | POSデータ | どの店が不調か |
| 商品カテゴリ別の推移 | POSデータ | どの商品群が落ちているか |
| 時間帯別の客数 | POSデータ | いつ客が少ないか |
| 前年同月比 | POSデータ |
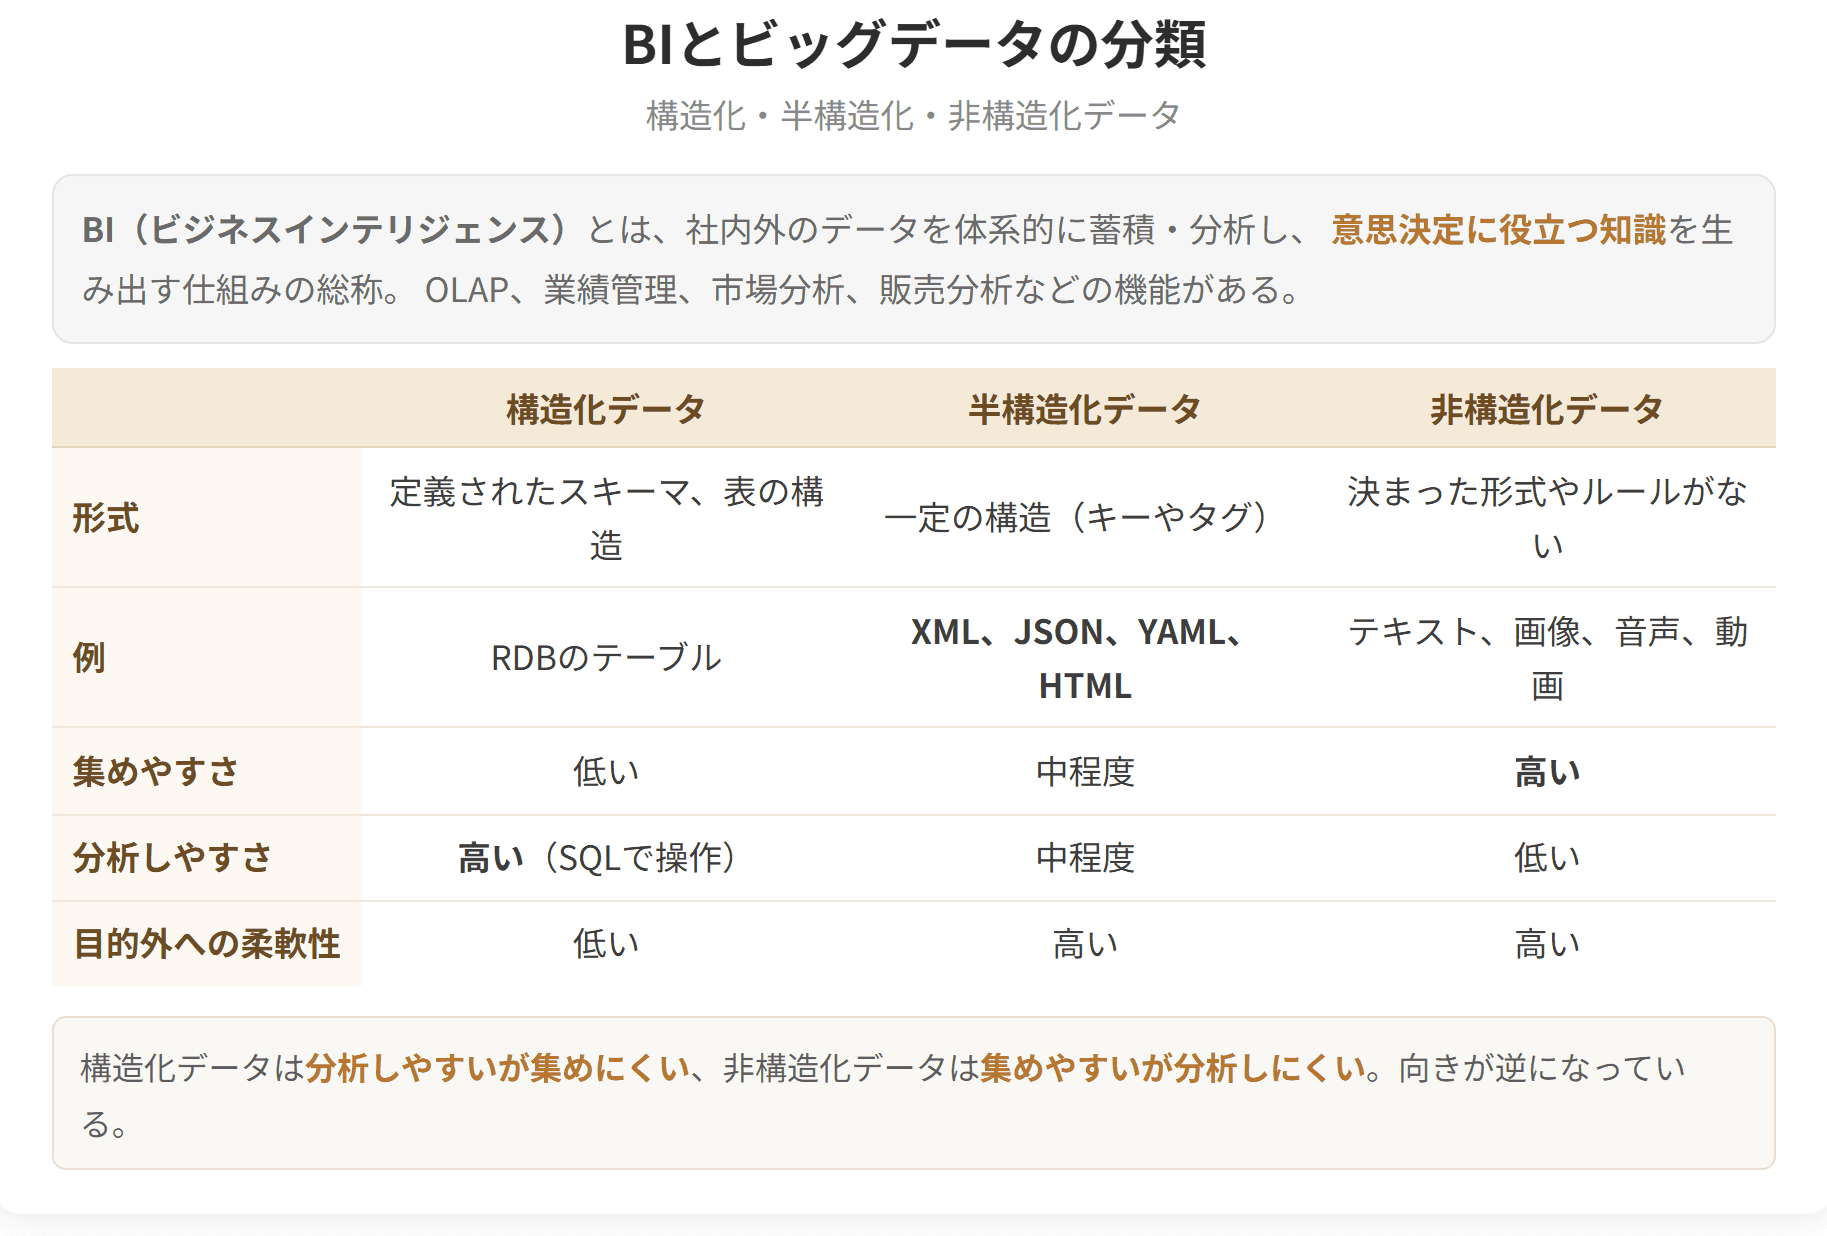
BIとビッグデータの分類

試験のポイント

簡単にいうと
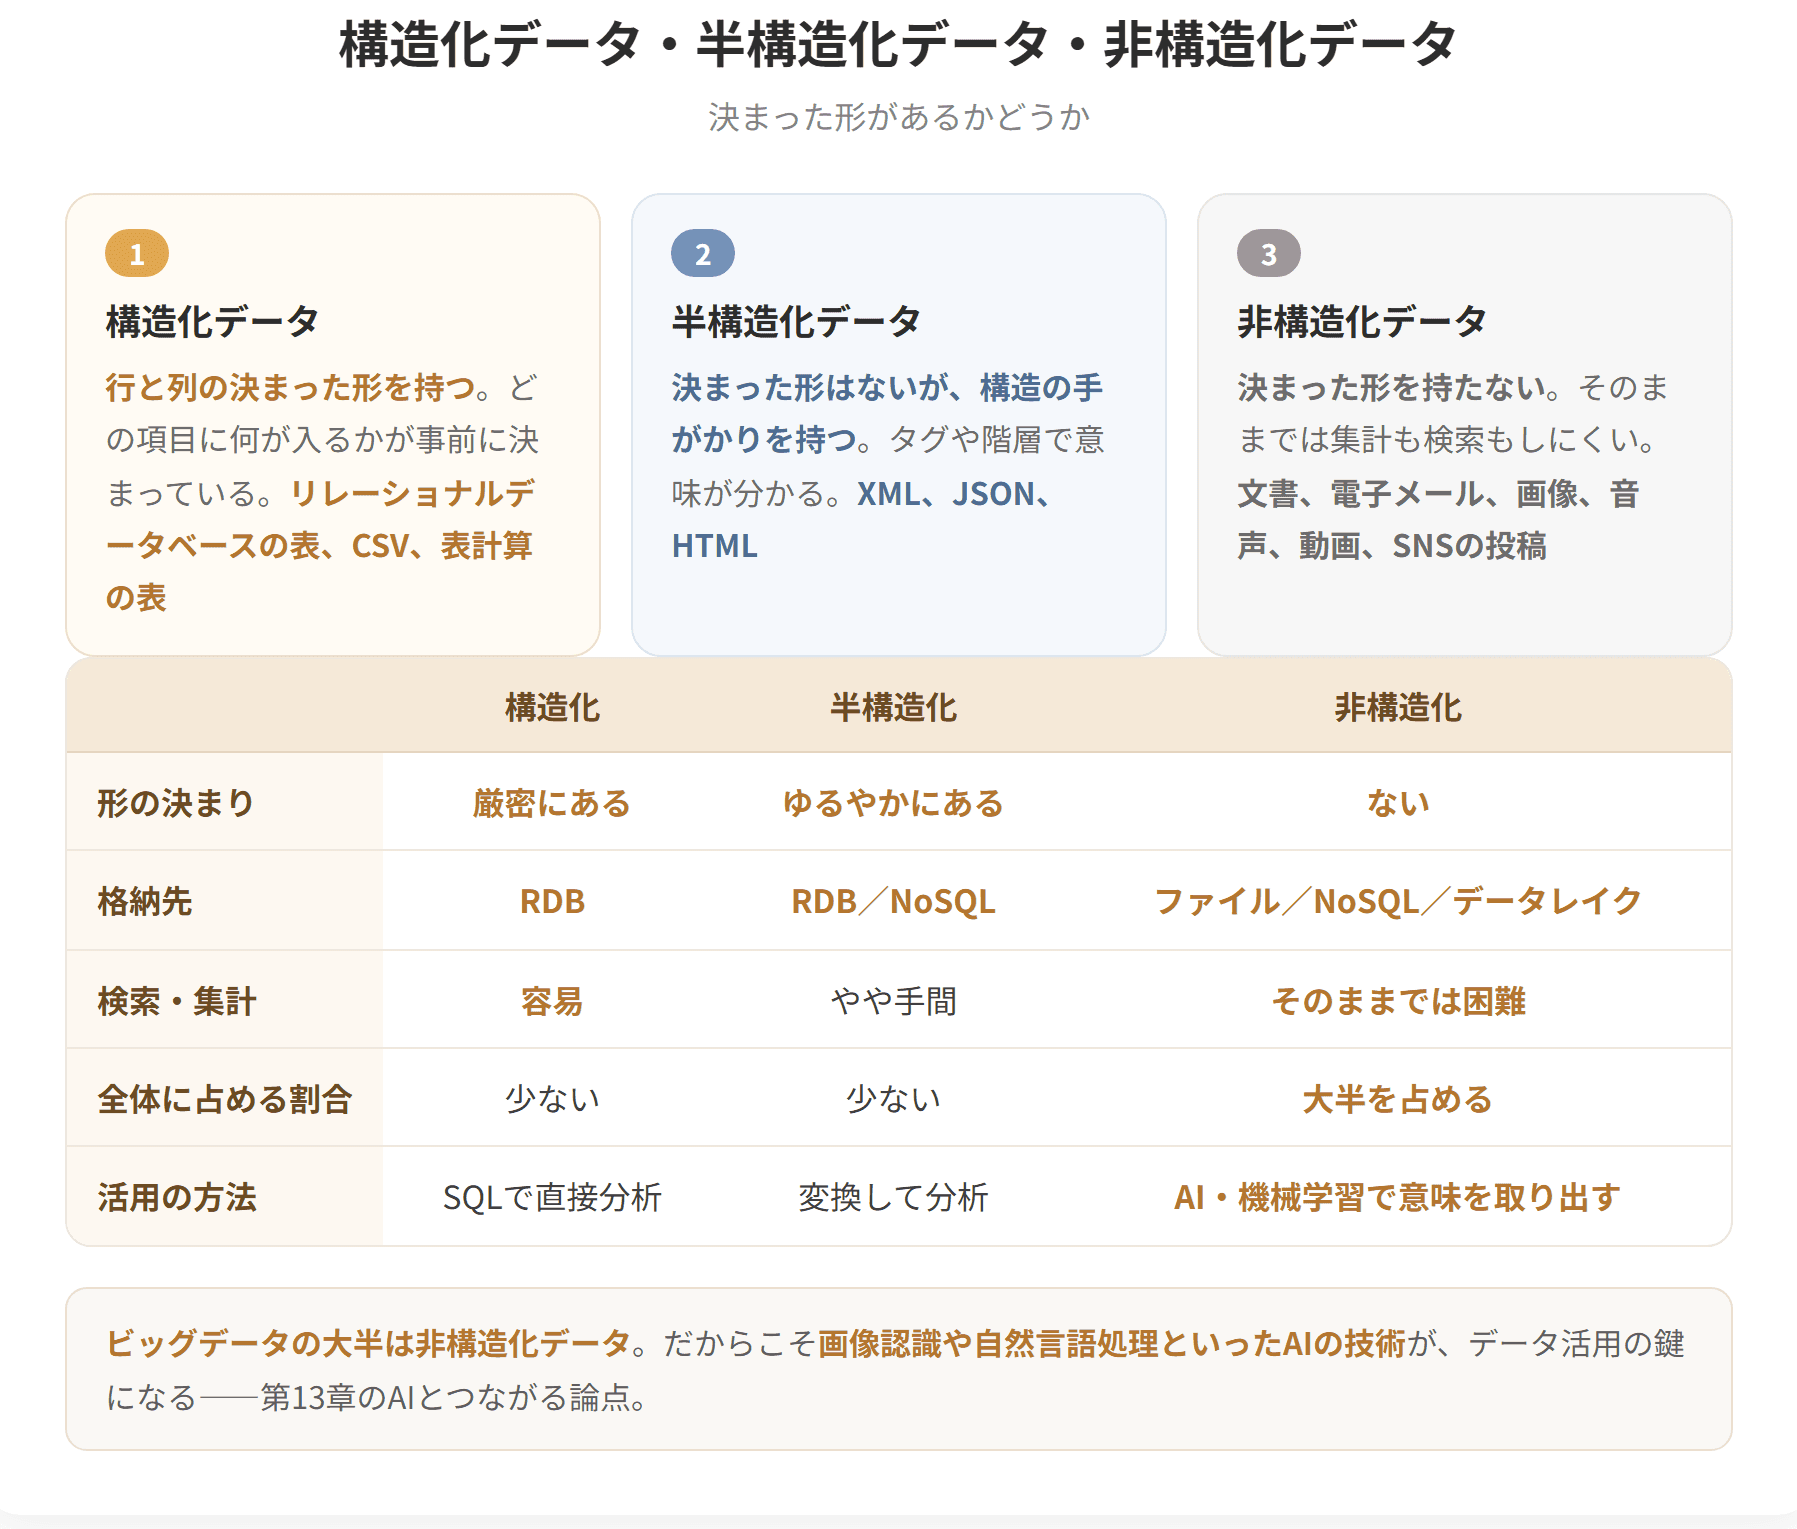
データは「型が決まっているか」で3種類に分かれるの。集めやすいものほど分析しにくい——このトレードオフが表の読みどころだよ!
① 3つの分類
構造化データ
明確なスキーマや構造に従って整理されたデータです。代表的なこのタイプのデータは、リレーショナルデータベースに格納された、たとえば顧客名、住所、電話番号などの情報が整理されたテーブルです。
構造化データは、SQLなどで容易に操作や分析が可能です。
半構造化データ
あらかじめスキーマを定義せず、データにキーやタグなどを付加することで、データ構造を柔軟に定義できるデータです。構造化データと非構造化データの中間に位置します。
JSONやXML、YAMLなどのフォーマットで保存されることが多く、階層的な構造をもてます。半構造化データは、柔軟性がありながらも、一定の構造に基づいてデータを解析できます。
簡単にいうと
データをためる箱にもいろいろある!整えてから入れるのがデータウェアハウス、そのまま入れるのがデータレイク。そして散らかって使えなくなったのがデータスワンプ……名前が皮肉だよね。
① データウェアハウス(DWH:Data WareHouse)
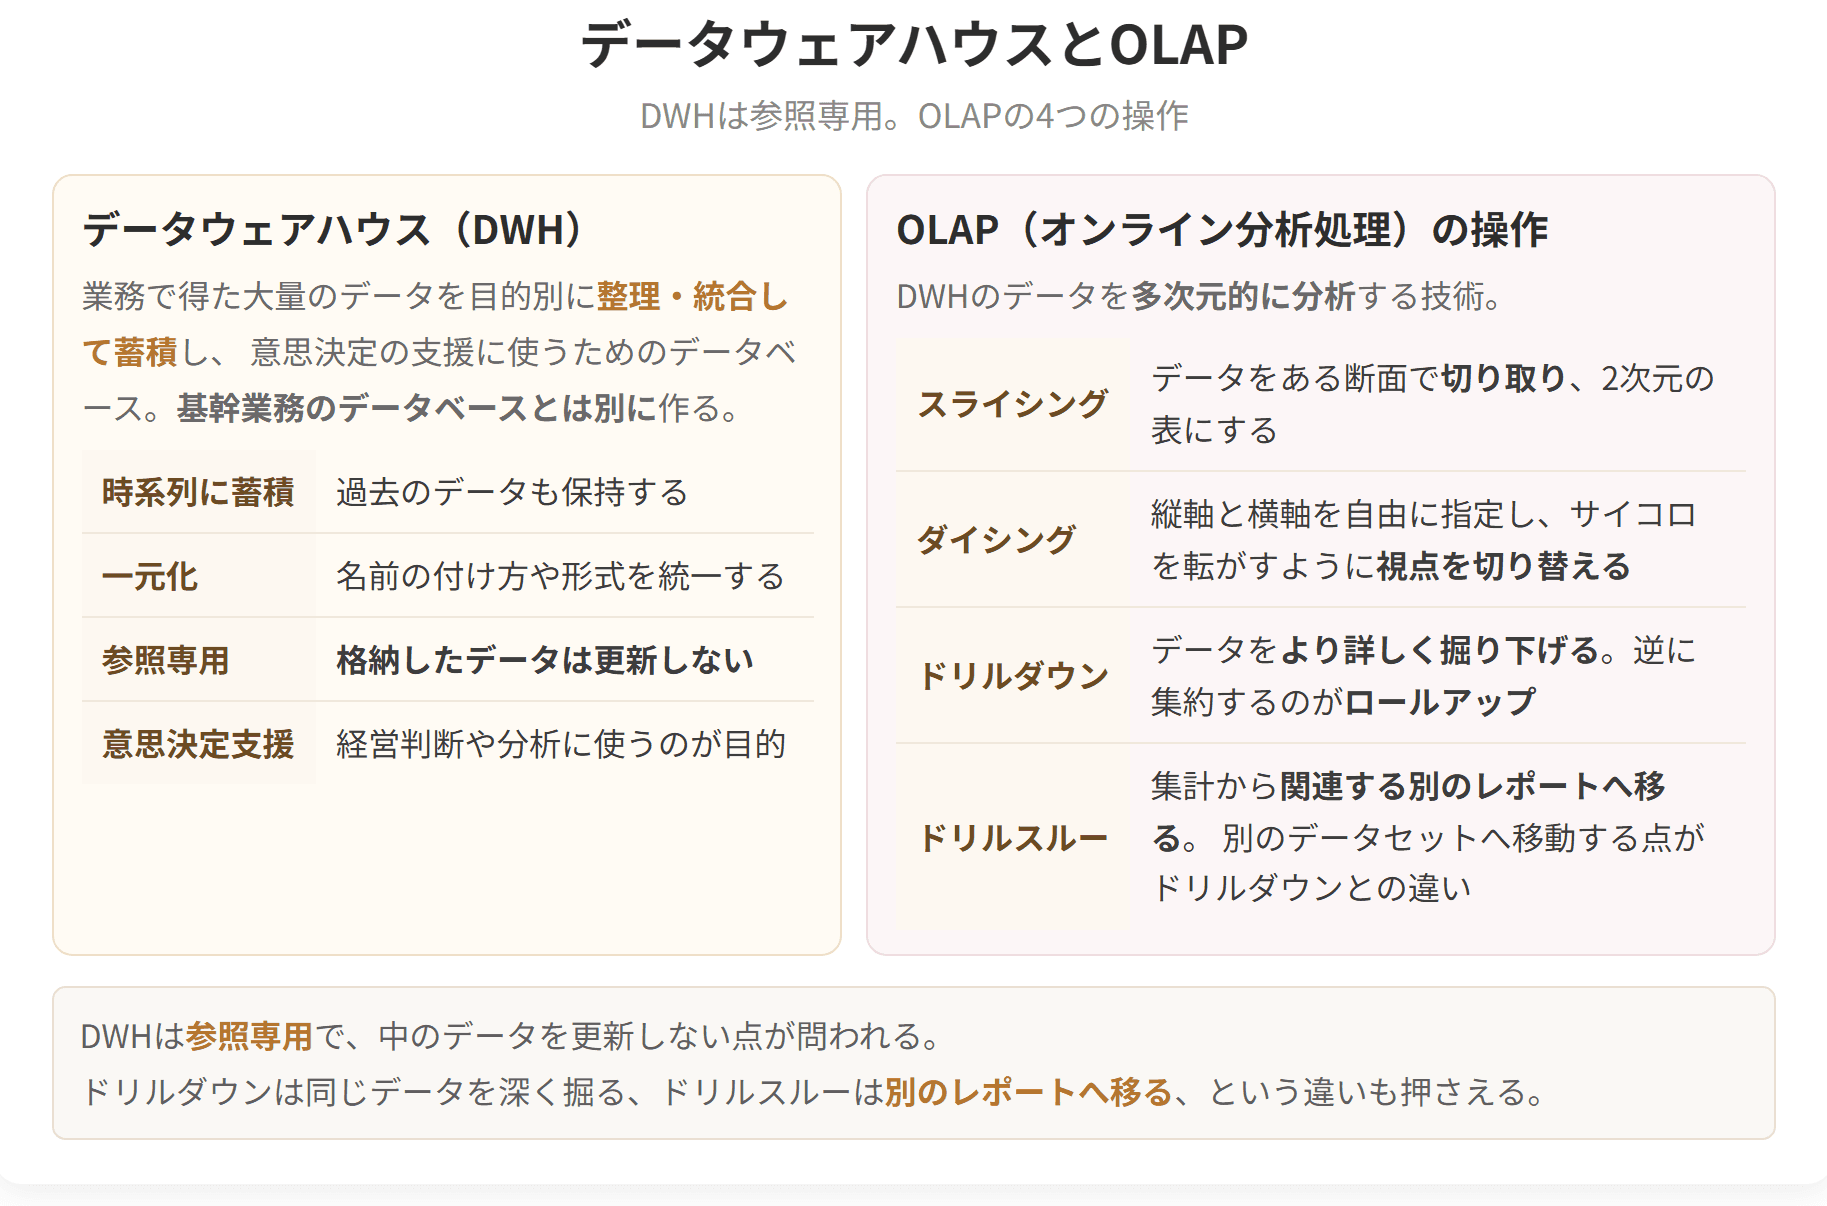
データウェアハウスは、社内のあちこちの活動からたまった大量のデータを、目的ごとに整理してひとつにまとめて置いておく器のことです。日々の業務を回す基幹系のデータベースとは別に、判断の材料を取り出す専用として建てます。
データウェアハウスはデータを時系列に蓄積し、データのネーミングルールや形式を統一して一元化します。また、データの蓄積に主眼を置いているため、すでに格納されているデータは変更されません。
押さえるべき4つの特徴
| 特徴 | 内容 |
|---|---|
| 別に作る |
簡単にいうと
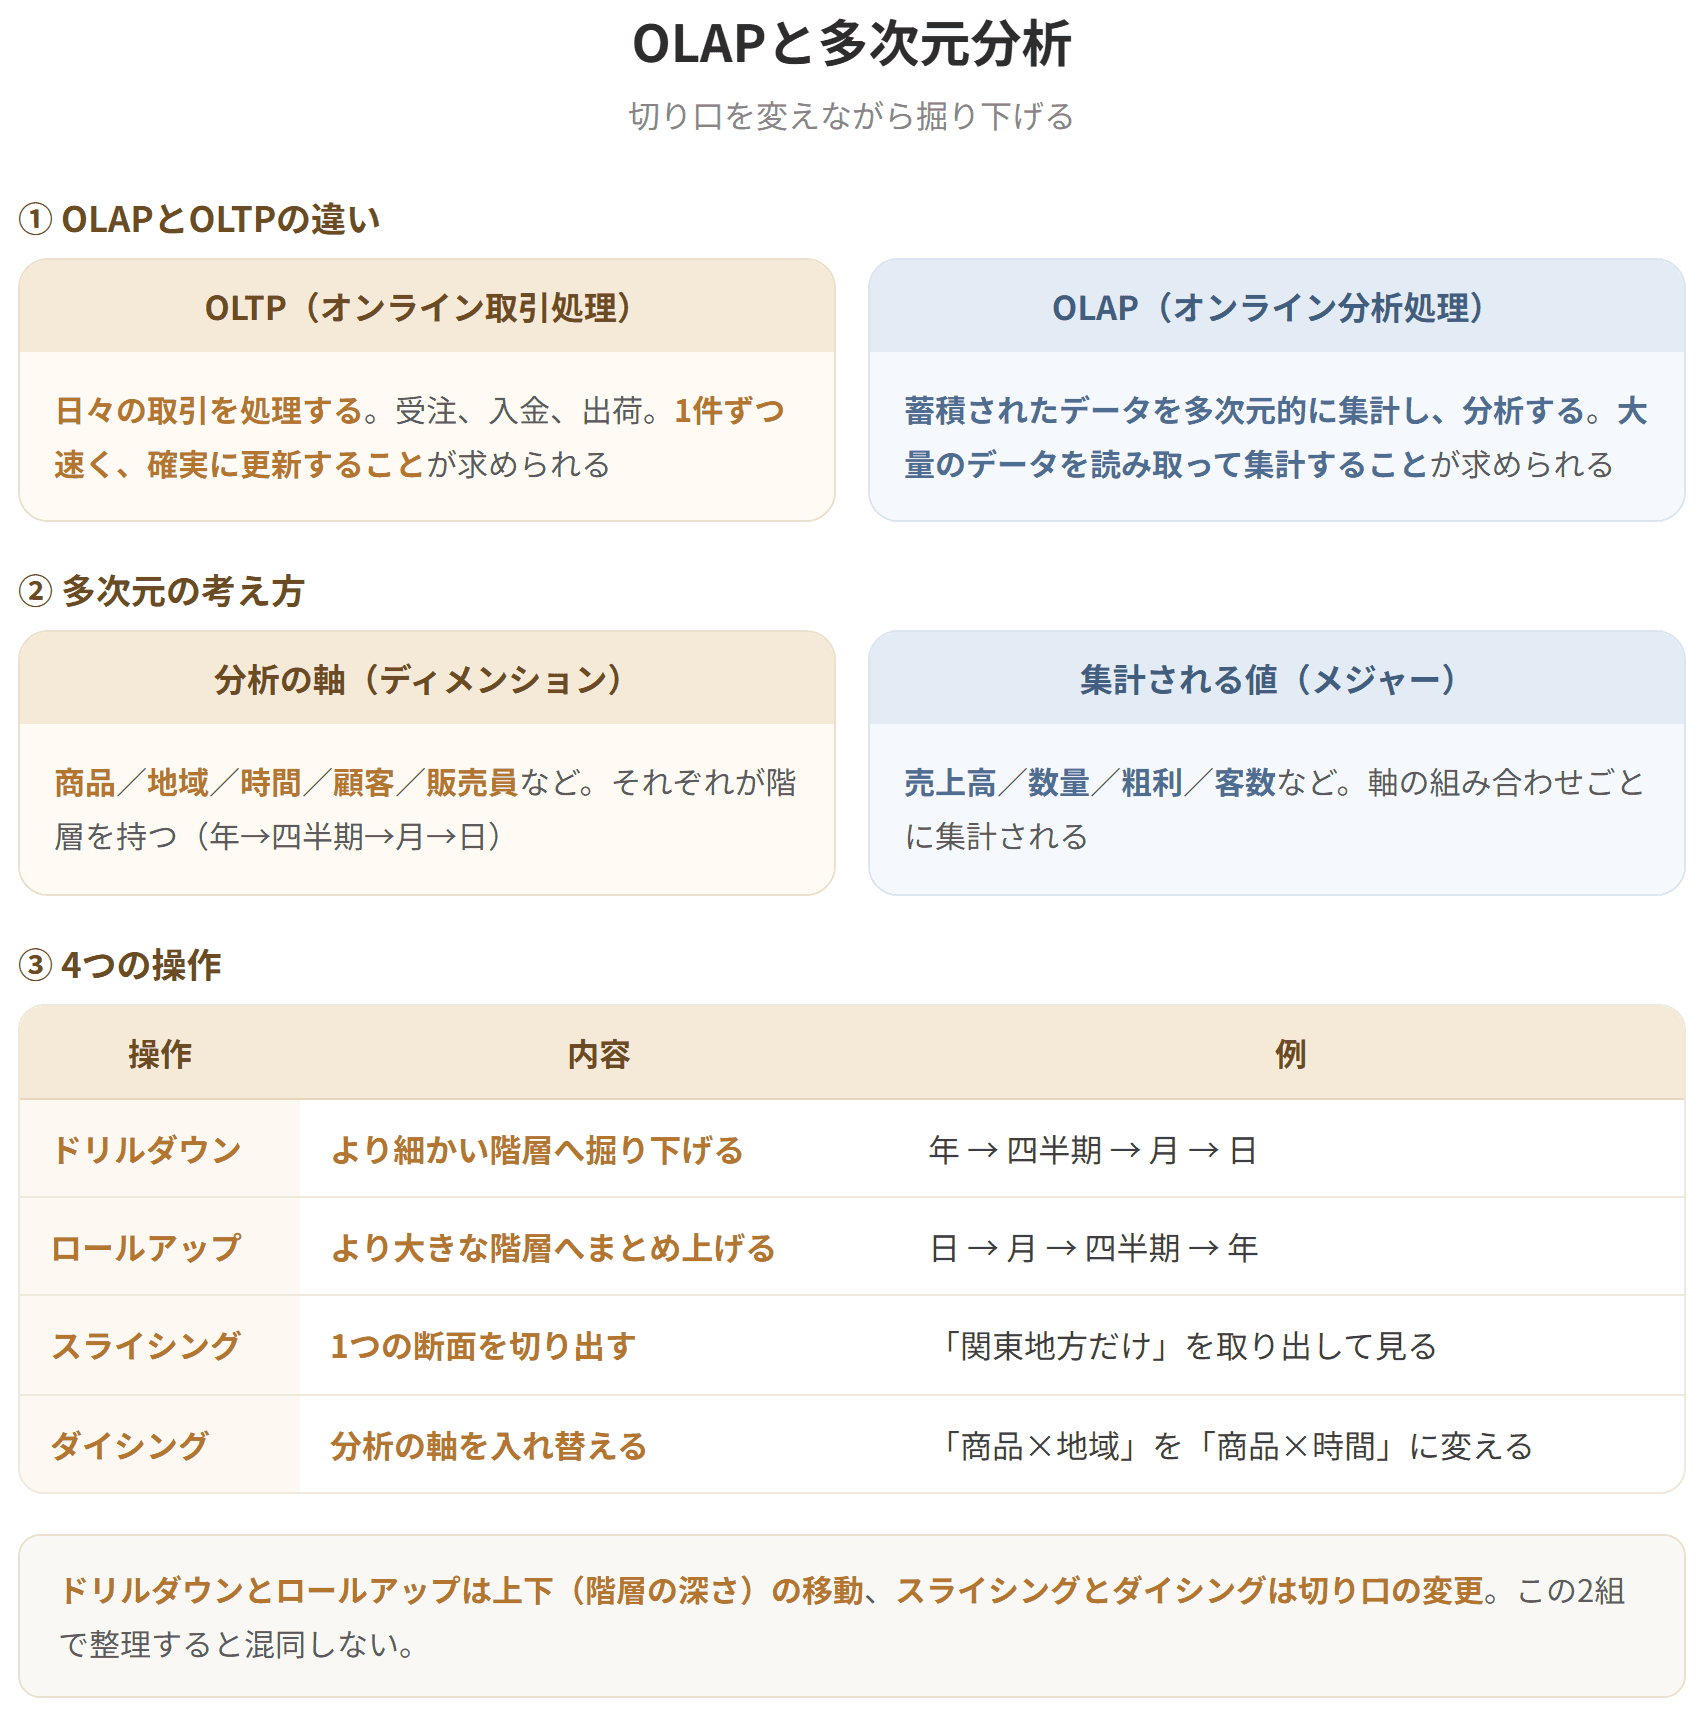
売上データを「地域別」で見たり「月別」で見たり「商品別」で見たり——この視点の切り替えを自在にやるのがOLAP!サイコロを転がすイメージで、4つの操作を覚えよう。
① OLAP(Online Analytical Processing)とは
データウェアハウスにためた大量のデータを、縦横いくつもの軸(多次元データモデル)で切りながら眺めるための道具です。断面を取る、軸を入れ替える、細かいところまで降りる、まとめて上がる——スライシング・ダイシング・ドリルダウン・ロールアップという操作で、判断の材料を引き出します。
OLAPは、オンライン処理分析ともよばれます。BIツールの1つで、業績管理、市場分析、販売分析などの用途に使われます。
② 多次元データモデルとは
売上データを例に考えます。1つの売上には、少なくとも次の3つの属性があります。
簡単にいうと
集めたデータは、そのままでは使えないことがほとんど。表記がバラバラだったり、抜けていたり、重複していたり。それを使える形に整えるのが、ここで学ぶ技術たちだよ!
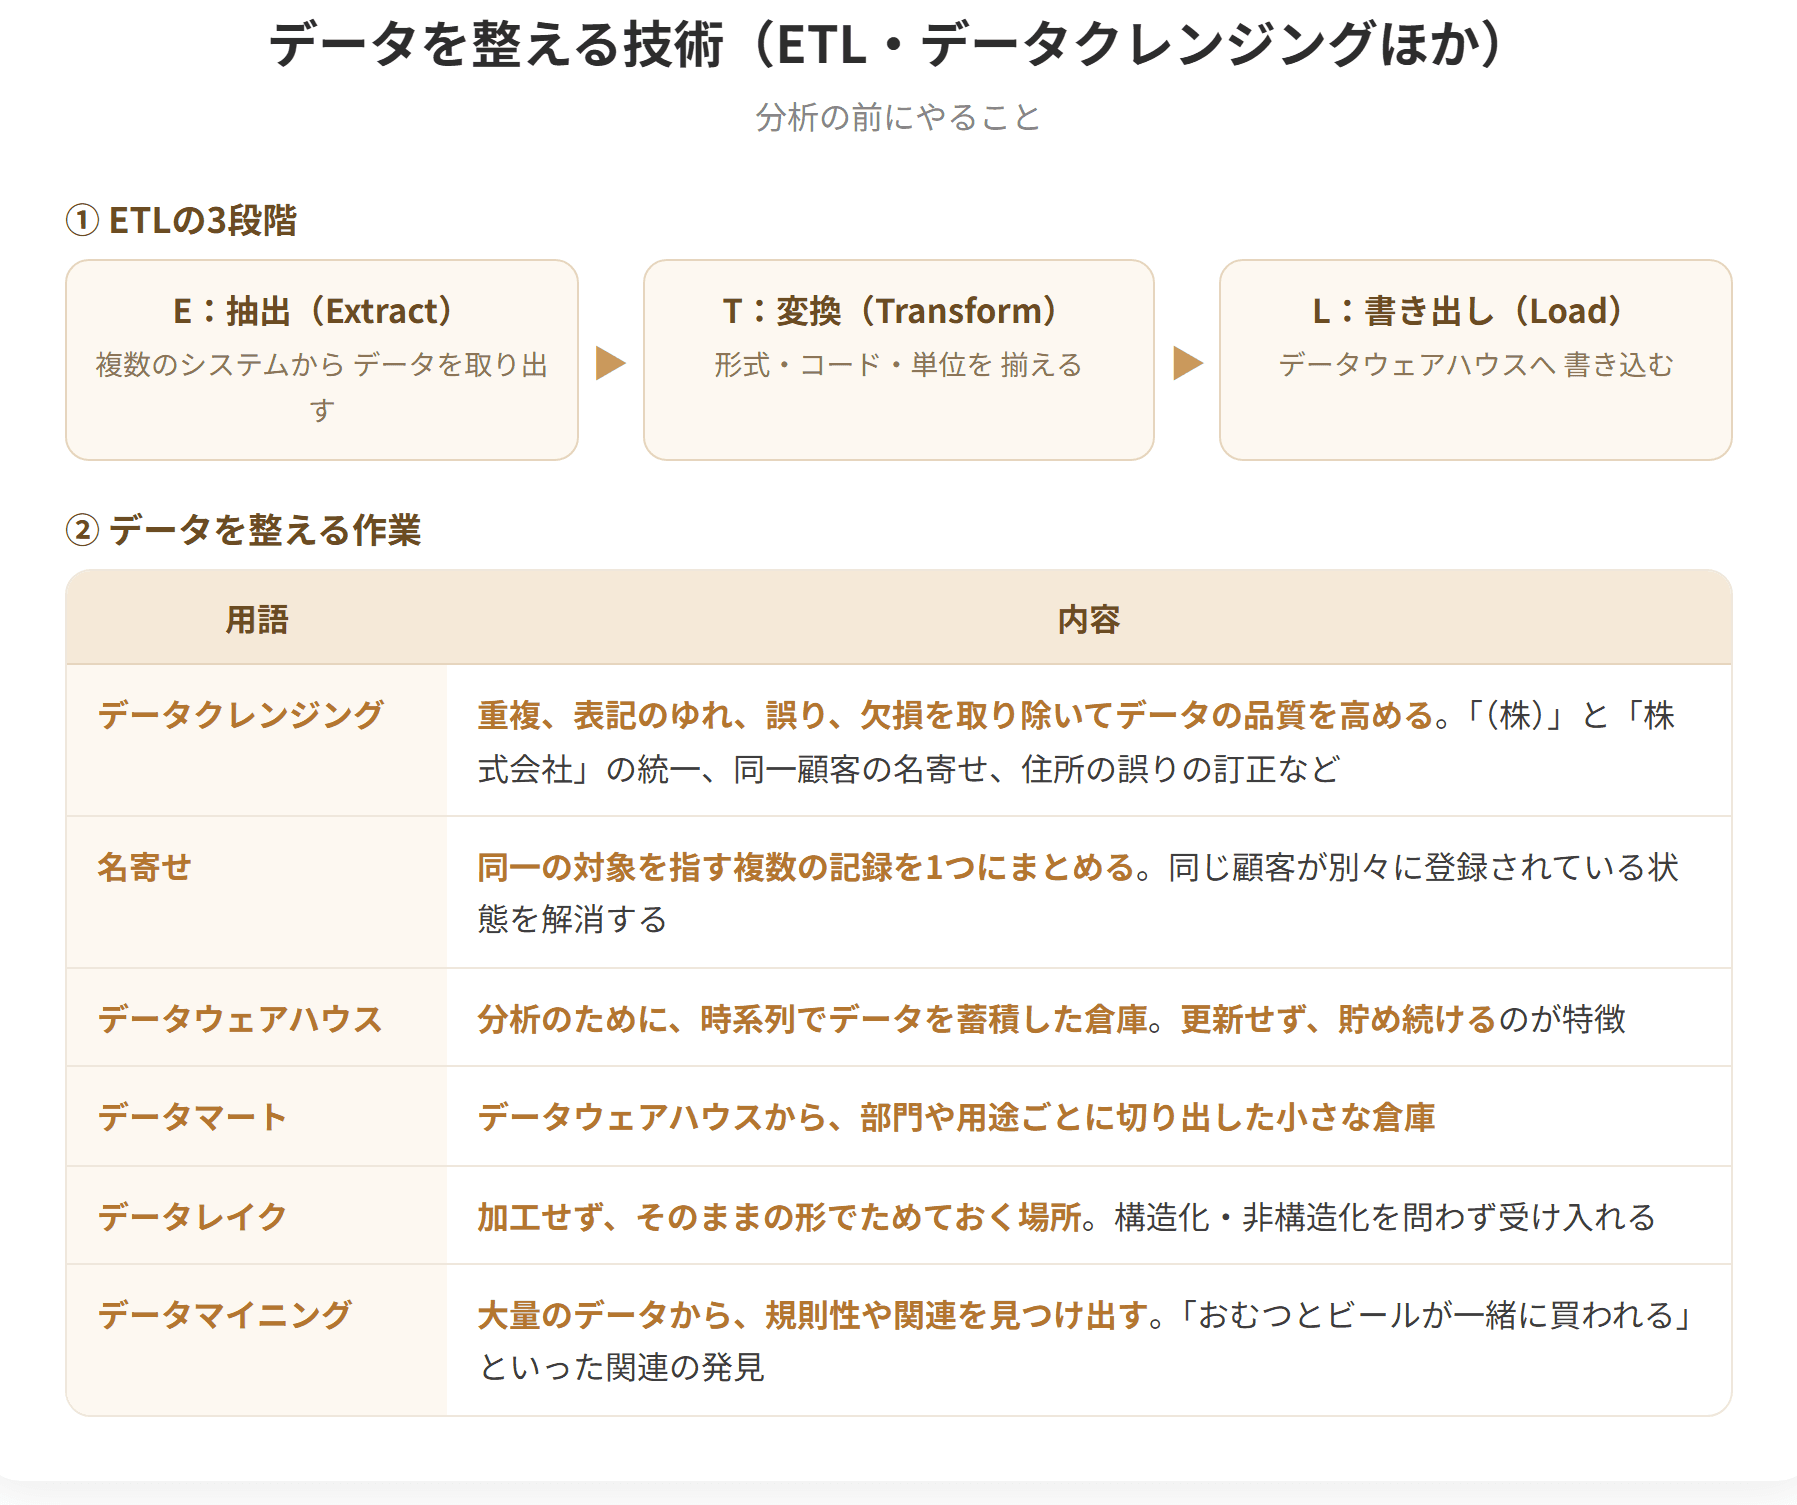
① ETL
さまざまなデータソースからデータを抽出(Extract)し、扱いやすいフォーマットに変換(Transform)し、データウェアハウスに書き出し(Load)を行うことで、大量のデータをデータウェアハウスに統合して格納する処理です。
これらの処理の頭文字をとってETLとよび、ETLを実施するにはETLツールとよばれるソフトウェアを用います。
| 頭文字 | 英語 | 何をするか |
|---|---|---|
| E | Extract |

動画・テキスト・過去問・AI添削まですべて網羅!
予備校代の1/10以下で、独学の不安をまるごと解決できます

 全7科目536節の解説動画539本・合計約41時間が見放題。連続再生・ブックマーク再生で、移動中も1本5分前後で進められます。プレミアム限定
 令和3〜7年度の1次過去問1,116問を、科目別・年度別に無制限で演習。問題の図・表と解説つきで、間違えた問題はマイページに残ります。プレミアム限定
 2次は事例I〜IVの114設問に何度でも書いて出せます。AIが設問ごとの基準で採点し、改善点は「どう書き直すか」の例と模範解答つき。プレミアム限定
 科目別のテキストPDFをダウンロードできます。印刷して書き込む、タブレットで持ち歩くなど、好きな使い方で。プレミアム限定
| 必要なものを取り出す |
| 分析 | 傾向や関係を見る |
| 加工 | 意思決定に使える形にする |
「事実に基づくデータ」から「意思決定に有用な知識」へ——この変換こそがBIの本質です。データそのものは知識ではありません。売上明細が何万行あっても、それだけでは何も分かりません。集計し、比較し、傾向を読み取って初めて「知識」になります。
③ ビッグデータ
ビッグデータとは、大量でかつリアルタイムに発生する構造化および非構造化データ(半構造化データも含む)を蓄積し、それらを処理・分析するための技術の総称です。
近年は、デジタルデータの多様化に伴い、構造化データに加えて半構造化データならびに非構造化データの利活用の重要性が高まっています。
④ ビッグデータの全体像
ビッグデータの対象になるのは、たとえば次のようなデータです。
| データの出どころ | 内容 |
|---|---|
| 業務システムのデータ | 受注、在庫、会計などの記録 |
| さまざまなログファイル | システムの動作記録、アクセス履歴 |
| CRMシステムの顧客データ | 顧客の属性、購買履歴、問い合わせ履歴 |
| Webサイト、ブログ | 閲覧履歴、投稿内容 |
| ソーシャルメディア | 投稿、反応、つながり |
| 静止画、動画 | 監視カメラ、写真 |
| センサーデータ | 温度、位置、振動、稼働状況 |
これらを集めたうえで、大量のデータ+学習機能+高速な判断によって、
ことを行い、その結果を
につなげる、というのがビッグデータ活用の流れです。
⑤ 「3つのV」という整理
試験の定義文には出てきませんが、ビッグデータを説明するときによく使われる整理も知っておくと理解が深まります。
| 要素 | 意味 |
|---|---|
| Volume(量) | データの量が大きい |
| Variety(多様性) | データの種類が多い |
| Velocity(速度) | データの発生が速い(リアルタイム) |
大量でかつリアルタイムに発生する構造化および非構造化データ——ビッグデータの定義は、この3つをそのまま並べた形になっています。
⑥ 中小企業とビッグデータ
「ビッグデータは大企業のもの」と思われがちですが、中小企業にも活用の余地はあります。
| 業種 | 活用できるデータ | 得られること |
|---|---|---|
| 小売業 | POSデータ、会員カードの履歴 | 売れ筋の把握、品揃えの見直し |
| 飲食業 | 予約システム、天候データ | 来客予測、仕入れの適正化 |
| 製造業 | 設備の稼働データ、センサー | 故障の予兆検知、保全の効率化 |
| サービス業 | 予約履歴、問い合わせ内容 | 顧客の離脱予測、サービス改善 |
重要なのは、手元にあるデータから始めることです。第13章で学ぶIoTやAIも、結局は「どんなデータが取れるか」から出発します。診断士としては、顧問先がすでに持っているデータに気づかせることが、最初の助言になります。
| 季節要因か構造的要因か |
いずれも社内の整った数値(構造化データ)を集計・比較しています。これが従来型のBIです。
ビッグデータで加えて分かること
| 分析 | 使うデータ | 分かること |
|---|---|---|
| 店内の動線分析 | 監視カメラの映像 | どの棚の前で足が止まるか |
| 口コミの傾向分析 | SNSの投稿、レビュー | 何が不満とされているか |
| 来店予測 | 天候、イベント、交通データ | 明日の客数はどれくらいか |
| 問い合わせの内容分析 | 電話の音声、メール本文 | どんな要望が増えているか |
映像、文章、音声といった「整っていないデータ」まで対象にしている点が違います。
なぜこれが可能になったのか
| 要因 | 内容 |
|---|---|
| 記憶装置が安くなった | 大量のデータをためておける |
| 処理能力が上がった | 大量のデータを現実的な時間で処理できる |
| 機器がデータを出すようになった | センサーやカメラが常時記録する |
| 分析技術が発達した | 画像認識、自然言語処理が実用水準になった |
第1章で学んだ記憶装置の大容量化と、第13章で学ぶAI・機械学習の発達が、ビッグデータという概念を支えています。技術の進歩が、扱えるデータの範囲を広げたわけです。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a BIとは、企業内外の事実に基づくデータを蓄積、分類、検索、分析、加工して、意思決定に有用な知識を生み出す概念や仕組みである。
> b ビッグデータは、構造化データのみを対象とする技術の総称である。
> c BIを実現するためのソフトウェアをBIツールという。
解答 a:○ b:× c:○
特定の形式やスキーマに従っていないデータです。テキスト、画像、音声、動画などが非構造化データの例です。
このデータタイプは非常に多岐にわたり、構造化データや半構造化データと比較して分析が難しいことが一般的です。非構造化データを活用するには、特殊なツールやアプローチが必要になります。
② 3つを1枚の表で
| 特性 | 構造化データ | 半構造化データ | 非構造化データ |
|---|---|---|---|
| 形式 | 定義されたスキーマ、テーブル構造 | 一定の構造(キーやタグなど) | 特定の形式がない |
| 例 | リレーショナルデータベースのテーブル | XML、JSON、YAML、HTML | テキスト、音声、画像、動画 |
| データ収集の容易性 | 低い | 中程度 | 高い |
| 操作・分析の容易性 | 高い(SQLなどで操作) | 中程度(特殊なツールが必要) | 低い(特殊な技術が必要) |
| 柔軟性(目的以外の用途) | 低い | 高い | 高い |
| 用途 | トランザクション処理、レポート作成など | WebAPI、ログファイルの記録など | 画像認識、音声認識、自然言語処理など |
③ 表を読み解く——2つのトレードオフ
この表でもっとも重要なのは、行によって向きが逆になっている点です。
トレードオフ1:集めやすさ と 分析しやすさ
| 構造化 | 非構造化 | |
|---|---|---|
| データ収集の容易性 | 低い | 高い |
| 操作・分析の容易性 | 高い | 低い |
構造化データは集めにくいが分析しやすい、非構造化データは集めやすいが分析しにくい——ちょうど正反対になっています。
なぜでしょうか。構造化データを作るには、あらかじめ「この項目をこの型で持つ」と決めておかなければなりません。決める作業そのものに手間がかかり、決めた形に合わないデータは入れられません。だから集めにくいのです。
一方、監視カメラの映像や顧客からのメールは、何も決めなくても自然にたまっていきます。だから集めやすい。しかしその中身を機械が理解するのは難しく、分析には特殊な技術が要ります。
トレードオフ2:柔軟性
| 構造化 | 非構造化 | |
|---|---|---|
| 柔軟性(目的以外の用途) | 低い | 高い |
構造化データは、最初に決めた目的に合わせて作られているため、別の目的には使いにくくなります。「単価×数量」しか持っていない表から、顧客の感情を読み取ることはできません。
非構造化データは、形が決まっていないぶん、あとから別の目的に使える余地があります。監視カメラの映像は、もともと防犯目的で録っていても、あとから動線分析に使えます。
④ 半構造化データの位置づけ
半構造化データは、この両極の中間に位置します。
| どちらに近いか | |
|---|---|
| 構造がある | 構造化データ寄り |
| スキーマを事前に定義しない | 非構造化データ寄り |
JSONやXMLは、タグやキーによって「どこに何が書いてあるか」が分かるので、機械が読み解けます。しかし、項目の数や階層はデータごとに違っていてよいので、リレーショナルデータベースの表のような窮屈さがありません。
この性質から、システム間のデータ受け渡し(WebAPI)やログファイルの記録に広く使われます。第2章で学んだCSVよりも表現力が高く、非構造化データよりも扱いやすい——この中間の位置が、現代のシステム連携でJSONやXMLが主流になった理由です。
具体例
同じ「顧客の声」を3つの形で持つと
顧客から寄せられた意見を、3つの形で記録した場合を比べてみます。
構造化データとして持つ
| 問い合わせID | 日付 | 顧客ID | 分類 | 満足度 |
|---|---|---|---|---|
| 1001 | 04/01 | C001 | 品質 | 2 |
| 1002 | 04/01 | C002 | 配送 | 4 |
利点……SQLで「品質に関する問い合わせで満足度2以下の件数」をすぐ集計できます。
欠点……分類を「品質・配送・価格」の3つと決めてしまうと、それ以外の意見を記録できません。また、具体的に何が不満だったのかは失われています。
半構造化データとして持つ(JSON)
```
{
"問い合わせID": 1001,
"日付": "04/01",
"顧客": { "ID": "C001", "会員種別": "ゴールド" },
"分類": ["品質", "包装"],
"満足度": 2
}
```
利点……分類を複数持てますし、顧客の中に会員種別という階層を作れます。データごとに項目が違ってもよいので、追加の情報を柔軟に記録できます。
欠点……集計するには、JSONを読み解くツールが必要です。
非構造化データとして持つ
> 「先日届いた商品ですが、箱が潰れていて、中身にも傷がありました。配送が丁寧でないのではないでしょうか。商品自体は気に入っているので残念です。」
利点……顧客が言いたかったことがそのまま残っています。「商品自体は気に入っている」という情報は、構造化データの「満足度2」からは決して読み取れません。
| 目的 | 適した形 |
|---|---|
| 月次の件数集計、KPI管理 | 構造化データ |
| システム間でデータを受け渡す | 半構造化データ |
| 顧客の本音を探る、原因を深掘りする | 非構造化データ |
多くの企業では3つを併用しています。集計用に構造化データを作りつつ、元の文章も非構造化データとして残しておく、という形です。
「構造化する」ことは情報を捨てること
上の例で分かるとおり、構造化とは決めた枠に当てはめる作業であり、枠からはみ出す情報は落ちます。分析しやすさと引き換えに、情報の豊かさを失っているわけです。
この理解があると、次のテーマで学ぶデータレイク——データをそのままの形で格納する——という考え方が生まれた理由が見えてきます。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 半構造化データは、JSONやXML、YAMLなどのフォーマットで保存されることが多い。
> b 構造化データは、データ収集の容易性が高く、操作・分析の容易性は低い。
> c 非構造化データを活用するには、特殊なツールやアプローチが必要になる。
解答 a:○ b:× c:○
構造化データ・半構造化データ・非構造化データ
試験のポイント
| 時系列 | データを時系列に蓄積する |
| 一元化 | ネーミングルールや形式を統一する |
| 変更しない | すでに格納されているデータは変更されない |
なぜ基幹業務と分けるのか
基幹業務のデータベースは、日々の取引を記録し、更新することが目的です。ここで大量の分析用の問い合わせを実行すると、本来の業務処理が遅くなってしまいます。
また、基幹業務のデータベースは正規化されており(第6節)、分析のたびに多数の表を結合する必要があります。分析には向いていないのです。
だから、分析専用の場所を別に用意する——これがデータウェアハウスの発想です。
② データマート(DM:Data Mart)
データマートは利用目的を限定し、利用ユーザを限定した使い方をするもので、データウェアハウスから必要なデータを抽出し、利用しやすい形式で格納したデータベースです。
> データウェアハウスは膨大なデータ項目、データ量をもつデータベースであり、すべてのユーザがすべてのデータを必要としているわけではありません。データマートはあくまでデータウェアハウスの整合性のとれたデータから作るものであり、その逆はありません。
名前の由来……warehouse(倉庫)に対して mart(小売店)。大きな倉庫から必要なぶんだけ取り出して並べた売り場、というイメージです。
「その逆はない」という一文が重要です。データマートを寄せ集めてデータウェアハウスを作る、という順序は成り立ちません。整合性のとれた大元があって、そこから切り出すという向きです。
③ ODS(Operational Data Store:オペレーショナルデータストア)
ODSは、基幹系システムのデータ(オペレーショナルデータ)を、検索など別の目的で利用するためにそこから抽出し、一時的にデータを保持するデータベースのことです。
異なる基幹系システムからのデータを統合することで、現在の出荷状況や顧客のリアルタイム分析などが可能となります。また、基幹系システムからデータウェアハウスへデータをロードする際の中間データベースとしても活用されます。
| データウェアハウス | ODS | |
|---|---|---|
| 保持する期間 | 長期(時系列に蓄積) | 一時的 |
| 見るもの | 過去からの推移 | 現在の状況(リアルタイム) |
| 位置づけ | 分析の本拠地 | 基幹系とDWHの中間 |
④ データレイク
構造化データ・半構造化データ・非構造化データを含む多様なデータをそのままの形式で格納する一元化されたリポジトリ(データやプログラムの情報が納められたデータベース)です。
データをそのままの形で保存できるため、スキーマをあらかじめ定義する必要がなく、データを構造化しておく必要がありません。また、データの可視化、ビッグデータ処理、リアルタイム分析、機械学習など、さまざまなタイプの分析を実行し、的確な意思決定に役立てることができます。
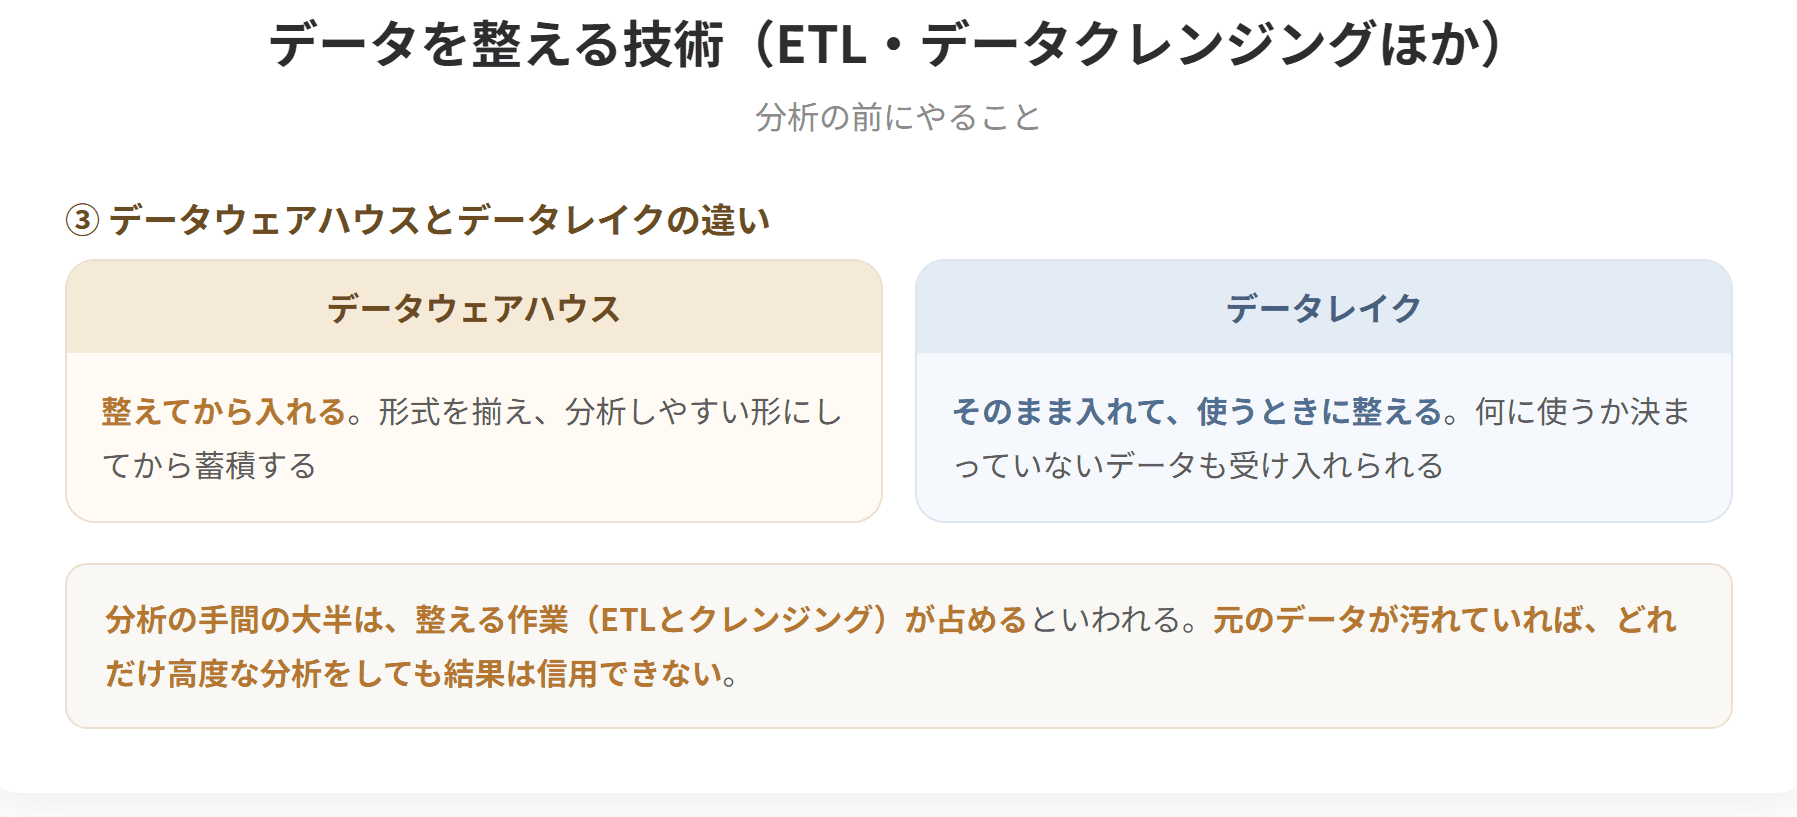
⑤ データウェアハウスとデータレイクの違い
| データウェアハウス | データレイク | |
|---|---|---|
| 入れる前の加工 | 整理・統合してから入れる | そのままの形式で入れる |
| スキーマ | あらかじめ定義する | 定義しない |
| 対象 | 主に構造化データ | 構造化・半構造化・非構造化のすべて |
| 名前の由来 | warehouse(倉庫)=整頓された保管場所 | lake(湖)=流れ込んだまま |
「倉庫」と「湖」という名前の対比が、そのまま性格の違いを表しています。倉庫は棚に整理して入れる場所、湖は川から流れ込んだ水がそのままたまる場所です。
⑥ データスワンプ
どこにどのようなデータがあるかわからず、欲しいデータを捉えることができない状態です。
swamp は「沼」という意味です。湖(レイク)が管理されないまま放置されると、沼(スワンプ)になる——という皮肉を込めた名前です。
データレイクは「とりあえず何でも入れておけばよい」という手軽さがある反面、何がどこにあるかの管理を怠ると、使い物にならなくなります。データをためること自体が目的化してはいけない、という戒めの用語だといえます。
⑦ 4つを流れで並べる
| 順番 | 場所 | 状態 |
|---|---|---|
| ① | 基幹系システム | 日々の取引データが発生する |
| ② | ODS | 一時的に抽出・統合される |
| ③ | データウェアハウス | 整理・統合され時系列に蓄積される |
| ④ | データマート | 目的とユーザを限定して切り出される |
データレイクはこの流れとは別に、加工前の生データを何でも受け止める場所として位置づけられます。そして管理を怠るとデータスワンプになります。
具体例
設例 データウェアハウスに関する記述
> 次の記述の正誤を判定せよ。(令和7年度第16問 改題)
> ア ETLとは、さまざまなデータソースからデータを抽出し、扱いやすいフォーマットに変換して、データウェアハウスに統合して格納する処理のことである。
> エ データスワンプとは、データウェアハウスから必要なデータを抽出し、利用しやすい形式で格納したデータベースのことである。
> オ データマートとは、データウェアハウスに蓄積する構造化されたデータや、IoT機器やSNSなどからの構造化されていないデータを、そのままの形式で格納するデータベースのことである。
解答 ア:○ エ:× オ:×
エとオがずれている構造
この設問では、用語と説明が1つずつずれています。
| 選択肢の用語 | 書かれている説明 | 本来の用語 |
|---|---|---|
| データスワンプ | 必要なデータを抽出し利用しやすい形式で格納 | データマート |
| データマート | そのままの形式で格納 | データレイク |
キーワードで判別する
| 説明の中のキーワード | 対応する用語 |
|---|---|
| そのままの形式で格納 | データレイク |
| 利用目的・利用ユーザを限定 | データマート |
| 時系列に蓄積、基幹業務とは別に作成 | データウェアハウス |
| 一時的に保持、リアルタイム分析 | ODS |
| どこに何があるかわからない状態 | データスワンプ |
「そのままの形式で」という語が出てきたらデータレイク——これだけ覚えておけば、オのような選択肢は即座に切れます。
実務での組み立て方
ある製造業が、工場の設備データと販売データを合わせて分析したい、という場面を考えます。
| 段階 | 置き場所 | 何をするか |
|---|---|---|
| ① | 基幹系(生産管理・販売管理) | 日々の記録が発生する |
| ② | データレイク | センサーの生データをそのまま蓄積する |
| ③ | ODS | 複数システムのデータを一時的に統合し、現在の稼働状況を見る |
| ④ | データウェアハウス | 形式をそろえ、時系列に蓄積する |
| ⑤ | データマート | 生産部門向け、営業部門向けに切り出す |
なぜこれだけの段階が要るのか
「全部データウェアハウスに入れればいいのでは」と思うかもしれません。しかし、
というように、それぞれが別の問題を解いています。用語を丸暗記するのではなく、どんな不便を解消するために生まれたのかを押さえると、記憶に定着します。
中小企業への助言として
すべてを揃える必要はありません。多くの中小企業では、
1. まず基幹系のデータを1か所に集める(簡易なデータウェアハウス)
2. 部門ごとに見たい形に整える(簡易なデータマート)
という2段階で十分な効果が出ます。段階を飛ばして最新の仕組みを導入しても、使われなければ意味がない——この視点は、第11章のIT投資管理でも繰り返し出てきます。
データウェアハウスとOLAP
試験のポイント
平面の表では「地域×月」か「商品×月」のどちらかしか表せませんが、立方体として持っておけば、見たい面を選んで切り取ることができます。
③ 4つの基本操作
| 操作 | 内容 |
|---|---|
| スライシング | データウェアハウススキーマ内の中心に位置するファクトテーブルをある断面で切り取り、2次元の表にする操作 |
| ダイシング | ファクトテーブルについて、縦軸と横軸を自由に指定することで、サイコロを転がすように、視点を切り替える操作 |
| ドリルダウン | ファクトテーブルについて、参照するデータを深堀する操作 |
| ロールアップ(ドリルアップ) | 反対に集約化したデータを見る操作 |
④ 4つを2組に分けて理解する
| 組 | 操作 | 何を変えるか |
|---|---|---|
| 切り口を変える | スライシング、ダイシング | どの軸で見るか |
| 詳しさを変える | ドリルダウン、ロールアップ | どこまで細かく見るか |
スライシングとダイシング
dice はサイコロの意味です。サイコロを転がして違う目を出す、というイメージがそのまま名前になっています。
ドリルダウンとロールアップ
drill(穴を掘る)で下へ、roll up(巻き上げる)で上へ。名前が動きを表しています。
⑤ ドリルスルー
ドリルスルーは、集計データから関連付けられた別のレポート(詳細ページなど)へのリンクやナビゲーションを指します。
ドリルダウンとドリルスルーの大きな違いは、ドリルダウンは同一データセット内で一段階より詳細なレベルに移動することであるが、ドリルスルーは別のデータセットにある関連情報にページ間を移動する点です。
| ドリルダウン | ドリルスルー | |
|---|---|---|
| 移動先 | 同一データセット内 | 別のデータセット |
| 動き | 一段階詳細なレベルへ | 関連するページへ |
売上の集計表から店舗別の内訳へ進むのがドリルダウン、売上の集計表から在庫のレポートへ飛ぶのがドリルスルー、というイメージです。
⑥ OLAPの3つの実装方法
OLAPには、3つの実装方法があります。
| 名称 | データストレージ |
|---|---|
| ROLAP(Relational OLAP) | リレーショナルデータベースを使用してオンライン分析処理を行う方式 |
| MOLAP(Multidimensional OLAP) | 多次元データベースを使用してオンライン分析処理を行う方式 |
| HOLAP(Hybrid OLAP) | リレーショナルデータベースと多次元データベースの両方を使用してオンライン分析処理を行う方式 |
⑦ 3つの特徴を比べる
| 項目 | ROLAP | HOLAP | MOLAP |
|---|---|---|---|
| データストレージ | リレーショナルデータベース | 両方 | 多次元データベース |
| レスポンス | 遅い | 中程度 | 速い |
| 最新情報の参照(リアルタイム性) | 優れている | 中程度 | 劣る |
なぜこうなるのか
レスポンスとリアルタイム性は逆向き——これがこの表の読みどころです。頭文字の R・H・M の順に並べると、レスポンスは遅い→中→速い、リアルタイム性は優れる→中→劣る、ときれいに反転します。
具体例
設例 OLAPの操作
> 次の記述の正誤を判定せよ。(令和5年度第16問 改題)
> イ MOLAPとは、多次元データを格納するのにリレーショナルデータベースを用いたものをいう。
> エ ダイシングとは、多次元データの分析軸を入れ替えて、データの切り口を変えることをいう。
> オ ドリルスルーとは、データ集計レベルを変更して異なる階層の集計値を参照することをいう。
解答 イ:× エ:○ オ:×
イの見分け方
頭文字が手がかりになります。
| 名称 | 頭文字 | 対応するデータベース |
|---|---|---|
| ROLAP | Relational | Relational(リレーショナル) |
| MOLAP | Multidimensional | Multidimensional(多次元) |
| HOLAP | Hybrid | 両方 |
頭文字がそのままデータベースの種類を表しているので、名前さえ正確に覚えていれば間違えません。
オの見分け方
「データ集計レベルを変更して異なる階層の集計値を参照する」——「集計レベル」「階層」という語は、縦方向の移動を表しています。縦方向はドリルダウンとロールアップの領分です。
ドリルスルーは横方向の移動(別のレポートへ)なので、この説明には当てはまりません。
実際の分析の流れを追う
小売チェーンの売上を、OLAPで分析する場面を追ってみましょう。
出発点……地域×月の売上表
| 1月 | 2月 | 3月 | 合計 | |
|---|---|---|---|---|
| 東京 | 20 | 22 | 24 | 66 |
| 広島 | 16 | 18 | 20 | 54 |
| 福岡 | 12 | 14 | 12 | 38 |
① 東京が伸びているので、内訳を見たい → ドリルダウン
| 1月 | 2月 | 3月 | 合計 | |
|---|---|---|---|---|
| 池袋 | 8 | 7 | 8 | 23 |
| 原宿 | 6 | 8 | 8 | 22 |
| 目黒 | 6 | 7 | 8 | 21 |
② 地域ではなく商品カテゴリで見たい → ダイシング
| 東京 | 広島 | 福岡 | 合計 | |
|---|---|---|---|---|
| 雑貨 | 20 | 16 | 12 | 48 |
| 化粧品 | 15 | 13 | 9 | 37 |
| 食品 | 5 | 3 | 3 | 11 |
③ 広島だけを取り出して見たい → スライシング
| 1月 | 2月 | 3月 | 合計 | |
|---|---|---|---|---|
| 雑貨 | 16 | 18 | 20 | 54 |
| 化粧品 | 13 | 14 | 18 | 45 |
| 食品 | 3 | 4 | 2 | 9 |
④ 店舗別の数字を地域にまとめたい → ロールアップ
この一連の操作が「対話的」に行えることが、OLAPの価値です。
従来なら、こうした集計を1つ作るたびにシステム部門に依頼し、数日待つ必要がありました。OLAPツールがあれば、思いついたその場で、画面を操作しながら視点を変えられます。
「Online」という語が名前に入っているのは、即座に応答が返ってくることを表しています。分析の流れを止めないことが、意思決定の質を高めるわけです。
確認してみましょう
> 次の記述と対応する操作を答えよ。
> a ファクトテーブルをある断面で切り取り、2次元の表にする。
> b 参照するデータを深堀する。
> c 集約化したデータを見る。
解答 a:スライシング b:ドリルダウン c:ロールアップ(ドリルアップ)
OLAPと多次元分析
試験のポイント
| 各システムからデータを取り出す |
| T | Transform(変換) | 扱いやすい形式に整える |
| L | Load(書き出し) | データウェアハウスに格納する |
ETLツールを使うと、データ形式や値の統一、異常値や欠損値の処理などが自動化されます。このように正確なデータを生成する処理をデータクレンジングとよびます。
② データクレンジング
多様な形式で蓄積されている生データに対して、データ形式統一、欠損値補完、単位統一などの処理を行い、横断的な解析ができるようにデータを整えることです。
具体的には、データの誤り、重複、表記の揺れなどを洗い出し、異質なデータ(外れ値など)を取り除いてデータの品質を高める作業などを指します。
cleansing は「洗浄」という意味です。汚れたデータを洗って使える状態にする、というイメージがそのまま名前になっています。
③ データクレンジングが必要な理由
複数のシステムからデータを集めると、必ず次のような不揃いが生じます。
| 問題 | 例 |
|---|---|
| 表記の揺れ | 「株式会社○○」「(株)○○」「○○(株)」が同じ会社 |
| 形式の違い | 日付が「2024/04/01」「2024-04-01」「令和6年4月1日」 |
| 単位の違い | 重量が「kg」と「g」で混在 |
| 欠損値 | 電話番号が空欄 |
| 重複 | 同じ顧客が2件登録されている |
| 外れ値 | 単価が0円、数量が99999 |
これらを放置したまま集計すると、答えが狂います。「株式会社○○」と「(株)○○」が別の会社として集計されれば、取引先の数も取引額も実態と食い違います。
分析の質は、データの質を超えられない——この原則を押さえておくと、データクレンジングが地味に見えて実は要である理由が分かります。
④ データマイニング
データマイニングとは、大量のデータを分析して、これまで知られなかった規則性や傾向など、何らかの知見を得ることです。データマイニングで利用される具体的な分析手法には、相関分析などがあります。
mining は「採掘」という意味です。データという鉱山を掘って、価値ある鉱石(知見)を見つけ出すというイメージです。
OLAPとの違い
| OLAP | データマイニング | |
|---|---|---|
| 出発点 | 仮説がある(「東京が伸びているのでは」) | 仮説がない |
| やること | 仮説を確かめるために視点を変える | データの中から規則性を探し出す |
| 分析者の役割 | どの切り口で見るかを決める | 見つかった規則性を解釈する |
「こういう傾向があるのでは」と思いついて確かめるのがOLAP、「何か傾向はないか」と探させるのがデータマイニング——この対比で覚えると、両者を混同しません。
⑤ データマッピング
異なるシステム間において、同じ内容を示している項目同士を関連付けたり、割り当てたりするルールや処理のことです。
データマッピングを行うことで、一方のシステムの特定項目を変更すると、関連付けられた別のシステムの項目に自動的に反映されます。
たとえば、販売システムの「得意先コード」と会計システムの「取引先番号」が同じ相手を指している場合、この2つを対応づけておくことがデータマッピングです。
⑥ データマイグレーション
異なる種類のストレージ、フォーマット、コンピュータなどの間でデータを伝送することです。
migration は「移住・移行」という意味です。システムの入れ替えに伴ってデータを引っ越しさせる作業を指します。システム移行の話とつながる用語です。
⑦ 紛らわしい「データ○○」を整理する
この節には「データ」で始まる用語が数多く登場しました。まとめて整理しておきます。
| 用語 | 何をするか/何であるか |
|---|---|
| データウェアハウス | 整理・統合して時系列に蓄積する場所 |
| データマート | 目的とユーザを限定して切り出した場所 |
| データレイク | そのままの形式で格納する場所 |
| データスワンプ | どこに何があるかわからない状態 |
| データクレンジング | データの品質を高める作業 |
| データマイニング | 規則性や傾向を見つけ出す作業 |
| データマッピング | 項目同士を対応づけるルールや処理 |
| データマイグレーション | データを別の環境へ移す作業 |
場所・状態・作業のどれかで仕分けるのが、最初の手がかりになります。
具体例
設例 データマイニング
> 次の記述の正誤を判定せよ。(令和3年度第13問 改題)
> データマイニングとは、大量のデータを分析して、これまで知られなかった規則性や傾向など、何らかの知見を得ることである。
解答 ○
データクレンジングを実際にやってみる
3つのシステムから集めた顧客データを統合する場面を考えます。
統合前
| 出どころ | 顧客名 | 電話番号 | 登録日 |
|---|---|---|---|
| 販売システム | 株式会社山田商事 | 03-1234-5678 | 2024/04/01 |
| 会計システム | (株)山田商事 | 0312345678 | 2024-04-01 |
| CRM | 山田商事(株) | 03(1234)5678 | 令和6年4月1日 |
この3件は同じ会社です。しかしコンピュータにとっては別の3社です。
データクレンジングの手順
| 手順 | 処理 | 結果 |
|---|---|---|
| ① | 法人格の表記を統一 | すべて「株式会社山田商事」 |
| ② | 電話番号の形式を統一 | すべて「03-1234-5678」 |
| ③ | 日付の形式を統一 | すべて「2024-04-01」 |
| ④ | 重複を検出し統合 | 1件にまとめる |
統合後
| 顧客名 | 電話番号 | 登録日 |
|---|---|---|
| 株式会社山田商事 | 03-1234-5678 | 2024-04-01 |
この作業を自動化するのがETLツールです。「法人格の表記を統一する」「電話番号からハイフンを除いて比較する」といったルールを設定しておけば、以降は自動で処理されます。
クレンジングを怠るとどうなるか
| 起きること | 業務への影響 |
|---|---|
| 顧客数が実態の3倍に見える | 顧客あたりの売上が3分の1に見え、判断を誤る |
| 同じ会社に3通のDMを送る | 費用の無駄と、顧客からの不信 |
| 与信限度額が3社分に分かれる | リスク管理が働かない |
| 「取引の多い顧客」の抽出から漏れる | 重要顧客を見落とす |
3つ目がとくに深刻です。1社あたり100万円までと決めていても、3件に分かれていれば実質300万円の与信を与えていることになります。データの品質が、リスク管理の実効性を左右するわけです。
ETLとデータクレンジングの関係
この2つは、しばしばセットで語られます。
| 役割 | |
|---|---|
| ETL | 抽出・変換・書き出しという一連の処理の枠組み |
| データクレンジング | そのうち「変換(Transform)」の中で行われる品質を高める作業 |
ETLの「T」の中身がデータクレンジング、と捉えると、両者の関係が整理できます。
中小企業での現実的な進め方
「いきなりETLツールを導入する」のではなく、次の順で進めるのが現実的です。
1. まず表記ルールを決める(新しく登録するデータから統一する)
2. 既存データを棚卸しして重複を洗い出す
3. 量が多く手作業では追いつかない場合に、ツールの導入を検討する
入口で品質を確保するほうが、あとで洗うより安い——これは製造業の品質管理と同じ考え方です。第4章・運営管理で学ぶ「源流管理」の発想が、データの世界にもそのまま当てはまります。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a ETLは、抽出(Extract)、変換(Transform)、書き出し(Load)の頭文字をとったものである。
> b データマイグレーションとは、異なるシステム間において同じ内容を示す項目同士を関連付けるルールや処理である。
> c データクレンジングでは、データの誤り、重複、表記の揺れなどを洗い出し、外れ値などを取り除く。
解答 a:○ b:× c:○
データを整える技術(ETL・データクレンジングほか)(1/2)
データを整える技術(ETL・データクレンジングほか)(2/2)
試験のポイント

 科目別の正答率と連続学習日数がマイページに出るので、次にどの科目をやるかで迷いません。プレミアム限定
プレミアムプラン
¥9,800〜/ 買い切り・自動更新なし(税込)
決済はStripe(世界最高水準・PCI-DSS準拠)で安全に処理されます。カード情報は当サービスに保存されません。
欠点……この文章から傾向を読み取るには、自然言語処理という特殊な技術が必要です。
実務での使い分け
| 48 |
| 54 |
| 56 |
| 158 |
| 20 |
| 22 |
| 24 |
| 66 |
| 40 |
| 32 |
| 24 |
| 96 |
| 32 |
| 36 |
| 40 |
| 108 |
