データベース
下の動画はこの節の解説ではありません。 解説動画の雰囲気を知っていただくための見本として、「AI・機械学習」の動画を再生します。
この節の解説動画はプレミアム限定です。プレミアムなら全科目・全節が見放題!
プレミアムで見るSELECT文の基本を押さえたら、次は集計です。実際の業務では「1行ずつ見たい」場面より「部署ごとの平均を知りたい」場面のほうが多く、そのための道具がGROUP BY句と集合関数です。この節の後半では、データベース設計のいちばんの山場である正規化を扱います。正規化は、同じデータをあちこちに書かずに済むよう表を分けていく作業です。手順そのものは決まっているので、第1正規化から第3正規化までを実際の受注伝票で追いかけながら身につけていきましょう。令和6年度・7年度と続けて出題されている重要論点です。


簡単にいうと
「部署ごとの平均年齢」みたいな集計は、GROUP BYの出番!そしてWHEREが行を絞るのに対して、HAVINGはグループを絞る。この対応を押さえれば、2つを混同しないよ。
① なぜグループ化が要るのか
SELECT、FROM、WHEREの基本構文では、テーブル内の1行1行に対して条件式の適合を判断し、データの検索を行います。
これに対し、実際の業務では、各行のデータをある単位でグループ化し、平均値を求めたり合計を求めたりする集計のニーズが発生します。たとえば、営業部において月ごとの売上の合計を確認する、営業担当者ごとの売上の平均額を確認するなどです。
これを実現するのがGROUP BY句、HAVING句です。
② 構文
| 句 | 書くもの |
|---|---|
| SELECT <列名> | 抽出する列を指定する |
| FROM <表名> | 問い合わせ対象の表を指定する |
| WHERE <条件式> | 検索条件を指定する |
| GROUP BY <列名> | グループ化する列を指定する(複数の列がある場合は「,(カンマ)」で区切る) |
具体例
WHEREとHAVINGを同時に使う
「30歳未満の社員を対象に、所属コードごとの人数を求め、2人以上の部署だけを表示する」という集計を考えます。
```
SELECT 所属コード, COUNT(*) FROM 社員表
WHERE 年齢 < 30
GROUP BY 所属コード
HAVING COUNT(*) >= 2
```
処理の順番を追う
| 順番 | 句 | 何が起きるか |
|---|---|---|
| ① | FROM | 社員表を読む(5行) |
| ② | WHERE |
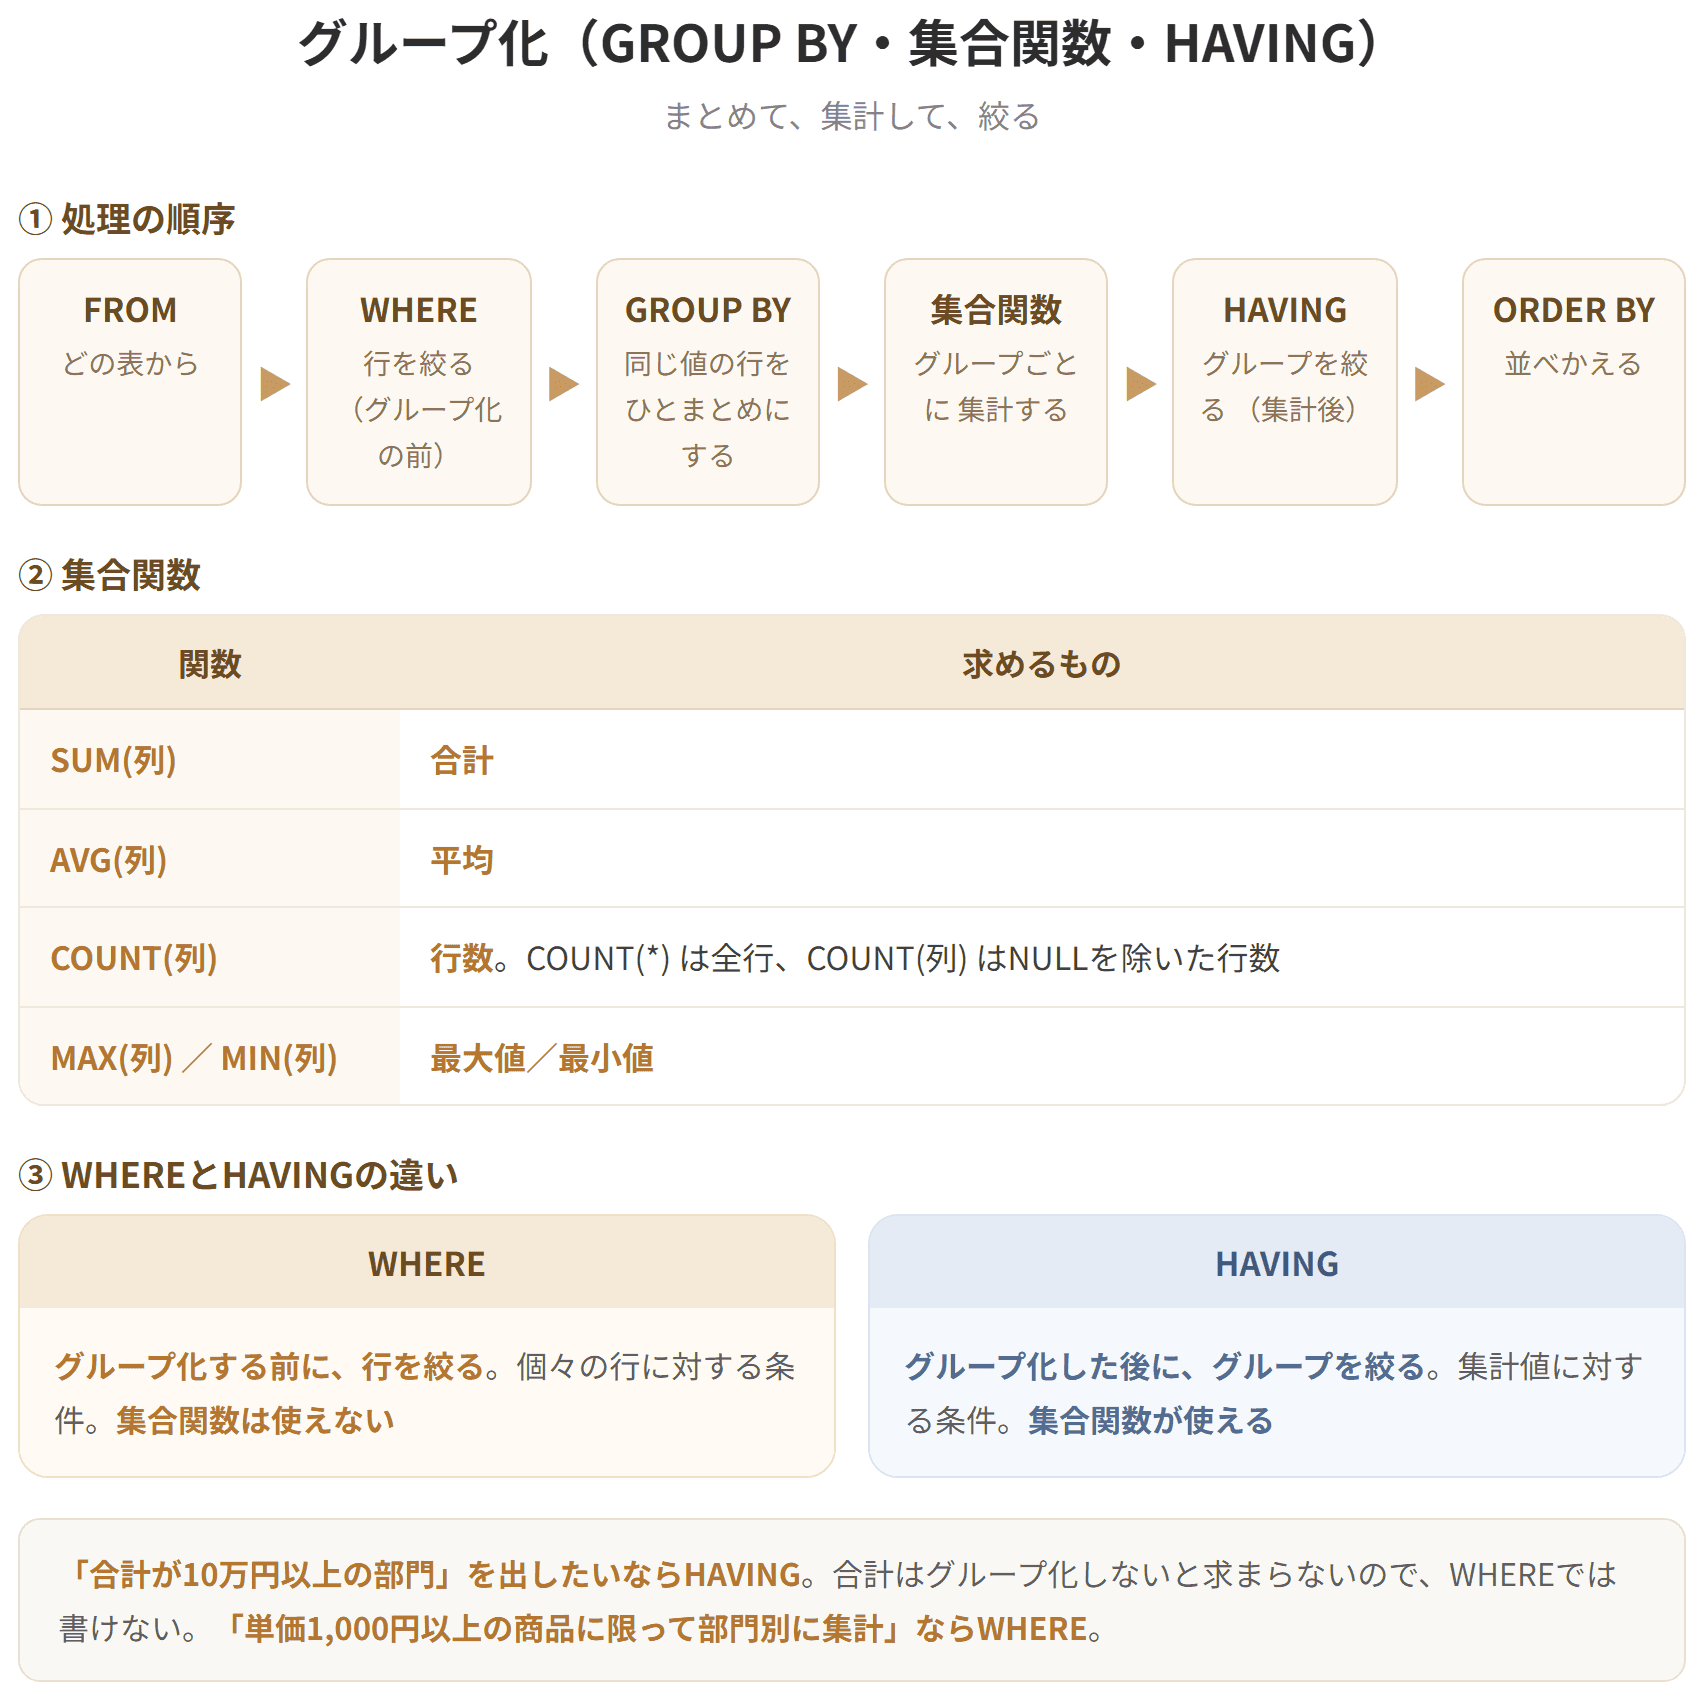
グループ化(GROUP BY・集合関数・HAVING)

試験のポイント

簡単にいうと
ここはSELECT文の仕上げの道具箱!並べ替えるORDER BY、名前を付け替えるAS、2つの結果をつなぐUNION、そして条件で処理を変えるCASE。どれも「結果を見やすくする」ための道具だよ。
① データの並びかえ(ORDER BY)
関係データベースにおける表は行の集合であり、各行がどのような順序で抽出されるかはまったく保証されていません(そもそも順序という概念自体がない)。
これは重要な前提です。表に登録した順に返ってくると思い込んでいると、思わぬ不具合の原因になります。順序がほしいなら、明示的に指定しなければなりません。
ORDER BY句を利用することによって、表を任意の列の降順または昇順に整列することができます。任意の列がアルファベットの場合は、昇順が指定されると、AからZのアルファベット順(上から下)に並びます。
構文
| 句 |
|---|
簡単にいうと
正規化は「同じことを2か所に書かない」ための整理術!第1から第3まで手順が決まっているから、覚えるというより手を動かして体で覚えよう。
① 正規化とは
データベースの正規化とは、関連の強いデータのみを1つの表にまとめ、データの独立性を高めることです。
データの独立性を高めることによって、データの冗長性をなくし、一貫性と整合性を図ることができます。
冗長性とは、同じ情報が何か所にも重複して存在している状態のことです。たとえば顧客の住所が受注のたびに書き込まれていれば、住所が変わったときにすべての行を直さなければなりません。1か所でも直し忘れれば、データが食い違います。
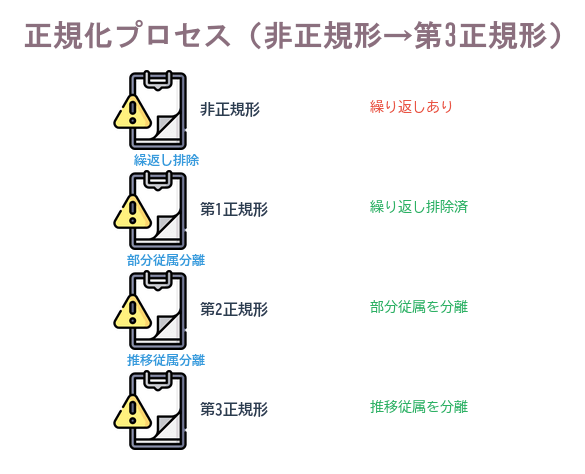
正規化は、一般的に第1正規化から第3正規化までです。正規化された表を正規形とよび、第1正規形から第3正規形まであります。
② 正規化の種類
| 名称 |
|---|
簡単にいうと
正規化をやるには、まず主キーを見つけないと始まらない。「その値が決まれば行が1つに決まる項目」が主キー!そして別の表の主キーを指しているのが外部キーだよ。
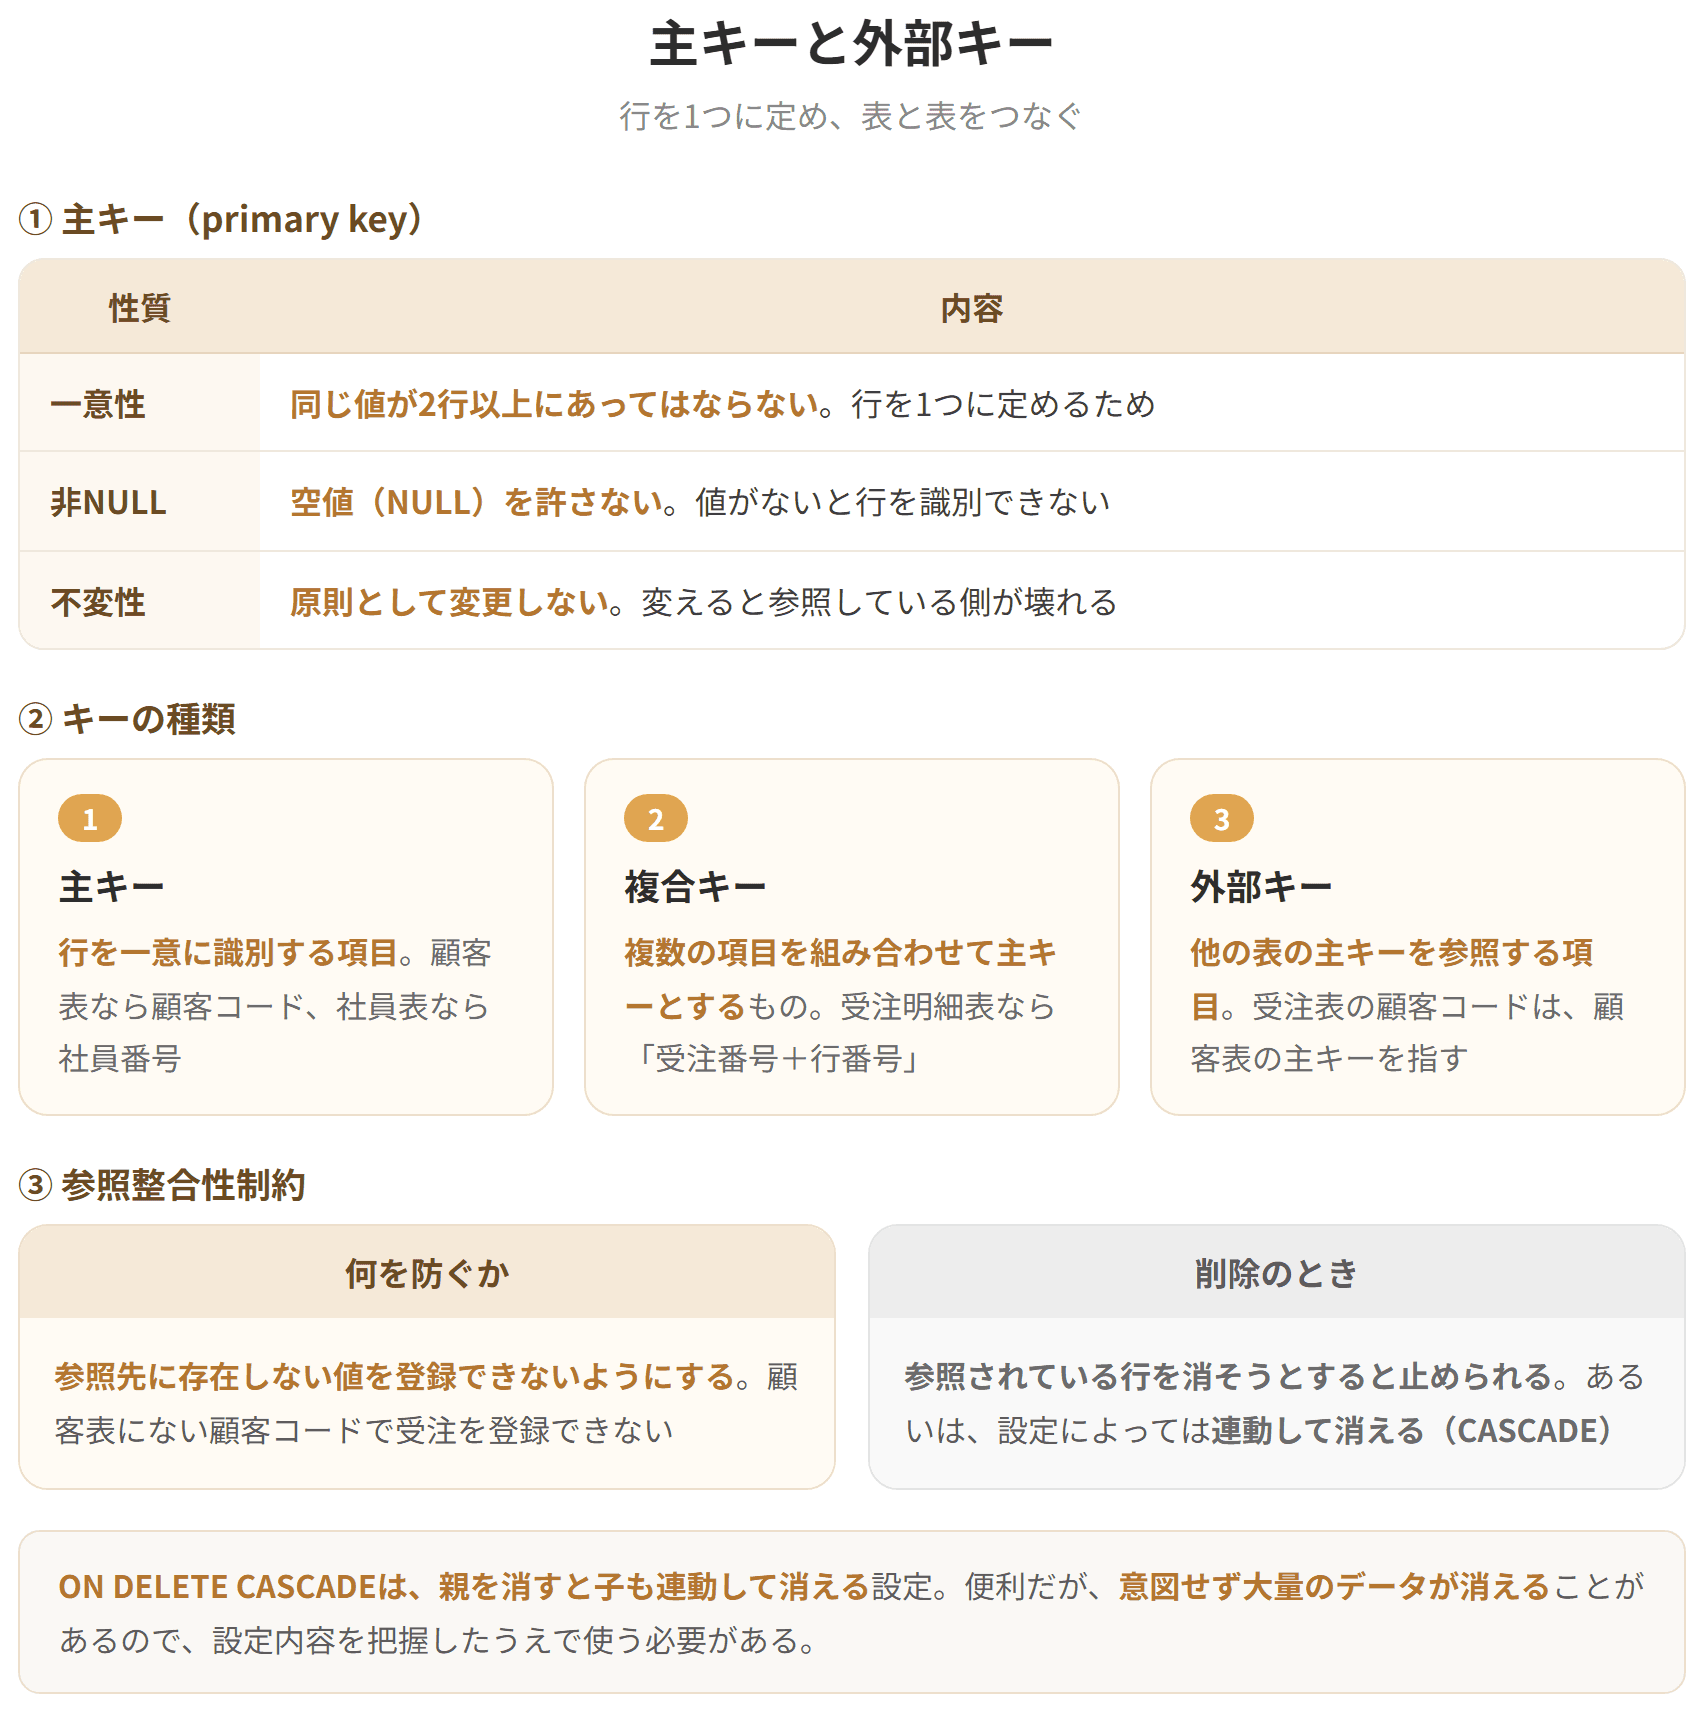
① 主キー
正規化を行う上で重要な概念となるのが、主キーと外部キーです。
主キーとは、その項目を選び出すとその行が一意に決まる項目を意味し、テーブルに含まれる各行を特定する番号やコードであることが多いものです。
「一意に決まる」とは、その値を指定すれば、該当する行がただ1つに決まるということです。社員番号が分かれば社員が1人に決まる、伝票番号が分かれば伝票が1枚に決まる——これが主キーの働きです。
② 主キーに課される2つの制約
主キーとなる項目には、次の制約が課されます。
| 制約 |
|---|
簡単にいうと
受注伝票を1枚、実際に正規化してみよう!非正規形から第3正規形まで、手を動かして追いかけるのが一番の近道。そして最後に、正規化のやりすぎにも代償があることを押さえておこう。
① 正規化のメリット
正規化を進めると、関連の強いデータが1つの表にまとまり、データの独立性が高まります。これにより、以下のようなメリットがあります。
② 正規化のデメリット
正規化を進めるとデータの独立性が高まりますが、処理効率の観点で以下のようなデメリットがあります。

動画・テキスト・過去問・AI添削まですべて網羅!
予備校代の1/10以下で、独学の不安をまるごと解決できます

 全7科目536節の解説動画539本・合計約41時間が見放題。連続再生・ブックマーク再生で、移動中も1本5分前後で進められます。プレミアム限定
 令和3〜7年度の1次過去問1,116問を、科目別・年度別に無制限で演習。問題の図・表と解説つきで、間違えた問題はマイページに残ります。プレミアム限定
 2次は事例I〜IVの114設問に何度でも書いて出せます。AIが設問ごとの基準で採点し、改善点は「どう書き直すか」の例と模範解答つき。プレミアム限定
 科目別のテキストPDFをダウンロードできます。印刷して書き込む、タブレットで持ち歩くなど、好きな使い方で。プレミアム限定
| HAVING <条件式> |
| グループに対する検索条件を指定する |
③ GROUP BY
表の各行は、GROUP BY句を指定することによりグループ化することができます。
GROUP BY句でグループ化する列名を指定すると、指定された列が同じ値の行は同一のグループとして扱われます。このようにグループ化された表をグループ表といい、グループ表はAVGなどの関数を用いて、グループごとに集計を行うことができます。
例
社員表を所属コードでグループ化し、その平均年齢を求めます。
```
SELECT 所属コード,AVG(年齢) FROM 社員表 GROUP BY 所属コード
```
| 所属コード | AVG(年齢) |
|---|---|
| 11 | 20 |
| 14 | 30 |
| 12 | 48 |
| 13 | 39 |
所属コード14には田中(32)と鈴木(28)がいるので、平均は30になります。
④ GROUP BYの重要な制約
> GROUP BY句を用いる場合、SELECT句に指定されているすべての非集約列(集合関数以外の列)は、必ずGROUP BY句で指定する列にも含めなければなりません。
なぜでしょうか。
> これは、グループ化されたグループ内に複数のレコードが存在する場合に、SELECT句でどのレコードを代表値として出力するかが一意に決まらずエラーになるからです。
たとえば所属コード14のグループには田中と鈴木の2人がいます。ここで `SELECT 所属コード, 社員名` と書いたら、社員名として田中と鈴木のどちらを表示すべきか決まりません。だからエラーになるのです。
別の視点でとらえると、GROUP BY句を用いる場合、SELECT句で指定できる列は「グループ化された列」と「集合関数を用いた列」に限定されることになります。
⑤ 代表的な集合関数
| 表記 | 意味 |
|---|---|
| MAX(列名) | グループごとに、その列のいちばん大きい値を返す |
| MIN(列名) | グループごとに、その列のいちばん小さい値を返す |
| COUNT(列名) | グループごとに、その列に行がいくつあるかを返す |
| AVG(列名) | グループごとに、その列の平均を返す |
| SUM(列名) | グループごとに、その列を全部足した値を返す |
第2章で学んだ表計算ソフトの関数と同じ名前が並んでいます。考え方も同じなので、あわせて覚えておくと効率的です。
⑥ COUNT関数の2つの書き方
COUNTは、行数を集計するための関数です。
| 書き方 | 数えるもの |
|---|---|
| COUNT(*) | 全行数 |
| COUNT(列名) | その列の値が「空白でない行の数」 |
なお、項目に値がない場合をNULL(ヌルまたはナルと読む)として表します。
例
成績表
| 学生番号 | 氏名 | クラス | 合計点 |
|---|---|---|---|
| 10011 | 石川 達也 | A | 220 |
| 10012 | 伊藤 大介 | A | 210 |
| 10027 | 牧野つくし | A | NULL |
| SQL | 結果 | 理由 |
|---|---|---|
| `SELECT COUNT(*) FROM 成績表` | 3 | 全行数を求めるため |
| `SELECT COUNT(合計点) FROM 成績表` | 2 | 空白でない行の数を求めるため |
この差は試験で問われます。「NULLは数えない」という点を押さえてください。
⑦ HAVING
HAVING句を指定すると、GROUP BY句でグループ化された各グループに対し、条件を満たすグループのみを抽出することができます。
HAVING句の機能はWHERE句の機能に類似しており、グループに対する選択処理であると捉えることができます。WHERE句が行を対象にしているのに対し、HAVING句はグループを対象にしています。
| 句 | 対象 |
|---|---|
| WHERE | 行 |
| HAVING | グループ |
例
社員表を所属コードでグループ化し、グループ内の行数が1を超えるグループの所属コードおよび平均年齢を求めます。
```
SELECT 所属コード, AVG(年齢) FROM 社員表
GROUP BY 所属コード HAVING COUNT(*)>1
```
| 所属コード | AVG(年齢) |
|---|---|
| 14 | 30 |
所属コード14だけが2人以上いるので、この1グループだけが残りました。
| ③ | GROUP BY | 所属コードでグループ化。11のグループ(太田)と14のグループ(鈴木)ができる |
| ④ | HAVING | グループを絞る。2人以上のグループは……どちらも1人なので、結果は0件 |
| ⑤ | SELECT | 列を取り出す |
この順番が要点
WHEREはグループ化の前、HAVINGはグループ化の後に働きます。だから、
という違いが生まれます。
誤った書き方の例
```
SELECT 所属コード, COUNT(*) FROM 社員表
WHERE COUNT(*) >= 2 ← エラー
GROUP BY 所属コード
```
WHERE句で集合関数を使っているのでエラーになります。グループごとの件数で絞りたいなら、HAVINGを使うのが正解です。
設例で確かめる——GROUP BY句の制約
> 次のSQLはエラーになる。理由を説明せよ。
> ```
> SELECT 所属コード, 社員名, AVG(年齢) FROM 社員表
> GROUP BY 所属コード
> ```
解答
SELECT句にある社員名が非集約列でありながら、GROUP BY句に含まれていないからです。
所属コード14のグループには田中と鈴木がいるため、社員名として何を表示すべきかが一意に決まりません。
正しく書くなら
| 目的 | 書き方 |
|---|---|
| 所属ごとの平均年齢だけほしい | `SELECT 所属コード, AVG(年齢) … GROUP BY 所属コード` |
| 社員名も出したい | `GROUP BY 所属コード, 社員名` とする(ただし1人ずつのグループになる) |
前のテーマの令和7年度の設例で、GROUP BY句に3つの列すべてを指定する選択肢が正解だったのも、この制約によるものです。「SELECT句の非集約列は、すべてGROUP BY句に書く」という一文を、確実に押さえておきましょう。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a HAVING句は行を対象とし、WHERE句はグループを対象とする。
> b COUNT(*)は全行数を、COUNT(列名)はその列が空白でない行の数を求める。
> c GROUP BY句を用いる場合、SELECT句で指定できる列はグループ化された列と集合関数を用いた列に限定される。
解答 a:× b:○ c:○
| SELECT <列名> | 抽出する列を指定する |
| FROM <表名> | 問い合わせ対象の表を指定する |
| WHERE <条件式> | 検索条件を指定する |
| ORDER BY <列名> [ASC または DESC] | 並び替えを行う列を指定する |
※ASC(Ascending)は昇順、DESC(Descending)は降順を意味し、省略した場合はASCが指定されたものとみなされます。
例
社員表を年齢の降順で並び替え、社員名および年齢を求めます。
```
SELECT 社員名,年齢 FROM 社員表 ORDER BY 年齢 DESC
```
| 社員名 | 年齢 |
|---|---|
| 佐藤 | 48 |
| 小林 | 39 |
| 田中 | 32 |
| 鈴木 | 28 |
| 太田 | 20 |
覚え方……ASCのAはAscend(上る)=小さい順。DESCはdescend(下る)=大きい順。省略したらASC(昇順)です。
② 列名や表名に別名をつける(AS)
SQL文において主に列名や表名を一時的に別名で参照や抽出する際に、AS句を用います。
SELECT句やFROM句でAS句を用いて「列名」や「表名」を別名にすることで、わかりやすい別名に変更できます。
また、FROM句内にAS句を用いて、同一の表を複数の別名の表に定義することで、同じテーブル内で関連するレコードを比較することがあります。
構文
```
SELECT <列名A> AS 新列名A, <列名B> AS 新列名B
FROM <表名> AS 新表名1, <表名> AS 新表名2
```
SELECT文より、「列名A」が「新列名A」となり、「列名B」が「新列名B」になります。また、同一の表を別名に定義することにより、一時的に2つの表(「新表名1」と「新表名2」)のように扱えます。
③ 結果の結合(UNION)
複数のSQL文の結果を結合して1つの結果(表)にするには、UNION句を用います。
基本的な記述方法は、2つのSELECT文をつなげるようにUNION句を書きます。ただし、複数のSQL文の結果を結合して1つの結果に表示するため、「列の数」や「同一列の型」が同じである必要があります。異なるとエラーになります。
構文
```
SELECT <列名> FROM <表名1>
UNION
SELECT <列名> FROM <表名2>
```
JOINとUNIONの違い
| JOIN | UNION | |
|---|---|---|
| つなぐ向き | 横(列が増える) | 縦(行が増える) |
| 必要な条件 | 結合条件(共通する列の値) | 列の数と型が同じ |
| 使う場面 | 顧客表と注文表を突き合わせる | 東日本の売上表と西日本の売上表をまとめる |
JOINは横、UNIONは縦——この一言で区別できます。
④ 条件分岐に応じた結果の処理(CASE式)
複数の条件分岐に応じてデータに個別の処理を加えるには、CASE式を用います。
CASEは、WHENとTHENおよびELSEを合わせて使用し、条件分岐(WHEN)とデータの個別処理(THEN)を行います。
WHERE句との違い
> WHERE句でも条件を指定してデータを絞り込むことはできますが、絞り込んだ条件に対しては何らかの処理を加えることはできません。一方、CASE式は複数の条件に応じて異なる処理をさせることができる点が大きな違いです。
WHENで指定する各条件は、相互に排他的である必要があります。
構文
```
CASE 列名 ←この列の値で枝分かれする
WHEN 条件A THEN 処理A ←条件Aに当てはまったら処理A
WHEN 条件B THEN 処理B ←条件Bに当てはまったら処理B
ELSE 処理C ←どれにも当てはまらなければ処理C
END
```
例
商品の価格を「高価格帯」「中価格帯」「低価格帯」に分類します。
```
SELECT 商品ID, 商品名, 価格,
CASE 価格
WHEN 価格 >= 1000 THEN '高価格帯'
WHEN 価格 >= 500 THEN '中価格帯'
ELSE '低価格帯'
END AS 価格帯
FROM 商品表;
```
商品表
| 商品ID | 商品名 | 価格 |
|---|---|---|
| 1 | ノートパソコン | 1200 |
| 2 | Tシャツ | 25 |
| 3 | スマートフォン | 800 |
| 4 | 靴 | 60 |
| 5 | タブレット | 400 |
出力結果
| 商品ID | 商品名 | 価格 | 価格帯 |
|---|---|---|---|
| 1 | ノートパソコン | 1200 | 高価格帯 |
| 2 | Tシャツ | 25 | 低価格帯 |
| 3 | スマートフォン | 800 | 中価格帯 |
| 4 | 靴 | 60 | 低価格帯 |
| 5 | タブレット | 400 | 低価格帯 |
最後の END AS 価格帯 は、CASE式で対象とした列を異なる名称の列名にするための記述です。CASE式とセットで用いられることが多くなっています。
⑤ WHENの順番に注意
上の例で、スマートフォン(800)は最初の条件(1000以上)を満たさず、2番目の条件(500以上)を満たすので「中価格帯」になります。
もし条件の順番を逆にして、
```
WHEN 価格 >= 500 THEN '中価格帯'
WHEN 価格 >= 1000 THEN '高価格帯'
```
と書くと、ノートパソコン(1200)も最初の条件(500以上)に該当してしまい、すべて「中価格帯」になってしまいます。CASE式は上から順に評価され、最初に一致した条件で確定するためです。
だからこそ「WHENで指定する各条件は、相互に排他的である必要がある」とされているのです。重なりがある条件を書くなら、厳しい条件から順に並べる必要があります。
具体例
UNIONを使った売上の集計
2つの受注表を1つにまとめる例です。
受注表A
| 取引ID | 商品番号 | 商品名 | 販売単価 | 販売数量 |
|---|---|---|---|---|
| Z001 | 101 | テレビ | 80,000 | 1 |
| Z002 | 102 | パソコン | 90,000 | 1 |
| Z003 | 103 | ラジオ | 10,000 | 2 |
| Z004 | 104 | 携帯電話 | 40,000 | 2 |
受注表B
| 取引ID | 商品番号 | 商品名 | 販売単価 | 販売数量 |
|---|---|---|---|---|
| Y001 | 105 | 冷蔵庫 | 70,000 | 1 |
| Y002 | 106 | 洗濯機 | 300,000 | 2 |
| Y003 | 107 | ドライヤー | 20,000 | 2 |
SQL
```
SELECT 取引ID, 商品番号, 商品名, 販売単価*販売数量 AS 合計金額
FROM 受注表A
UNION
SELECT 取引ID, 商品番号, 商品名, 販売単価*販売数量
FROM 受注表B
```
出力結果
| 取引ID | 商品番号 | 商品名 | 合計金額 |
|---|---|---|---|
| Z001 | 101 | テレビ | 80,000 |
| Z002 | 102 | パソコン | 90,000 |
| Z003 | 103 | ラジオ | 20,000 |
| Z004 | 104 | 携帯電話 | 80,000 |
ここで確認したい3点
1 列の計算とAS句
`販売単価*販売数量 AS 合計金額` という書き方で、その場で計算した結果に列名を付けています。表に「合計金額」という列は存在しませんが、問い合わせの結果には現れます。
第3正規化で「計算で求められる項目(導出項目)」を削除する、という話が後で出てきますが、削除しても必要なときにSQLで計算すればよい——ということが、この例から分かります。
2 AS句は最初のSELECTだけでよい
2つ目のSELECT文にはAS句がありません。列名は最初のSELECT文のものが使われるためです。
3 列の数と型をそろえる
両方とも4列で、それぞれの型も同じです。もし片方が3列だったり、文字列と数値が混ざっていたりすれば、エラーになります。
実務でUNIONが効く場面
| 場面 | なぜUNIONが要るか |
|---|---|
| 支店ごとに別の表で管理している売上を集計したい | 表が分かれているので縦につなぐ |
| 現行システムと旧システムのデータをまとめて見たい | 同上 |
| 複数の条件に該当するデータを1つのリストにしたい | 条件ごとにSELECTを書いてつなぐ |
ただし、そもそも表を分けるべきだったのかという設計上の問いも残ります。支店ごとに表を分けていること自体が、正規化の観点からは望ましくない場合もあります。UNIONを多用しているシステムは、設計を見直す余地があるという見方も覚えておくとよいでしょう。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a ORDER BY句でASCを省略した場合、降順が指定されたものとみなされる。
> b UNION句を用いるには、複数のSQL文の結果で列の数や同一列の型が同じである必要がある。
> c CASE式は、複数の条件に応じて異なる処理をさせることができる。
解答 a:× b:○ c:○
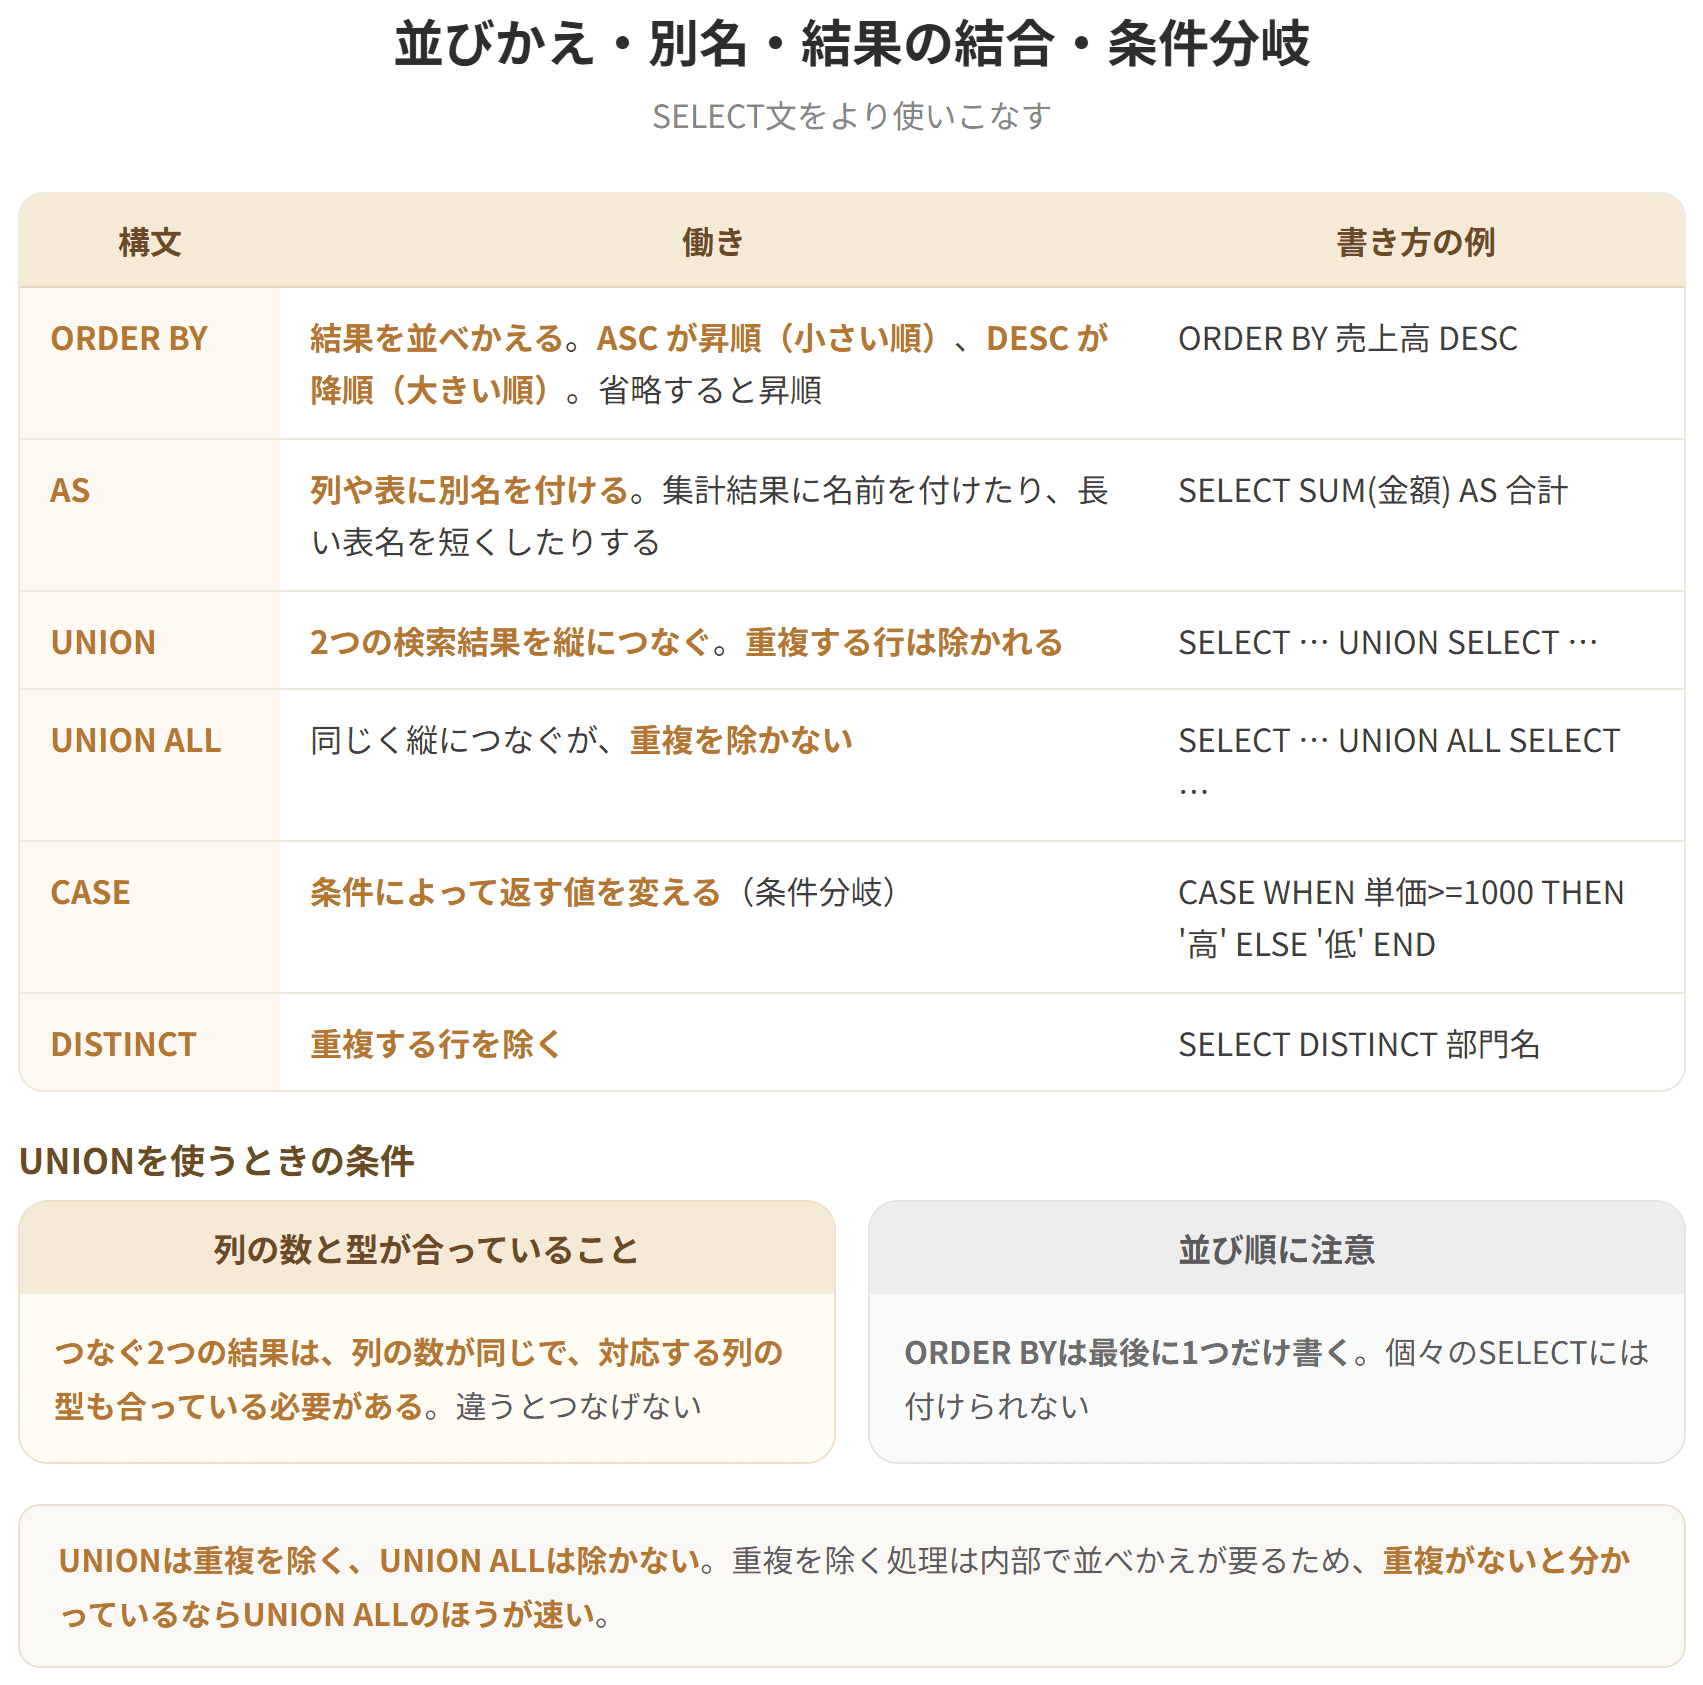
並びかえ・別名・結果の結合・条件分岐
試験のポイント
| 第1正規化 | 非正規形の表に現れる繰り返し項目※1を分離して、独立した行にすること |
| 第2正規化 | 主キーの一部だけから特定できる項目を別の表にすること※2 |
| 第3正規化 | 主キー以外の項目で特定できる項目を別の表にすること |
※1 繰り返し項目とは、1行における1項目に複数の値を含んでいる状態を指します。
※2 主キーが複合キーでない場合、第2正規化は不要となります(第1正規形を満たしていれば、そのまま第2正規形を満たしていることになります)。
③ 3段階を1行でまとめる
| 段階 | 何を取り除くか | ひとことで |
|---|---|---|
| 第1正規化 | 繰り返し項目 | 1マスに複数の値を入れない |
| 第2正規化 | 主キーの一部だけで決まる項目 | 複合キーの片方だけで決まる項目を追い出す |
| 第3正規化 | 主キー以外の項目で決まる項目 | 主キー以外から芋づる式に決まる項目を追い出す |
④ 正規形の条件(正規度が高い順に見る)
| 正規形 | 満たすべき条件 |
|---|---|
| 第1正規形 | 表内の行が、繰り返し項目をもたない |
| 第2正規形 | 主キーの一部に従属する項目が存在しない(AおよびBが主キー=複合キー) |
| 第3正規形 | 主キー以外の項目に従属する項目が存在しない(A、Bはそれぞれ主キー=単一キー) |
⑤ 「従属する」とは
「BがAに従属する」とは、Aの値が決まればBの値が1つに決まることをいいます。
たとえば「商品コード」が決まれば「商品名」と「単価」が決まります。このとき、商品名と単価は商品コードに従属している、といいます。
正規化の作業は、どの項目がどの項目に従属しているかを洗い出し、従属先ごとに表を分けることにほかなりません。
⑥ 第2正規化が不要な場合
※2の注記が重要です。
> 主キーが複合キーでない場合、第2正規化は不要となります。
第2正規化は「主キーの一部だけから特定できる項目」を追い出す作業です。主キーが1つの項目だけ(単一キー)であれば、そもそも「一部」というものが存在しません。したがって、第1正規形を満たしていれば自動的に第2正規形も満たしていることになります。
この点は、令和7年度の本試験で「主キーが複合キーではないため、第2正規形を満たしている」という形で問われました。
⑦ 正規度の向き
正規化を進めるほど表の数は増え、1つの表に含まれる項目は減っていきます。表の数が増えることは、欠点ではなく正規化が進んだ証です。ただし、次で見るとおり、それに伴う代償もあります。
具体例
設例 開講講座の一覧はどの正規形か
> 以下に示す表は、ある学校における特定の期間中の開講講座の一覧である。この表の正規化に関する記述の正誤を判定せよ。なお、この表の主キーは「開講コード」であり、また、それぞれの講師は開講コードの異なる同一名の講座を担当することがある。(令和7年度第11問 改題)
| 開講コード | 講座コード | 講座名 | 講師コード | 講師 |
|---|---|---|---|---|
| MIS01 | C01 | 経営情報システム入門 | T01 | 中小 太郎 |
| MIS02 | C01 | 経営情報システム入門 | T01 | 中小 太郎 |
| MIS03 | C01 | 経営情報システム入門 | T02 | 診断 次郎 |
| MIS04 | C01 | 経営情報システム入門 | T02 | 診断 次郎 |
| MIS05 | C01 | 経営情報システム入門 | T03 | 連合 三郎 |
| MIS06 | C01 | 経営情報システム入門 | T03 | 連合 三郎 |
| MIS07 | C02 | 経営情報システム実践 | T01 | 中小 太郎 |
| MIS08 | C02 | 経営情報システム実践 | T02 | 診断 次郎 |
| MIS09 | C02 | 経営情報システム実践 | T03 | 連合 三郎 |
> a 第1正規形である。
> b 第2正規形である。
> c 第3正規形である。
解答 a:○ b:○ c:×
cを図で確かめる
主キーは「開講コード」です。開講コードが決まれば、講座コード・講座名・講師コード・講師のすべてが決まります。ここまでは問題ありません。
ところが、それとは別に、
という主キー以外の項目への従属が存在します。第3正規形の条件は「主キー以外の項目に従属する項目が存在しない」ことなので、これを満たしていません。
第3正規化するとどうなるか
| 開講コード | 講座コード | 講師コード |
|---|---|---|
| MIS01 | C01 | T01 |
| MIS02 | C01 | T01 |
| … | … | … |
講座表
| 講座コード | 講座名 |
|---|---|
| C01 | 経営情報システム入門 |
| C02 | 経営情報システム実践 |
講師表
| 講師コード | 講師 |
|---|---|
| T01 | 中小 太郎 |
| T02 | 診断 次郎 |
| T03 | 連合 三郎 |
何が改善したか
元の表では「経営情報システム入門」という文字列が6回、「中小 太郎」が3回も繰り返し書かれていました。分離後はそれぞれ1回だけです。
講師が改名したり、講座名を変更したりするとき、分離前ならすべての行を直す必要があり、直し漏れがあればデータが食い違います。分離後は1行を直すだけで済みます。これが「冗長性をなくし、一貫性と整合性を図る」ということの中身です。
判定の手順をまとめる
| 見るところ | 判定 |
|---|---|
| 1マスに複数の値が入っていないか | 入っていなければ第1正規形 |
| 主キーは複合キーか | 単一キーなら第2正規形は自動的に満たす |
| 主キー以外から決まる項目はないか | なければ第3正規形 |
「〜コード」という列が2つ以上ある表は、第3正規形を満たしていない可能性が高い——この着眼点を持っておくと、判定が速くなります。
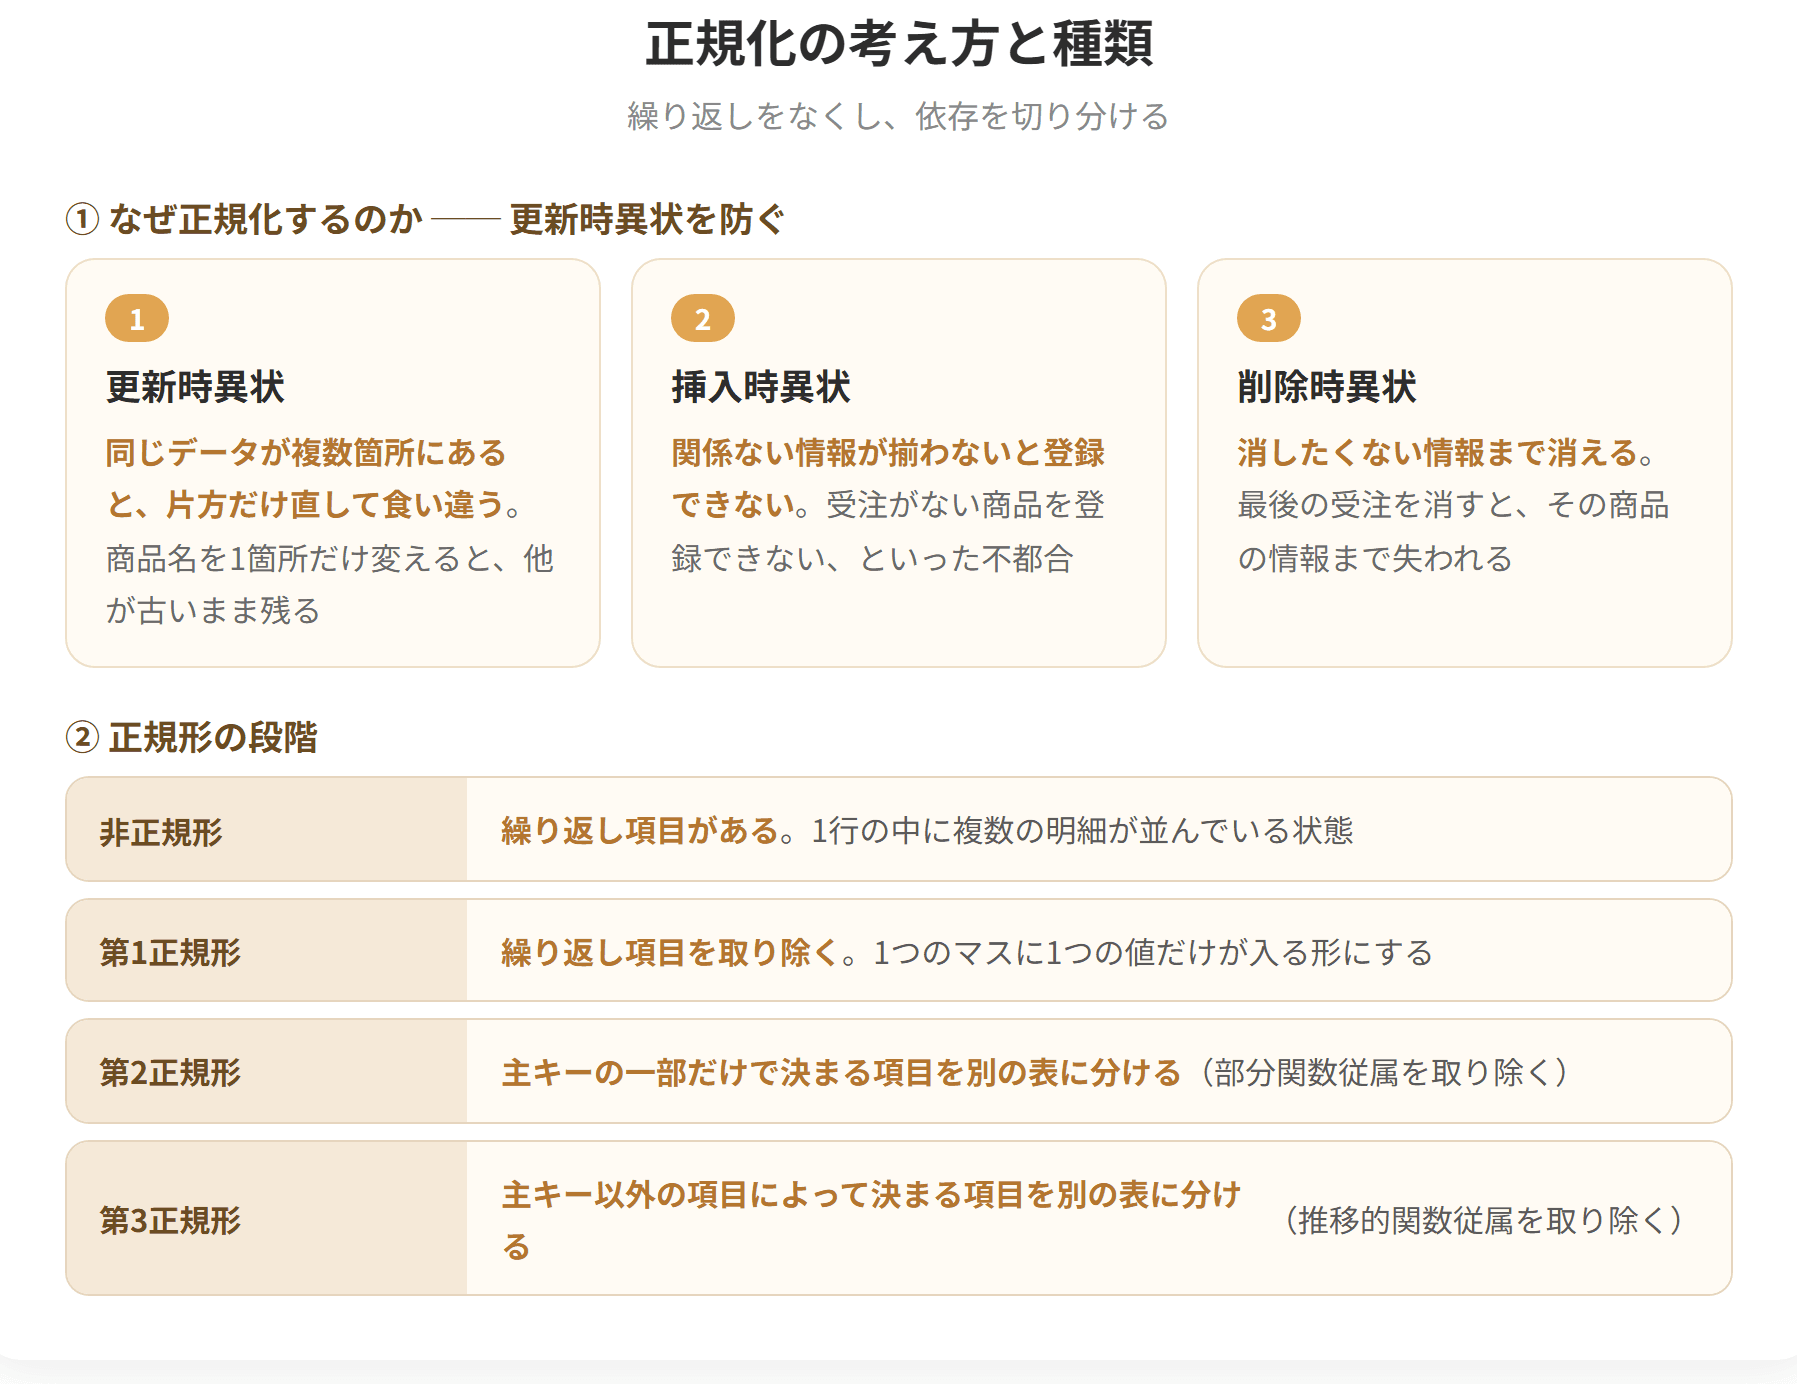
正規化の考え方と種類(1/2)
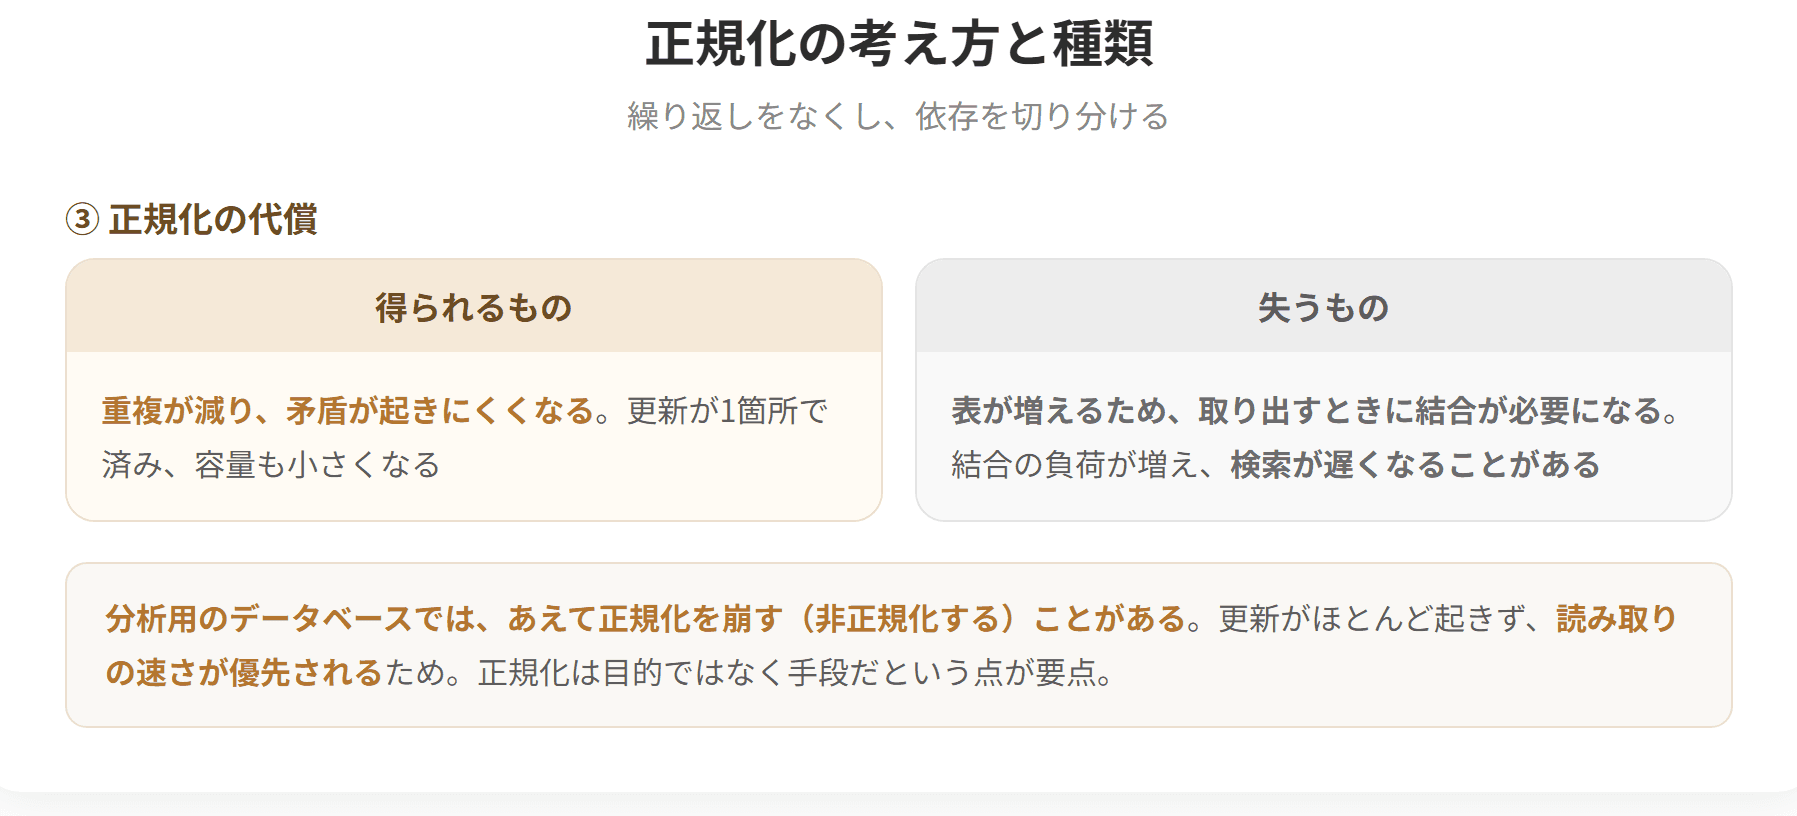
正規化の考え方と種類(2/2)
試験のポイント
| 内容 |
|---|
| 一意性制約 | テーブル内で重複したデータが存在しないこと |
| NOT NULL制約 | 該当項目が空値でないこと |
なぜこの2つが必要なのか
どちらも「行を一意に特定する」という主キーの役割から導かれる、当然の要請です。
③ 単一キーと複合キー
主キーは1つの項目から成ることもあれば(単一キー)、複数の項目から成ることもあります(複合キー)。
| 種類 | 例 |
|---|---|
| 単一キー | 社員表の「社員コード」 |
| 複合キー | 受注明細表の「受注番号」+「商品コード」 |
複合キーが必要になるのは、1つの項目だけでは行が特定できない場合です。受注明細表では、同じ受注番号の行が複数あり(1件の受注で複数の商品を注文するため)、同じ商品コードの行も複数あります(別の受注で同じ商品を注文するため)。2つを組み合わせて初めて1行が決まります。
前のテーマとのつながり……主キーが複合キーかどうかで、第2正規化が必要かどうかが決まります。主キーを特定する作業は、正規化の出発点です。
④ 主キーを見つけるコツ
> 主キーを特定するには、表で管理される情報に「ID」「コード」「番号」などを付加した項目名を探すとよい。
さらに、その項目の具体的な値を見て、各行で値が重複していないかを確かめます。重複していれば、その項目だけでは主キーになれず、他の項目と組み合わせた複合キーになります。
⑤ 外部キー
ある表Aの主キーの項目が別の表Bの項目となるような場合、表Bの項目を外部キーといいます。つまり、他の表の主キーを参照する項目が外部キーとなります。
例
表A(主キー:伝票番号)
| 伝票番号 | 日付 | … |
|---|---|---|
| 0001 | 11/1 | … |
| 0002 | 11/3 | … |
表B(外部キー:伝票番号)
| 顧客番号 | 伝票番号 | 商品番号 | … |
|---|---|---|---|
| 1010 | 0001 | TV29 | … |
| 1103 | 0002 | PC08 | … |
表Bに含まれる「伝票番号」と、表Aの主キーである「伝票番号」が同じ項目となっています。この場合、表Bの「伝票番号」は、表Aを参照するための外部キーとして設定できます。
⑥ 参照制約
このように外部キーを設定した場合、次のような制約が課されます。これを参照制約といいます。
2つ目が実務上とくに重要です。
たとえば、まだ受注明細が残っている商品を商品表から削除しようとすると、参照制約によって拒否されます。もし削除できてしまえば、受注明細に「存在しない商品コード」が残り、どの商品を注文したのか分からない状態になってしまいます。
参照制約は、データの整合性をDBMSが自動的に守ってくれる仕組みです。アプリケーションが削除の前にチェックする必要がなくなります。第2節で学んだ「本質でない作業をDBMSに任せる」の一例といえます。
⑦ 主キーと外部キーの関係を図で
第2節で学んだ結合は、この主キーと外部キーの対応関係を使って表をつなぐ操作です。正規化で表を分け、主キーと外部キーでつながりを残し、結合で必要なときに元の形に戻す——この3つが一体の仕組みになっています。
具体例
主キーを探す練習——受注の表から
次の第1正規形の表から、主キーを特定してみましょう。
| 受注番号 | 受注日 | 顧客コード | 顧客名 | 顧客住所 | 顧客電話番号 | 商品コード | 商品名 | 単価 | 数量 | 金額 |
|---|---|---|---|---|---|---|---|---|---|---|
| H151 | 01/25 | 1 | ○商事 | 中央区… | ○○○ | SA1 | A | 200 | 90 | 18,000 |
| H151 | 01/25 | 1 | ○商事 | 中央区… | ○○○ | SC4 | C | 135 | 60 | 8,100 |
| H152 | 01/26 | 5 | △機器 | 品川区… | △△△ | SA1 | A | 200 | 50 | 10,000 |
| H152 | 01/26 | 5 | △機器 | 品川区… | △△△ | SB3 | B | 100 | 35 | 3,500 |
| H152 | 01/26 | 5 | △機器 | 品川区… | △△△ | SD2 | D | 400 | 8 | 3,200 |
手順1:「ID」「コード」「番号」を含む項目を探す
受注番号、顧客コード、商品コードの3つが候補です。
手順2:その項目だけで行が決まるかを確かめる
| 候補 | 値の重複 | 単独で主キーになれるか |
|---|---|---|
| 受注番号 | H151が2行、H152が3行 | なれない |
| 顧客コード | 1が2行、5が3行 | なれない |
| 商品コード | SA1が2行 | なれない |
与えられた表は受注情報を管理するものであり、「受注番号」という項目が含まれています。「受注番号」の具体的な値を見ると、各行で値が重複しているため、「受注番号」と他の項目を併せた複合キーが主キーになることがわかります。
手順3:組み合わせを試す
続いて「受注番号」以外で「ID」「コード」「番号」などが含まれる項目について、「受注番号」が同一の行において値が異なるものを探してみます。
すると、「受注番号」と「商品コード」を併せると受注表の1行を特定できることがわかります。よって、主キーは「受注番号」および「商品コード」(複合キー)となります。
検算してみる
| 受注番号 | 商品コード | 該当する行 |
|---|---|---|
| H151 | SA1 | 1行目のみ |
| H151 | SC4 | 2行目のみ |
| H152 | SA1 | 3行目のみ |
| H152 | SB3 | 4行目のみ |
| H152 | SD2 | 5行目のみ |
どの組み合わせも1行に決まります。主キーとして正しいことが確認できました。
この作業が正規化の土台になる
主キーが「受注番号+商品コード」という複合キーだと分かったので、第2正規化が必要になります。次のテーマで、この表を実際に分解していきます。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 主キーとなる項目には、一意性制約とNOT NULL制約が課される。
> b 外部キーとは、他の表の主キーを参照する項目である。
> c 参照制約により、表Aから行を削除する際に、表Bから参照されている行も自動的に削除される。
解答 a:○ b:○ c:×
主キーと外部キー
試験のポイント
③ トレードオフとして理解する
| 正規化を進める | 正規化を抑える | |
|---|---|---|
| データの一貫性 | 高い | 低い(更新漏れの危険) |
| 表の数 | 多い | 少ない |
| 参照時の処理 | 結合が増えて遅い | 速い |
| 更新時の処理 | 1か所で済み速い | 複数か所を直す必要 |
更新には強く、参照には弱い——これが正規化された設計の性格です。
実務では、あえて正規化を崩す(非正規化する)こともあります。たとえば、頻繁に参照される集計値をあらかじめ表に持たせておく、といった手法です。ただしその場合、更新時に整合性を保つ仕組みを自分で用意しなければなりません。
④ 正規化の例——受注伝票を電子化する
紙面で運用していた受注伝票を電子化し、各データ項目をデータベースで管理する場合の正規化を追いかけます。
受注伝票のイメージ
> 受注番号 H151 受注日 1/25
> 顧客コード 1 顧客名 ○商事
> 住所 中央区… 電話番号 ○○○ 合計額 26,100円
>
> | 商品コード | 商品名 | 単価 | 数量 | 金額 |
> |---|---|---|---|---|
> | SA1 | A | 200 | 90 | 18,000 |
> | SC4 | C | 135 | 60 | 8,100 |
⑤ 非正規形
受注伝票からデータ項目を抜粋し、表として整理すると次のようになります。
| 受注番号 | 受注日 | 顧客コード | 顧客名 | 顧客住所 | 顧客電話番号 | 商品コード | 商品名 | 単価 | 数量 | 金額 |
|---|---|---|---|---|---|---|---|---|---|---|
| H151 | 01/25 | 1 | ○商事 | 中央区… | ○○○ | SA1/SC4 | A/C | 200/135 | 90/60 | 18,000/8,100 |
| H152 | 01/26 | 5 | △機器 | 品川区… | △△△ | SA1/SB3/SD2 | A/B/D | … | … | … |
商品コードや商品名などに、1行における1項目に複数の値を含む繰り返し項目が存在するため、正規化されていない表(非正規形)であるといえます。
リレーショナルデータベースでは、非正規形の表を登録することができないため、正規化を進める必要があります。
⑥ 第1正規形
非正規形の表に現れる繰り返し項目を分離して、独立した行にします。第1正規形のデータは、1行における1項目に1つの値が入るようになります。
〈売上表1〉
| 受注番号 | 受注日 | 顧客コード | 顧客名 | 顧客住所 | 顧客電話番号 | 商品コード | 商品名 | 単価 | 数量 | 金額 |
|---|---|---|---|---|---|---|---|---|---|---|
| H151 | 01/25 | 1 | ○商事 | 中央区… | ○○○ | SA1 | A | 200 | 90 | 18,000 |
| H151 | 01/25 | 1 | ○商事 | 中央区… | ○○○ | SC4 | C | 135 | 60 | 8,100 |
| H152 | 01/26 | 5 | △機器 | 品川区… | △△△ | SA1 | A | 200 | 50 | 10,000 |
| H152 | 01/26 | 5 | △機器 | 品川区… | △△△ | SB3 | B | 100 | 35 | 3,500 |
| H152 | 01/26 | 5 | △機器 | 品川区… | △△△ | SD2 | D | 400 | 8 | 3,200 |
繰り返し項目は消えましたが、そのかわり受注日や顧客名が何度も繰り返されていることに注目してください。これを解消するのが次の段階です。
⑦ 第2正規形
前のテーマで確かめたとおり、主キーは「受注番号」および「商品コード」(複合キー)です。
次に、主キーの一部である「受注番号」または「商品コード」のみに従属している項目を探すと、
| 従属先 | 従属する項目 |
|---|---|
| 受注番号 | 受注日、顧客コード、顧客名、顧客住所、顧客電話番号 |
| 商品コード | 商品名、単価 |
が紐付いていることがわかります。これらの項目を売上表1から分離した結果が第2正規形となります。
〈受注表〉
| 受注番号 | 受注日 | 顧客コード | 顧客名 | 顧客住所 | 顧客電話番号 |
|---|---|---|---|---|---|
| H151 | 01/25 | 1 | ○商事 | 中央区… | ○○○ |
| H152 | 01/26 | 5 | △機器 | 品川区… | △△△ |
〈商品表〉
| 商品コード | 商品名 | 単価 |
|---|---|---|
| SA1 | A | 200 |
| SB3 | B | 100 |
| SC4 | C | 135 |
| SD2 | D | 400 |
〈受注明細表〉
| 受注番号 | 商品コード | 数量 | 金額 |
|---|---|---|---|
| H151 | SA1 | 90 | 18,000 |
| H151 | SC4 | 60 | 8,100 |
| H152 | SA1 | 50 | 10,000 |
| H152 | SB3 | 35 | 3,500 |
| H152 | SD2 | 8 | 3,200 |
5行あった表が、2行・4行・5行の3つの表に分かれました。顧客名が何度も繰り返されていた状態が解消されています。
⑧ 第3正規形
第3正規化では、第2正規形において、主キー以外で「ID」「コード」「番号」などを含む項目に注目するとよいでしょう。「顧客コード」がその候補となります。
「顧客コード」に従属する項目を探すと、「顧客名」「顧客住所」「顧客電話番号」が紐付いているのがわかります。これらの項目を受注表から分離した結果が第3正規形となります。
また、第3正規化では計算で求められる項目(導出項目)の削除も行います。受注明細表の「金額」項目が該当するため、この項目を削除します。
〈受注表〉
| 受注番号 | 受注日 | 顧客コード |
|---|---|---|
| H151 | 01/25 | 1 |
| H152 | 01/26 | 5 |
〈顧客表〉
| 顧客コード | 顧客名 | 顧客住所 | 顧客電話番号 |
|---|---|---|---|
| 1 | ○商事 | 中央区… | ○○○ |
| 5 | △機器 | 品川区… | △△△ |
〈商品表〉
| 商品コード | 商品名 | 単価 |
|---|---|---|
| SA1 | A | 200 |
| SB3 | B | 100 |
| SC4 | C | 135 |
| SD2 | D | 400 |
〈受注明細表〉
| 受注番号 | 商品コード | 数量 |
|---|---|---|
| H151 | SA1 | 90 |
| H151 | SC4 | 60 |
| H152 | SA1 | 50 |
| H152 | SB3 | 35 |
| H152 | SD2 | 8 |
⑨ 導出項目を削除する理由
「金額」は「単価×数量」で計算できます。表に持っておくと、
という問題が生じます。必要なときにSQLで `単価*数量 AS 金額` と計算すればよいので、持たないほうが安全です。
なお「合計額 26,100円」も導出項目です。受注明細から計算できるので、表には持ちません。
具体例
設例 受注管理表を正規化する
> 以下に示す受注管理表を正規化した構造として、最も適切なものを選べ。ただし、単価は商品コードによって一意に定まるものとする。(令和6年度第7問 改題)
| 受注番号 | 受注日 | 得意先コード | 商品コード | 受注数量 | 単価 | 合計金額 |
|---|---|---|---|---|---|---|
| 10001 | 2024-04-01 | 3011 | A/B/C | 5/1/2 | 1000/2000/3000 | 13000 |
| 10002 | 2024-04-01 | 1022 | B/C | 4/1 | 2000/3000 | 11000 |
| 10003 | 2024-04-02 | 2033 | A/C | 6/3 | 1000/3000 | 15000 |
> ア [受注番号, 受注日, 得意先コード, 合計金額][商品コード, 単価][受注番号, 商品コード, 受注数量]
解答 ア
解く手順
第1正規化は、表中に現れる繰り返し項目を分離して独立した行にすることです。繰り返し項目とは、1行における1項目に複数の値を含んでいる状態を指します。与えられた表は商品コード・受注数量・単価に繰り返し項目が存在するため、第1正規化を行う必要があります。
第2正規化は、主キーの一部だけから特定できる項目を別の表にすることです。
第1正規化した表の主キーは「受注番号」と「商品コード」の複合キーになります。ここで、
| 従属先 | 従属する項目 |
|---|---|
| 受注番号だけで決まる | 受注日、得意先コード、合計金額 |
| 商品コードだけで決まる | 単価(問題文に「単価は商品コードによって一意に定まる」と明記) |
| 両方そろって決まる | 受注数量 |
したがって3つの表に分かれます。
| 表 | 列 |
|---|---|
| 受注表 | 受注番号, 受注日, 得意先コード, 合計金額 |
| 商品表 | 商品コード, 単価 |
| 受注明細表 | 受注番号, 商品コード, 受注数量 |
これが選択肢アの構造です。
他の選択肢が誤りである理由
| 選択肢 | 誤りの内容 |
|---|---|
| イ | 「得意先コード, 商品コード, 単価」——単価は商品コードだけで決まるので、得意先コードは不要 |
| ウ | 受注明細が「得意先コード, 商品コード, 受注数量」——受注番号でなく得意先コードになっており、同じ得意先の別の受注を区別できない |
| エ | 受注表が分裂しすぎており、受注番号と受注日が別表になっている |
| オ | 受注明細が「受注番号, 得意先コード, 受注数量」——商品コードがないので、どの商品を何個注文したか分からない |
判定のコツ
受注明細にあたる表が「受注番号+商品コード+数量」になっているかを最初に確認すると、選択肢を一気に絞れます。この3つがそろっていない選択肢(ウ、オ)は、その時点で外せます。
問題文のヒントを見逃さない
「ただし、単価は商品コードによって一意に定まるものとする」——この一文が、単価をどの表に置くかを決めています。もしこの条件がなければ、「得意先ごとに単価が違う」という可能性が残り、単価は「得意先コード+商品コード」で決まることになります(選択肢イの構造)。
正規化の問題では、従属関係が問題文に明記されていることが多くあります。表だけを眺めるのではなく、条件文を先に読むことが、確実に正解するための近道です。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 正規化を進めると、表の種類や数が増加し、データを参照する際の結合処理が増える。
> b 第3正規化では、計算で求められる項目(導出項目)の削除も行う。
> c 正規化を進めると、更新漏れの可能性が高まる。
解答 a:○ b:○ c:×
正規化プロセス(非正規形→第3正規形)
試験のポイント

 科目別の正答率と連続学習日数がマイページに出るので、次にどの科目をやるかで迷いません。プレミアム限定
プレミアムプラン
¥9,800〜/ 買い切り・自動更新なし(税込)
決済はStripe(世界最高水準・PCI-DSS準拠)で安全に処理されます。カード情報は当サービスに保存されません。
| Y004 |
| 108 |
| 電子レンジ |
| 15,000 |
| 1 |
| Y001 |
| 105 |
| 冷蔵庫 |
| 70,000 |
| Y002 | 106 | 洗濯機 | 600,000 |
| Y003 | 107 | ドライヤー | 40,000 |
| Y004 | 108 | 電子レンジ | 15,000 |
開講表
