データベース
下の動画はこの節の解説ではありません。 解説動画の雰囲気を知っていただくための見本として、「AI・機械学習」の動画を再生します。
この節の解説動画はプレミアム限定です。プレミアムなら全科目・全節が見放題!
プレミアムで見る今日では、さまざまなデータをコンピュータで管理しています。データベースとは、データの蓄積や検索を容易にするための仕組みです。データベースを作成すると、データを集中管理し、さまざまな目的に応じてデータを取り出して利用することができます。この節では、データの格納方法による分類を順に見ていきます。試験の主役は行と列の表で表すリレーショナルデータベースですが、近年はビッグデータの扱いを念頭に置いた新しい方式も出題されるようになりました。令和4年度にはカラムナー・インメモリ・NoSQL・リポジトリがまとめて問われています。それぞれが「何を速くするために生まれたのか」という観点で整理していきましょう。


簡単にいうと
データベースの世界は、表・SQL・正規化の3点セットで回っているの。まずは全体の地図を頭に入れて、そのうえで主役のリレーショナルデータベースを見ていこう!
① データベースとは
データベースとは、データの蓄積や検索を容易にするための仕組みです。データベースを作成すると、データを集中管理し、さまざまな目的に応じてデータを取り出して利用することができます。
集中管理することの意味は、実務に照らすと分かりやすくなります。顧客の住所が営業部の名簿と請求部門の台帳に別々に書かれていれば、片方だけ更新されて食い違う、ということが起こります。1か所にまとめておけば、こうした矛盾は生じません。
② この章で学ぶことの地図
データベースの学習は、次の3つの要素が絡み合っています。
| 要素 | 内容 | 学ぶ節 |
|---|---|---|
| 表(テーブル) | データベース内には、複数の表(顧客表、商品表など)がある | 第1節・第2節 |
| SQL | データを自由に利用する手段 | 第5節・第6節 |
| 正規化 |
具体例
なぜリレーショナルデータベースが主流になったのか
3つの方式を、店の商品台帳にたとえて比べてみましょう。
| 方式 | たとえ | つなぎ方 |
|---|---|---|
| 階層型 | 章立てされた本。目次から章、章から節へたどる | ポインタ(位置を指す) |
| ネットワーク型 | 索引が縦横に張られた本 | ポインタ(複数の親を持てる) |
| リレーショナル型 | 表が並んだ帳簿。共通の番号で照合する | 値そのもの |
ポインタでつなぐ方式の弱点
階層型やネットワーク型では、データ同士のつながりがあらかじめ配線として作り込まれています。この配線は、登録時に決めた取り出し方には非常に速いのですが、後から「こういう見方でデータを取り出したい」という要望が出ると、配線をやり直すことになります。
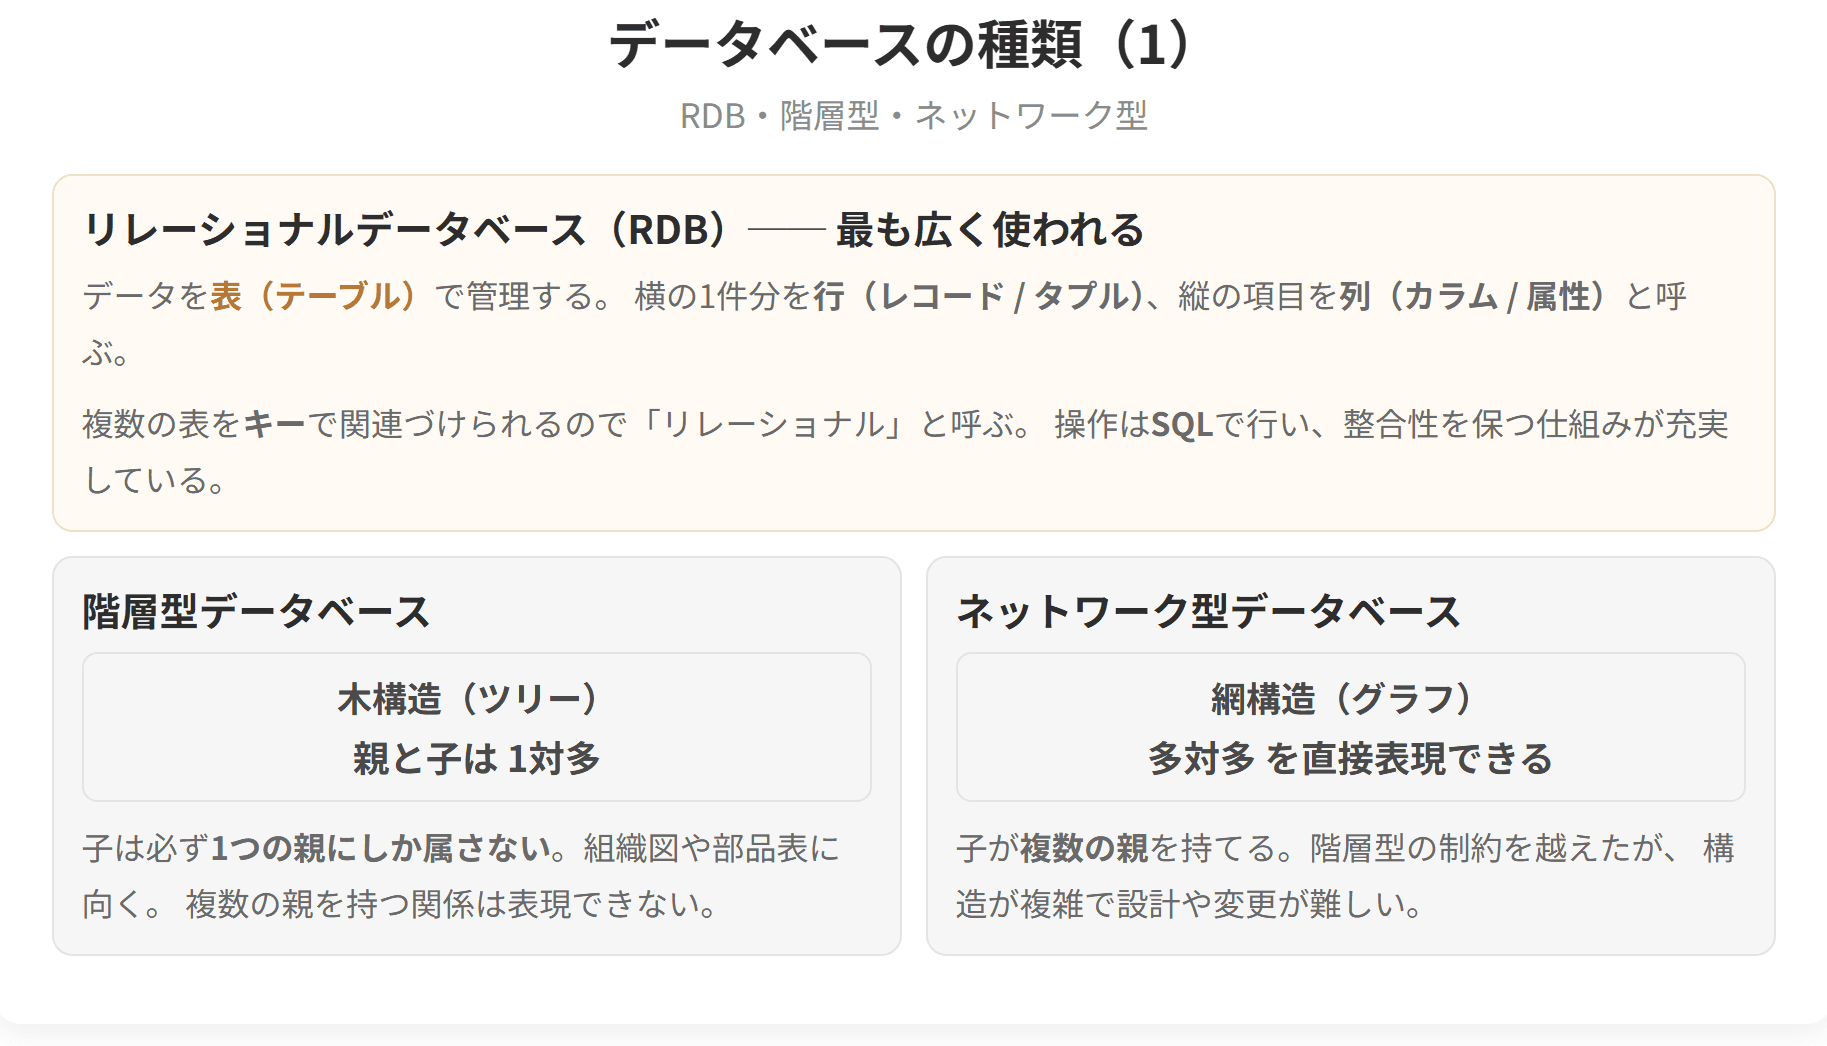
データベースの種類(1)

試験のポイント

簡単にいうと
この2つの違いは「子が親を何人持てるか」だけ!階層型は1人だけ、ネットワーク型は複数OK。だから片方は木、もう片方は網の目になるんだ。
① 階層型データベース
階層型データベースは、レコード間の相互関係をポインタを用いて木構造(親子関係)で表し、親レコードと子レコードの関係は1:nであるデータベースです。
ポインタとは、あるデータが別のデータの位置を指し示す情報のことです。「次はここを見よ」という矢印だと考えてください。
1:nという表記は、1つの親が複数(n個)の子を持つことを表します。逆にいえば、子レコードは1つの親レコードしか持たないということです。
例
学校のデータを階層型で表すと、次のようになります。
簡単にいうと
リレーショナルデータベースは万能じゃない。大量のデータをものすごい速さで出し入れしたい場面では、表の作法が足かせになるんだ。そこで登場したのが、この仲間たち!
① キーバリューデータベース
キーバリューデータベースとは、データを識別するためのキーとデータの値をペアにして多様なデータを格納・管理するデータベースです。
通常のRDBのように管理するデータの構造(表の関連性)や属性(表の定義)などスキーマ設計は必要としません。
データ管理の簡易さから、データの記録および検索を高速で行うことができ、大量のデータを扱えるため、ビッグデータに適したデータベースといわれます。
イメージ
日々の天気を記録する場合、次のようになります。
| キー(日付) |
|---|
簡単にいうと
ディスクに行くのが遅いなら、全部メモリに置いてしまえ——それがインメモリデータベース。でも電源が切れたら消えちゃう。その対策までがセットで問われるよ!
① インメモリデータベース
インメモリデータベースは、データを全てメインメモリ上に格納する方式で構築されたデータベースです。
ディスク(補助記憶装置)にアクセスする必要がないので、応答時間を最小限にすることが可能になります。
② なぜ速いのか——第1章の知識で説明する
第1章で学んだ記憶装置の階層を思い出してください。
| 階層 | 速度 |
|---|---|
| 主記憶装置(DRAM) |

動画・テキスト・過去問・AI添削まですべて網羅!
予備校代の1/10以下で、独学の不安をまるごと解決できます

 全7科目536節の解説動画539本・合計約41時間が見放題。連続再生・ブックマーク再生で、移動中も1本5分前後で進められます。プレミアム限定
 令和3〜7年度の1次過去問1,116問を、科目別・年度別に無制限で演習。問題の図・表と解説つきで、間違えた問題はマイページに残ります。プレミアム限定
 2次は事例I〜IVの114設問に何度でも書いて出せます。AIが設問ごとの基準で採点し、改善点は「どう書き直すか」の例と模範解答つき。プレミアム限定
 科目別のテキストPDFをダウンロードできます。印刷して書き込む、タブレットで持ち歩くなど、好きな使い方で。プレミアム限定
| 第6節 |
「正規化された表を作り、SQLで取り出す」——これがデータベースの基本の姿です。この章では、この一文を細かく分解していきます。
③ リレーショナルデータベース(RDB:Relational DataBase)
リレーショナルデータベースとは、行(レコード)と列(カラム)という2次元の表(テーブル)形式で各データの関係を表現するデータベースを指します。関係データベースともよばれます。
最も主流なデータベースのひとつであり、試験上、特段の指定がない限り、リレーショナルデータベースが前提であると考えてよいでしょう。
④ 表・行・列の呼び名
| 用語 | 別名 | 意味 |
|---|---|---|
| 表 | テーブル | データを格納する2次元の入れ物 |
| 行 | レコード | 表の横1列。1件ぶんのデータ |
| 列 | カラム | 表の縦1列。1つの項目 |
たとえば受講生の表であれば、次のようになります。
| 受講生ID | 受講生名 | 教室 | 開始月日 |
|---|---|---|---|
| 10110001 | 小林 太郎 | 水道橋 | 04/01 |
| 10110002 | 中山 リサ | 池袋 | 04/01 |
| 10110003 | 伊藤 一 | 水道橋 | 09/01 |
| 10110004 | 渡辺 花子 | 大阪 | 12/01 |
⑤ 「関係(リレーション)」の意味
リレーショナルデータベースの「リレーション」は、表と表の関係を指すと説明されることが多いのですが、もともとは数学の関係(relation)の概念に由来しています。
実務的には、複数の表を、それぞれの表の中の値を使って関連付けるという点を押さえておけば十分です。たとえば受講生の表に「教室」という列があり、別に教室の表があれば、「教室」の値を手がかりに2つの表をつなげられます。
この「値でつなげる」という点が、次に学ぶ階層型やネットワーク型との決定的な違いです。それらはポインタ(データの位置を指し示す情報)でつなぎますが、リレーショナルデータベースは値そのものでつなぎます。
値でつなぐ方式の強み
リレーショナルデータベースは、配線をあらかじめ持ちません。取り出すときに「この列の値が一致する行どうしをつなげ」と指示します。だから、
という柔軟さが得られます。業務の要望が変わり続ける企業システムにとって、この柔軟さが決定的だったというのが、主流になった理由です。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a リレーショナルデータベースは、行(レコード)と列(カラム)という2次元の表形式でデータの関係を表現する。
> b リレーショナルデータベースは関係データベースともよばれる。
> c データベースの表において、横方向の並びをカラム、縦方向の並びをレコードという。
解答 a:○ b:○ c:×
学生Aの親は講座Aだけ、学生Cの親は講座Bだけです。1人の学生が2つの講座に所属することは表現できません。
② ネットワーク型データベース
ネットワーク型データベースは、レコードの関係を木構造で表し、親レコードと子レコードの関係がn:nであるデータベースです。データの関係が網の目のように互いにリンクする構造(網構造)であることから、「網状のもの」を表すネットワークと名づけられました。
n:nとは、1つの親が複数の子を持ち、かつ1つの子も複数の親を持てるという関係です。つまり、子レコードも複数の親レコードを持つことができます。
例
同じ学校のデータをネットワーク型で表すと、
というように、学生Bが講座Aと講座Bの両方に所属していることを表現できます。現実には1人が複数の講座を受講することは当たり前なので、こちらのほうが実態に近いといえます。
③ 2つの違いを1行で
| 階層型 | ネットワーク型 | |
|---|---|---|
| つなぎ方 | ポインタ | ポインタ |
| 構造 | 木構造 | 網構造(木構造で表すが網の目にリンク) |
| 親子の関係 | 1:n | n:n |
| 子が持てる親の数 | 1つだけ | 複数 |
「子が親を1つしか持てないのが階層型、複数持てるのがネットワーク型」——これが唯一にして最大の違いです。
④ 試験での問われ方
この論点は、リレーショナルデータベースの説明と入れ替える形でよく出題されます。
> 誤りの例:「データを複数の表に整理して、表と表の間はそれぞれの表の中の値を用いて関連付けるDBをネットワーク型DBという」
これはリレーショナルデータベースの説明です。ネットワーク型はポインタでつなぐのであって、値でつなぐのではありません。
「表」「値で関連付ける」という語が出てきたらリレーショナル型、「ポインタ」「木構造」という語が出てきたら階層型かネットワーク型、と振り分けてから、1:nかn:nかを見る——という2段階で判定すれば確実です。
具体例
設例 データベースの種類
> データベース(DB)に関する次の記述について、正誤を判定せよ。(令和元年度第9問 改題)
> ア レコード間の相互関係をポインタを用いて記述した木構造で表現できるDBを階層型DBという。
> イ データを複数の表に整理して、表と表の間はそれぞれの表の中の値を用いて関連付けるDBをネットワーク型DBという。
> ウ データを識別するためのキーとデータの値をペアにして多様なデータを格納・管理するDBをキー・バリュー型DBという。
解答 ア:○ イ:× ウ:○
なぜイのような誤りが作りやすいのか
「ネットワーク」という言葉が、日常では「つながり」「関連」を広く意味するからです。「表と表を関連付ける」と聞くと、つながりを扱うネットワーク型のように感じてしまいます。
しかし、データベースの文脈での「ネットワーク型」は、網構造(子が複数の親を持つ)という、きわめて限定的な意味です。言葉の日常的な語感に引きずられないことが、この種の問題を落とさないコツです。
3つの方式を歴史の順に並べる
| 登場順 | 方式 | 背景 |
|---|---|---|
| 1960年代 | 階層型 | 大型コンピュータでの業務処理。取り出し方が決まっていた |
| 1960年代後半 | ネットワーク型 | 階層型では表せない関係(複数の親)に対応 |
| 1970年代〜 | リレーショナル型 | 柔軟な問い合わせへの要求。SQLの標準化 |
| 2000年代〜 | NoSQL(キーバリュー型ほか) | ビッグデータ、Webサービスの大量アクセス |
技術は「前の方式の限界」から生まれる
この流れを押さえておくと、次のテーマで学ぶNoSQLが「なぜ生まれたか」も納得できます。それぞれの方式は、前の方式を否定するのではなく、前の方式が苦手とする領域を埋めるために登場しているわけです。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 階層型データベースでは、子レコードは1つの親レコードしか持たない。
> b ネットワーク型データベースでは、親レコードと子レコードの関係はn:nである。
解答 a:○ b:○
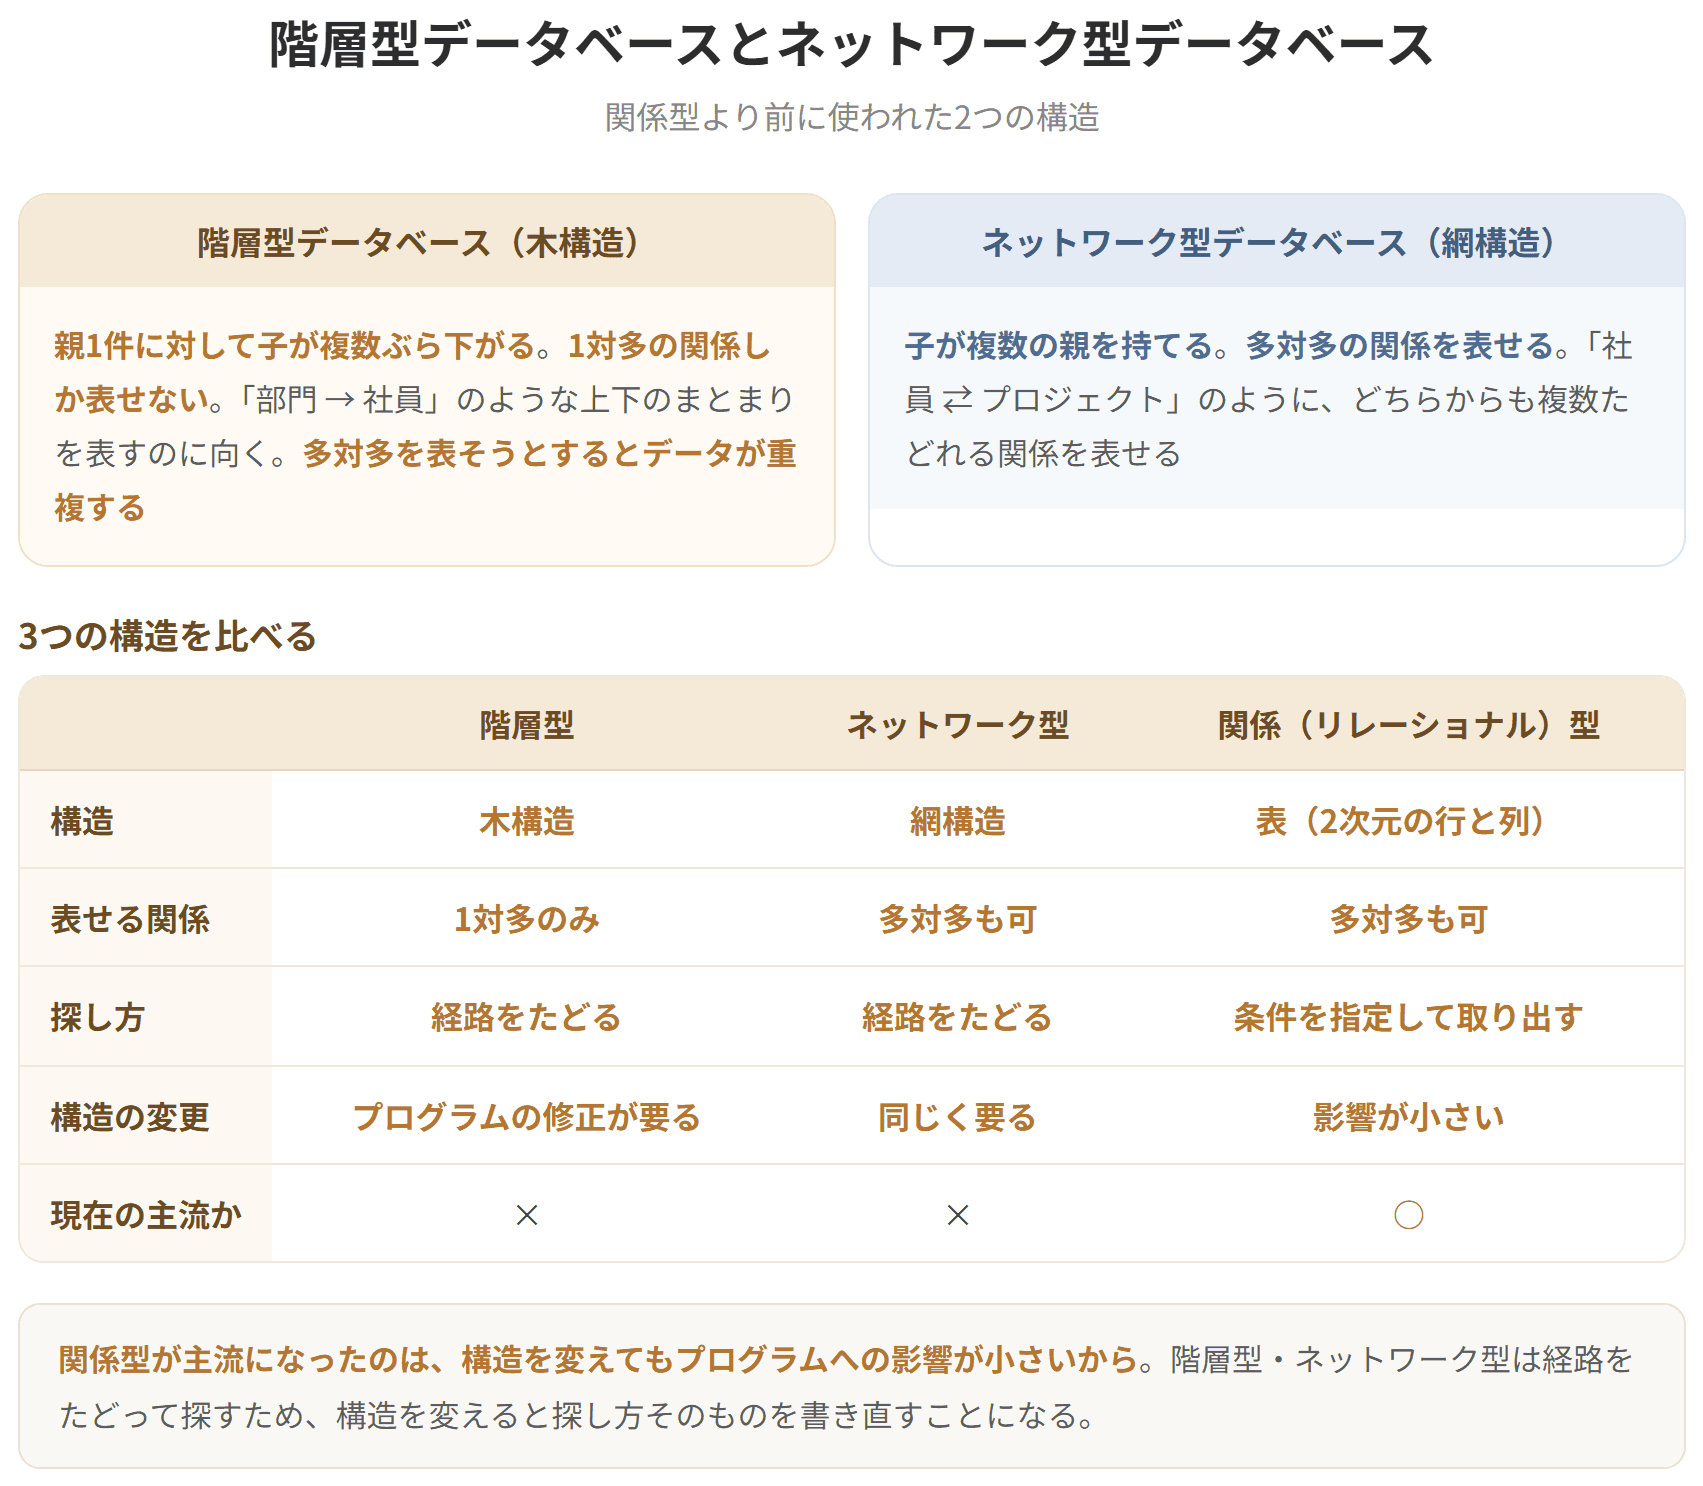
階層型データベースとネットワーク型データベース
試験のポイント
| 8月6日 | 晴れ |
| 8月7日 | 曇り |
| 8月8日 | 雨 |
「キーを指定すれば値が返る」という、それだけの構造です。表の定義もなければ、列の型の指定もありません。辞書を引くのと同じ感覚です。
② カラムナー(列指向)データベース
カラムナー(列指向)データベースは、DBMSが内部でデータを並べる向きを「行ごと」から「列ごと」に変えたものです。同じ列の値がかたまって置いてあるので、1つの列だけをまとめて読む処理が速くなります。
列方向のデータの高速な取得に向けて最適化されているので、大量の行に対する少数の列方向の集計を効率化できます。
行指向との違い
通常のリレーショナルデータベースは「行指向」のデータベースです。
| 行指向(ローストア) | 列指向(カラムストア) | |
|---|---|---|
| まとめ方 | 1つひとつの行をひとかたまりのデータとして扱う | 列方向にデータをまとめて扱う |
| データの追加 | 行単位で行われる | — |
| 検索結果 | 複数の行として返ってくる | — |
| 削除・更新 | 特定の行をカーソルなどが指し示したうえで、その行に対して更新や削除といった操作が行われる | 非効率 |
| 得意なこと | 特定の行を抜き出して更新・削除する | 特定の列の値をまとめて処理する |
具体例で考える
100万行の商品テーブルから「商品名と価格だけを抜き出す」処理を考えます。
逆に「特定の1行を抜き出して更新する」処理では、列指向は不利になります。その1行のデータが列ごとにばらばらの場所に散っているからです。
③ NoSQLデータベース
NoSQLデータベースは、大量かつ多様な形式のデータを高速に操作・分析することを可能とする、非リレーショナルな分散データベースシステムです。
従来のRDBと異なり、次の特徴があります。
NoSQLという名前の意味
「No SQL(SQLではない)」ではなく、「Not only SQL(SQLだけではない)」の略だとされています。SQLを否定するのではなく、SQL以外の選択肢も持つ、という意味です。
④ NoSQLの分類
NoSQLデータベースは、次の種類に分類されます。
| 種類 | 内容 |
|---|---|
| キーバリューデータベース | キーと値をペアで管理 |
| カラムナーデータベース | 列方向にまとめて管理 |
| ドキュメントデータベース | 複雑なデータを「ドキュメント」として管理 |
| グラフデータベース | データの相互の結びつきを管理、グラフ理論に基づく管理 |
つまり、キーバリュー型もカラムナー型も、NoSQLの一種という位置づけです。NoSQLは特定の1つの方式ではなく、リレーショナルでないデータベースの総称だと考えてください。
⑤ スキーマレスであることの意味
NoSQLの特徴として挙げられる「スキーマレス」とは、あらかじめ表の構造を決めておく必要がないということです。
リレーショナルデータベースでは、データを入れる前に「この表には、商品コード(文字列)、商品名(文字列)、価格(数値)の3列がある」と定義しなければなりません。あとから列を追加するには、表の定義を変更する作業が必要です。
NoSQLでは、この事前の定義が不要、あるいは柔軟です。あるデータには項目が3つ、別のデータには5つ、という状態でも構いません。データの形が定まらない、あるいは変わり続ける用途に向いているわけです。
その代わり、整合性の保証はリレーショナルデータベースより弱くなります。どちらが優れているかではなく、何を優先するかが違うという理解が正確です。
具体例
設例 NoSQLの定義
> 次の記述の正誤を判定せよ。(令和4年度第14問 改題)
> NoSQLとは、DBMSが管理するデータ・利用者・プログラムに関する情報やこれらの間の関係を保存したデータベースである。
解答 ×
NoSQLの内容(特徴)として適切ではありません。NoSQLは、大量かつ多様な形式のデータを高速に操作・分析することを可能とする、非リレーショナルな分散データベースシステムです。
なお、問題文にある「DBMSが管理するデータ・利用者・プログラムに関する情報やこれらの間の関係を保存したもの」は、一般にデータディクショナリ(データ辞書)とよばれるものの説明に近い内容です。
用途から方式を選ぶ——4つの場面
| 場面 | 向いている方式 | 理由 |
|---|---|---|
| 会計システムの仕訳を管理する | リレーショナル型 | 整合性が絶対。行単位の更新が中心 |
| Webサイトのセッション情報を保持する | キーバリュー型 | 単純な読み書きが大量に発生する |
| 数億行の売上から商品別の合計を集計する | カラムナー型 | 少数の列を大量の行にわたって集計する |
| SNSの「友人の友人」を探す | グラフ型 | データ同士の結びつきをたどる |
なぜ会計だけはリレーショナル型なのか
会計データでは、借方と貸方が必ず一致していなければならないという制約があります。片方だけ登録されるようなことがあってはなりません。
次節で学ぶACID特性——とくに原子性(すべて実行されるか、まったく実行されないか)——を厳密に保証できるのは、リレーショナルデータベースの強みです。NoSQLは速度と柔軟性を優先するかわりに、この保証を緩めていることが多くなっています。
中小企業での現実的な判断
診断士として助言する場面では、次のように整理できます。
| 状況 | 選択 |
|---|---|
| 一般的な業務システム(販売、在庫、会計) | リレーショナルデータベースで十分。無理に新しい方式を選ぶ理由はない |
| Webサイトのアクセスログを大量にためて分析したい | カラムナー型やNoSQLを検討する価値がある |
| センサーのデータを秒単位で記録し続けたい | 時系列に特化した方式やキーバリュー型を検討 |
「新しい技術だから良い」ではない——この判断軸を持っておくことが、第11章のIT戦略やIT投資管理でも生きてきます。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a カラムナー(列指向)データベースは、大量の行に対する少数の列方向の集計を効率化できる。
> b キーバリューデータベースは、通常のRDBと同様にスキーマ設計が必要である。
> c NoSQLデータベースには、ドキュメントデータベースやグラフデータベースが含まれる。
解答 a:○ b:× c:○
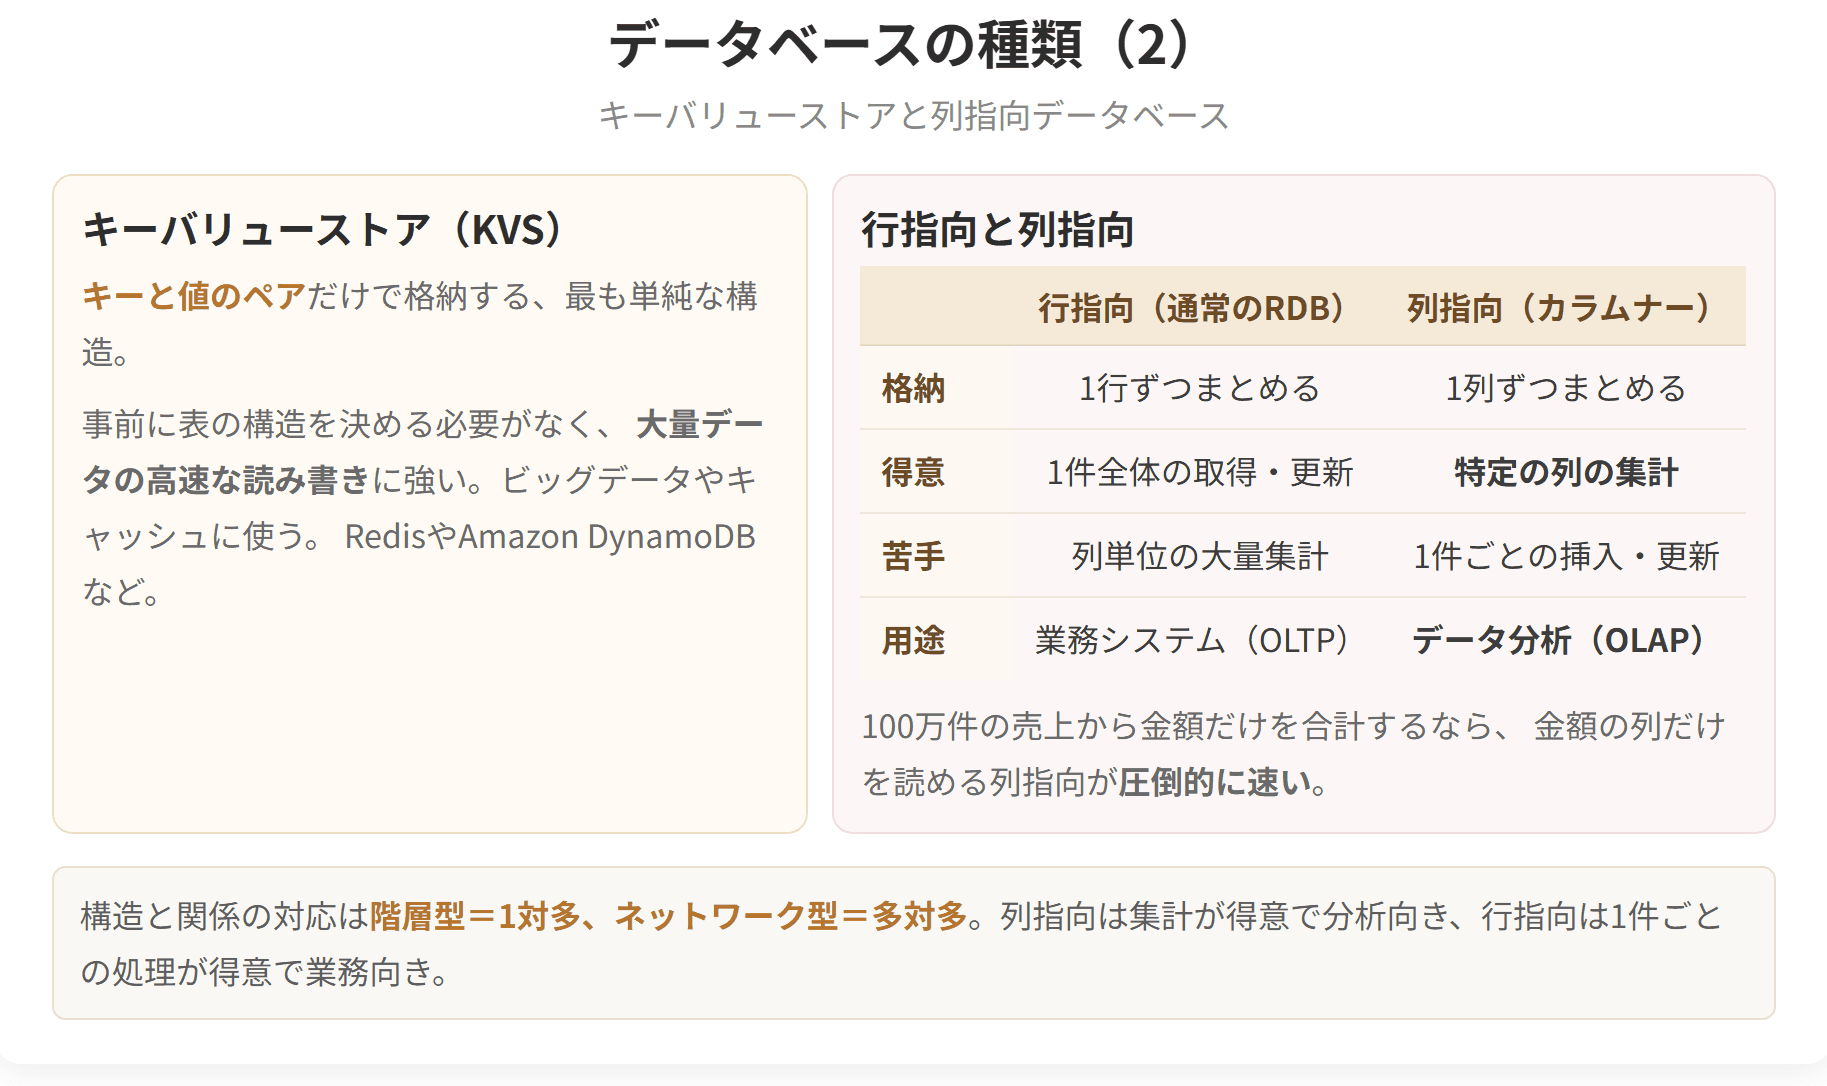
データベースの種類(2)
試験のポイント
| 補助記憶装置(SSD、ハードディスク) | 遅い |
通常のデータベースは、データを補助記憶装置に置き、必要なぶんだけ主記憶装置に読み込んで処理します。この読み込みの待ち時間が、データベースの応答時間の大部分を占めます。
インメモリデータベースは、最初からすべてを主記憶装置に置いてしまうことで、この待ち時間をなくします。発想としては極端ですが、主記憶装置の価格が下がり、大容量を搭載できるようになったことで現実的になりました。
③ 揮発性という弱点
ここが試験で問われるところです。
> 現在のコンピュータで主に使われているメモリである主記憶装置(DRAM)は、コンピュータの電源がオフになると保存されているデータが消失します。
第1章で学んだとおり、DRAMは揮発性です。電源が切れれば中身は消えます。データベースの中身が停電で全部消える——これでは業務に使えません。
> そのためインメモリデータベースでは、電源が切れた際にデータを復旧する機能を備え、データを永続化する仕組みが必要です。
具体的には、次のような仕組みが併用されます。
| 仕組み | 内容 |
|---|---|
| ログの書き出し | 更新の記録を補助記憶装置に残しておき、再起動時に復元する |
| 定期的なスナップショット | ある時点のメモリの内容を丸ごと補助記憶装置に書き出す |
| 複製(レプリケーション) | 別のサーバにも同じデータを持たせる |
「速いが消える」という性質に、どう手当てをするか——この考え方は、第7章で学ぶ障害対策(フォールトトレランス)にもつながります。
④ リポジトリ
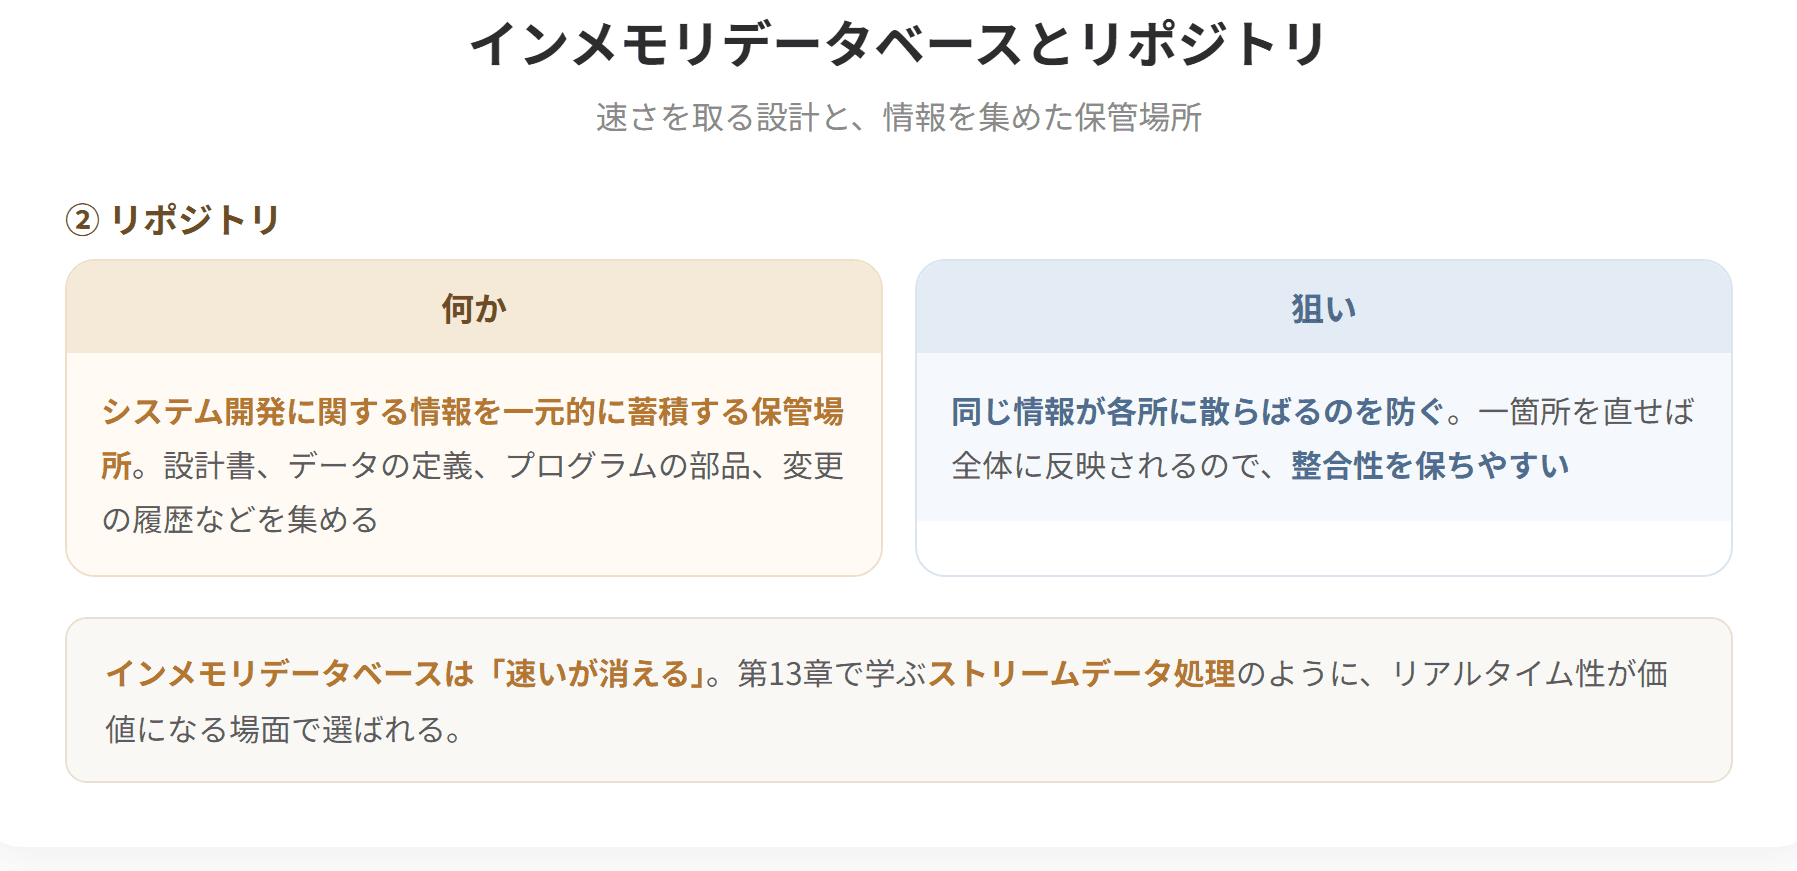
リポジトリは、データやファイルなどを一元的に管理する格納場所を指します。
格納される対象は分野によって異なりますが、システム開発においては、仕様書やソースコード、変更履歴などを一元的に管理する仕組みとして利用されることが多いものです。
リポジトリを導入する効果
⑤ リポジトリが解決する問題
システム開発の現場で、リポジトリがない場合に何が起きるかを考えると、その価値が見えてきます。
| リポジトリがないと | リポジトリがあると |
|---|---|
| 「最新版_修正版_final2.doc」のようなファイルが乱立する | どれが最新かが一意に決まる |
| 2人が同じファイルを別々に直し、片方の変更が消える | 変更が衝突したことを検知できる |
| いつ誰が何を変えたか分からない | 変更履歴をたどれる |
| 元に戻したいのに戻せない | 過去の任意の時点に戻せる |
3つ目の追跡できることは、第12章で学ぶ構成管理や、第11章で学ぶITリスク管理の観点からも重要です。「誰がいつ何を変更したか」が分からないシステムは、障害が起きたときに原因を特定できず、不正が行われても気づけません。
⑥ 名前の由来
repositoryは「保管庫、倉庫」を意味する英語です。単なる置き場所ではなく、中身が整理され、出し入れの記録が残る倉庫、というニュアンスがあります。
データベースの文脈では、データディクショナリ(DBMSが管理するデータや利用者、プログラムに関する情報を保存したもの)を指してリポジトリとよぶこともあります。分野によって指すものが変わる、という点は定義文のとおりです。
具体例
インメモリデータベースが選ばれる場面
応答速度が売上に直結する業務では、インメモリデータベースが検討されます。
| 場面 | なぜ速度が要るのか |
|---|---|
| 証券取引のシステム | 数ミリ秒の遅れが取引機会の損失になる |
| ECサイトの商品検索 | 表示が遅いと利用者が離脱する |
| ゲームのランキング集計 | リアルタイムに順位を返す必要がある |
| 通信事業者の課金処理 | 秒単位で大量の処理を捌く |
費用との兼ね合い
主記憶装置は補助記憶装置より、容量あたりの単価がはるかに高くなります(第1章の記憶装置の階層のとおりです)。
| 補助記憶装置に置く | すべて主記憶装置に置く | |
|---|---|---|
| 1TBあたりの費用 | 安い | 高い |
| 応答時間 | 長い | 短い |
| 電源断への耐性 | 強い | 仕組みで補う必要がある |
したがって、すべてのデータをインメモリにするのではなく、頻繁にアクセスされる一部だけを主記憶装置に置くという折衷案もよく取られます。第1章で学んだキャッシュメモリと同じ発想です。
リポジトリを使った開発の流れ
複数人でシステムを開発する場面を追ってみましょう。
| 順番 | 作業 | リポジトリの役割 |
|---|---|---|
| ① | 開発者がリポジトリから最新のソースコードを取得する | 誰もが同じ出発点に立てる |
| ② | 自分の担当部分を修正する | — |
| ③ | 修正をリポジトリに登録する | 変更内容と、誰がいつ変えたかを記録する |
| ④ | 他の開発者が最新版を取得する | ③の修正が反映される |
| ⑤ | 同じ箇所を2人が変更していた場合 | 衝突を検知し、解消を促す |
| ⑥ |
⑤の衝突検知が効く
リポジトリがなければ、2人が同じファイルを別々に直したとき、後から保存したほうが前の変更を上書きして消してしまいます。しかも、消えたことに誰も気づきません。
リポジトリは、この事故を「衝突が起きています」と知らせることで防ぎます。複数の利用者が同時に作業を進められるという効果は、この衝突検知があって初めて成立します。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a インメモリデータベースは、ディスクにアクセスする必要がないため応答時間を最小限にできる。
> b インメモリデータベースでは、電源が切れた際にデータを復旧する機能や永続化の仕組みが必要である。
> c リポジトリを導入すると同じ情報の重複を防げるが、誰がどのような作業を行ったかを追跡することはできない。
解答 a:○ b:○ c:×
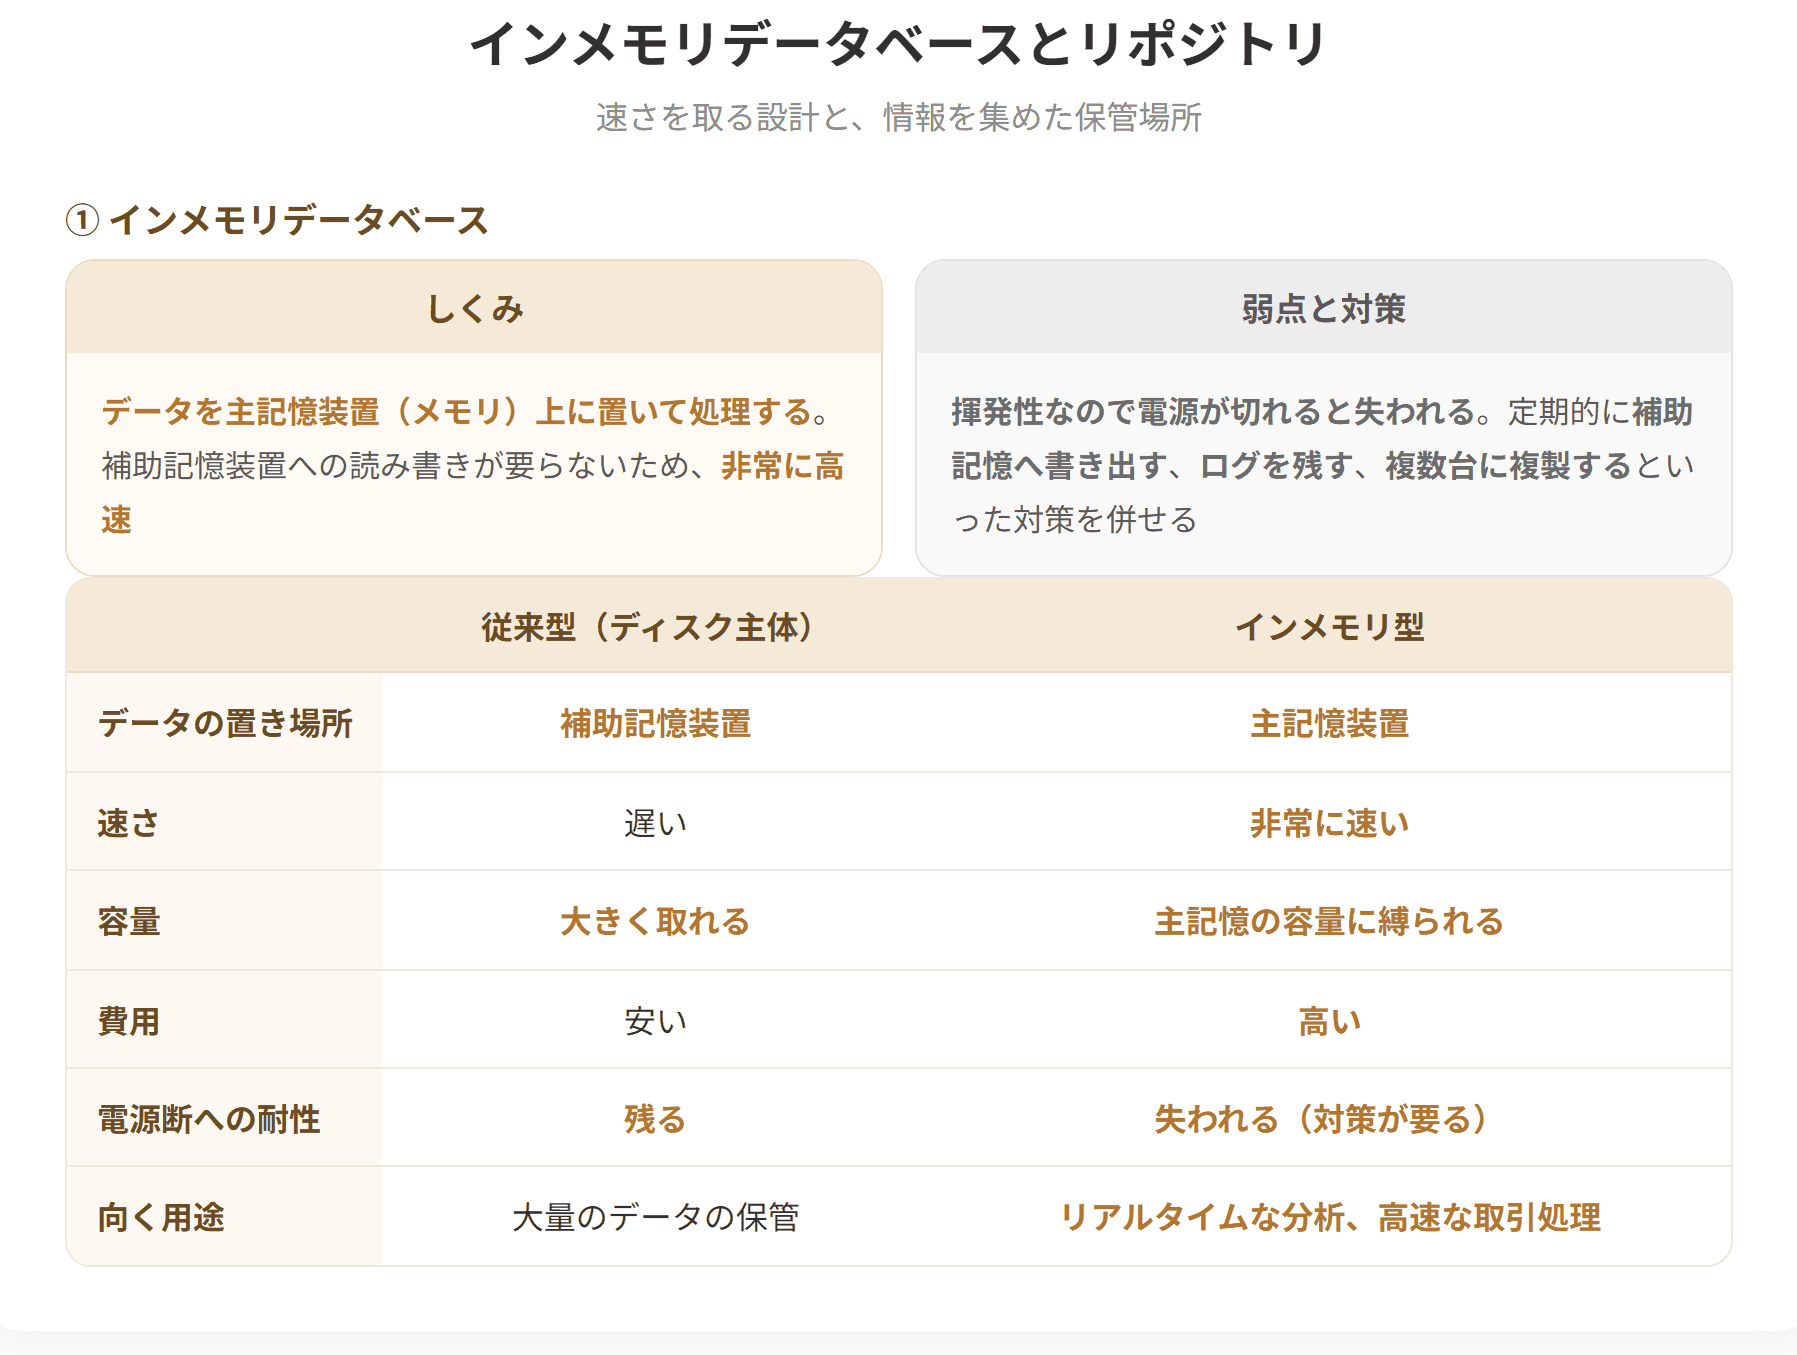
インメモリデータベースとリポジトリ(1/2)
インメモリデータベースとリポジトリ(2/2)
試験のポイント

 科目別の正答率と連続学習日数がマイページに出るので、次にどの科目をやるかで迷いません。プレミアム限定
プレミアムプラン
¥9,800〜/ 買い切り・自動更新なし(税込)
決済はStripe(世界最高水準・PCI-DSS準拠)で安全に処理されます。カード情報は当サービスに保存されません。
| 履歴をたどって原因の変更を特定できる |
