統計解析
下の動画はこの節の解説ではありません。 解説動画の雰囲気を知っていただくための見本として、「AI・機械学習」の動画を再生します。
この節の解説動画はプレミアム限定です。プレミアムなら全科目・全節が見放題!
プレミアムで見る統計とは、集団における個々の要素の分布を調べ、その集団の傾向・性質などを、数学的手法を用いて明らかにすることです。本試験では、検定と多変量解析の領域における数式そのものは求められていません。例年2題ほど出題されますが、そのうちB〜Cランクの問題が取れれば十分です。この節では、その土台となる基本的な用語——代表値(平均値・中央値・最頻値)、散らばりの指標(偏差・分散・標準偏差)、そして母集団と標本を学びます。


簡単にいうと
代表値は3つ! 平均値・中央値(メジアン)・最頻値(モード)。そして「平均値を下回っていても中央値より大きいことがある」——令和2年度の出題はここを突いてきたよ。
① 統計とは
統計とは、集団における個々の要素の分布を調べ、その集団の傾向・性質などを、数学的手法を用いて明らかにすることです。
② 分布の特徴を表す指標
データの分布を表す基本的な指標として、「データを代表する指標」と「データの散らばりを表す指標」があります。
| 指標の種類 | 具体的な指標 |
|---|---|
| データを代表する指標 | 平均値、中央値、最頻値(モード) |
| データの散らばりを表す指標 | 偏差、分散、標準偏差 |
③ 代表値とは
代表値とは、分布の特徴を1つの数字で代表する値です。
最もよく使われる代表値は平均値ですが、その他にも中央値や最頻値などがあります。
④ 平均値
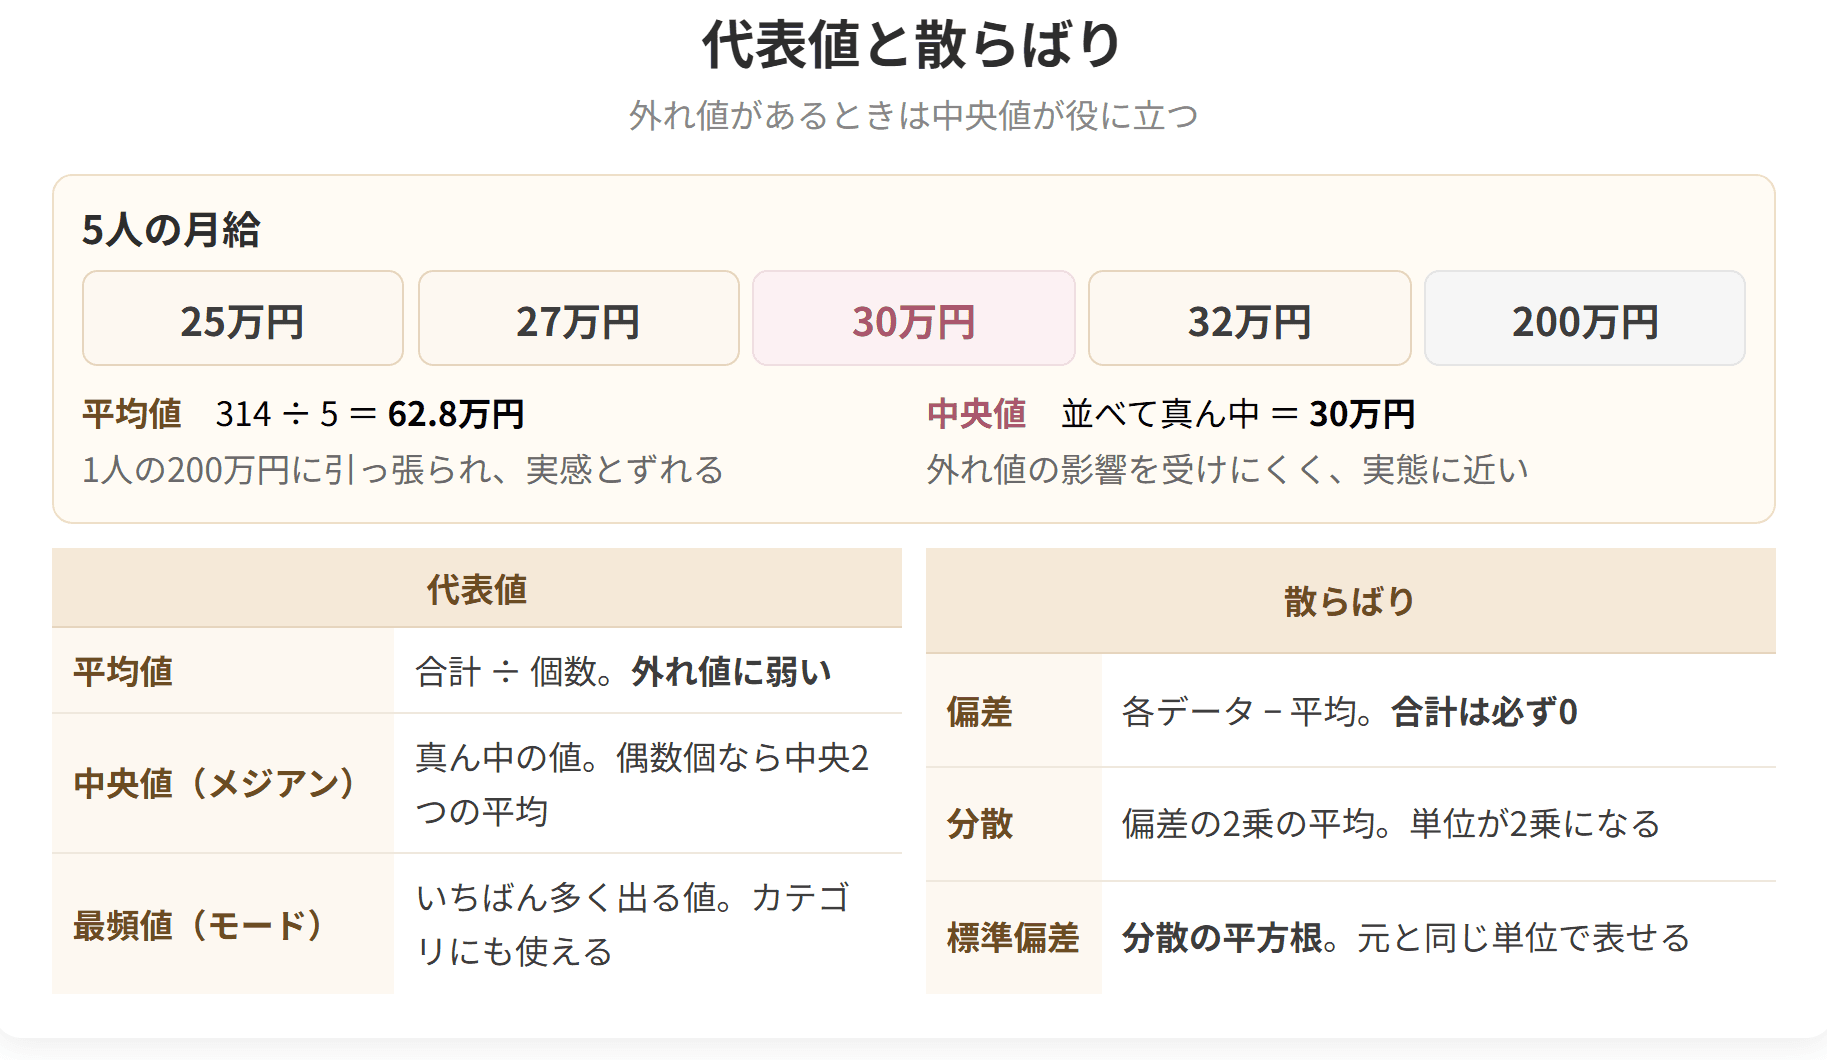
平均値とは、データを合計したものをデータ数で割った値
具体例
設例1 平均値と中央値の計算
> あるスーパーマーケットで10日間毎日、サンドイッチの売上個数を調査し、小さい順に並べたデータが以下に示されている。1日当たり売上個数の平均値と中央値(メジアン)を求めよ。(令和元年度第24問 改題)
>
> 46 48 50 50 51 51 53 53 53 55
解答 平均値:51 中央値:51
平均値の計算
| 計算 | 結果 |
|---|---|
| 46+48+50+50+51+51+53+53+53+55 | 510 |
| 510 ÷ 10 | 51 |
中央値の計算
| 手順 |
|---|
代表値と散らばり

試験のポイント

簡単にいうと
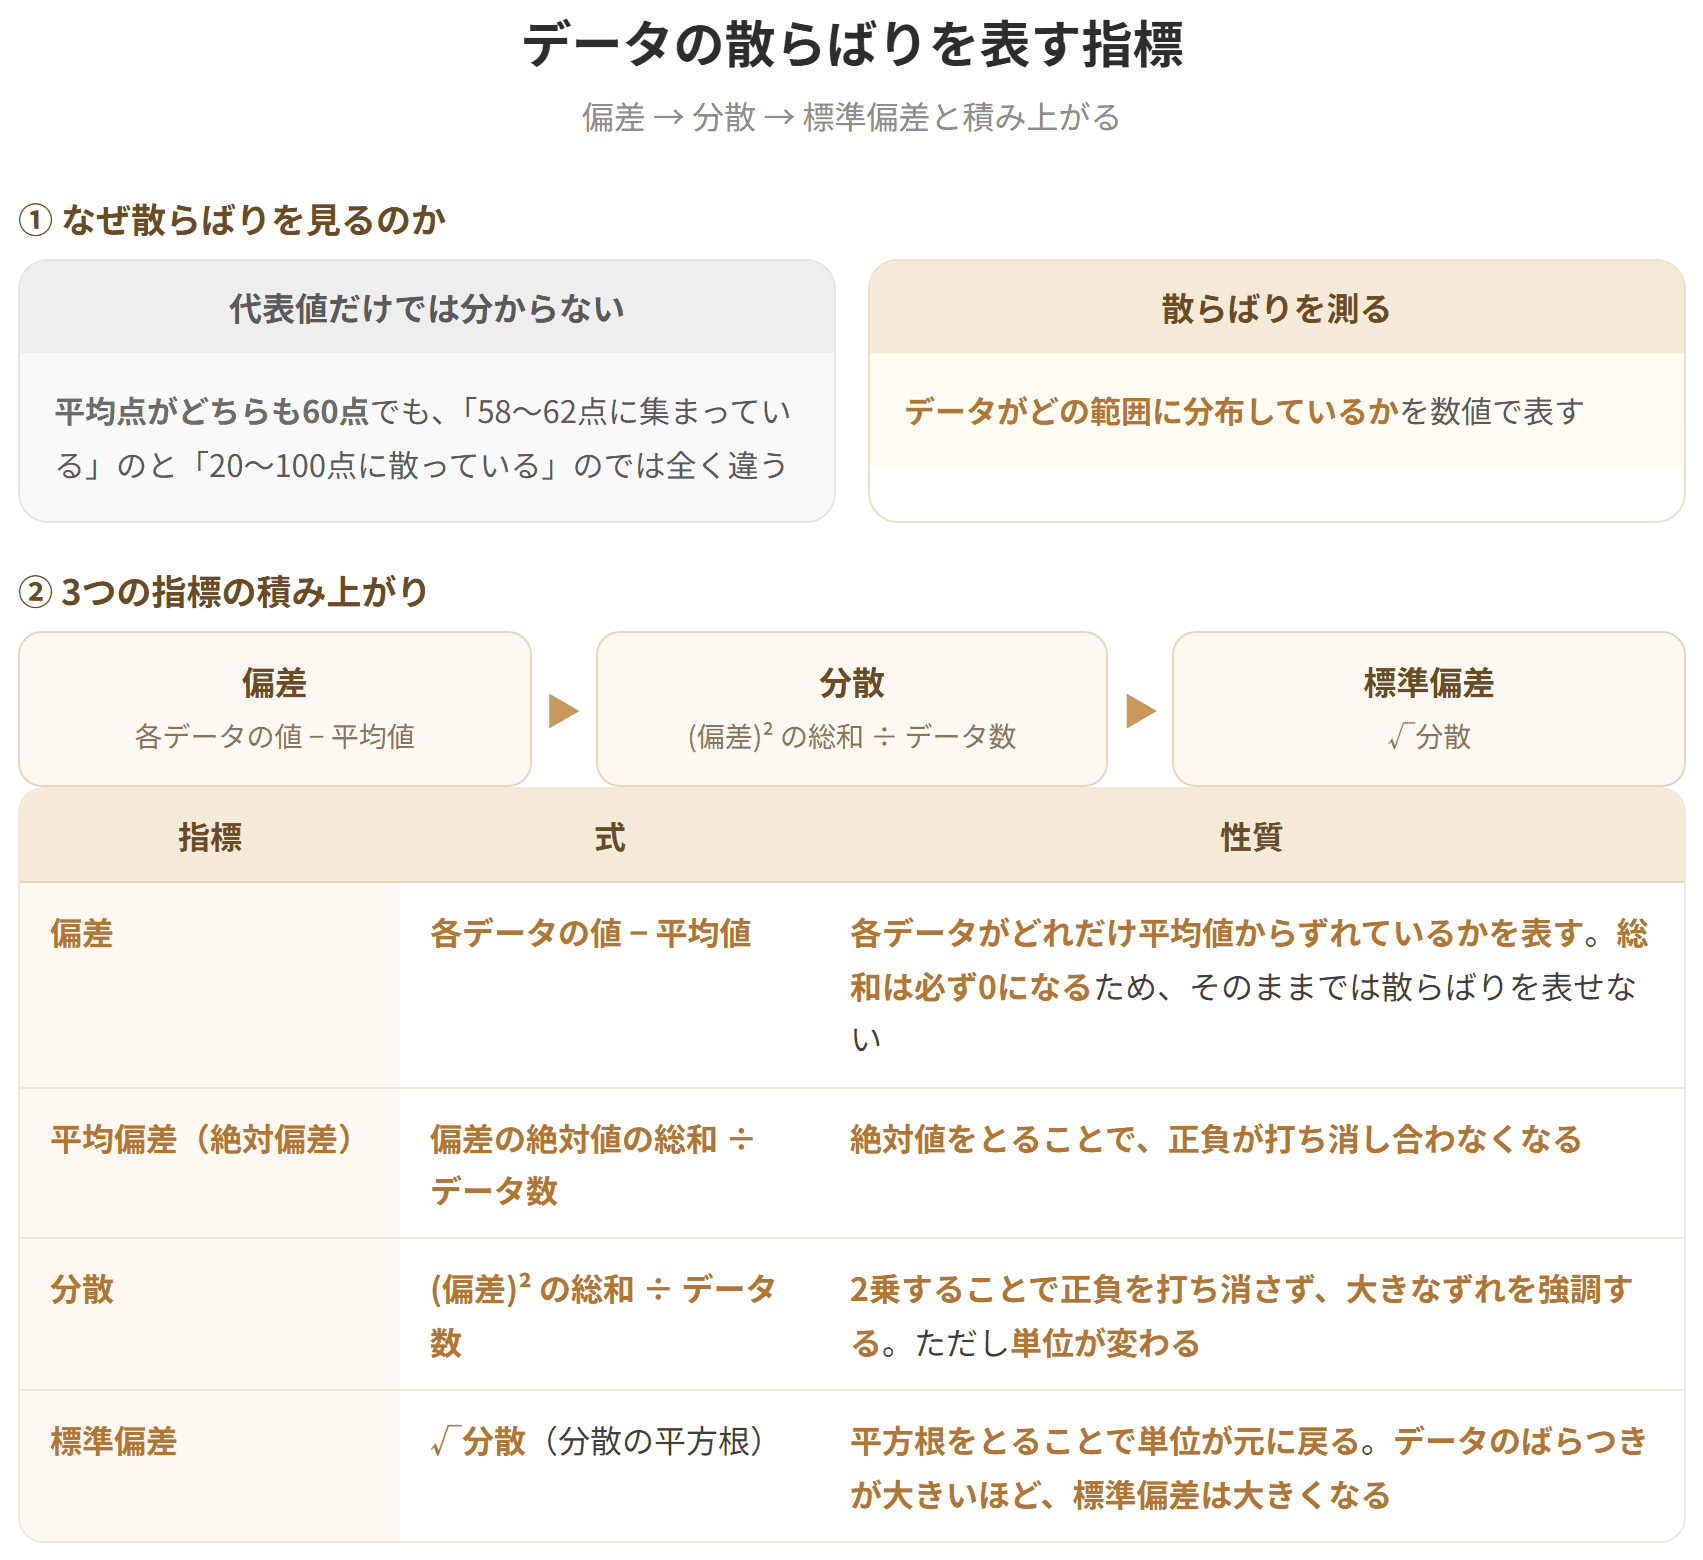
偏差→分散→標準偏差、と積み上がっていくよ!偏差は「各データの値−平均値」、分散は「偏差²の総和÷データ数」、標準偏差は「√分散」。この順序で覚えよう。
① なぜ散らばりを見るのか
データを代表する値には平均値や中央値がありますが、これらの代表値だけではデータがどの範囲に分布しているかがわかりません。
そこで、次のような指標を用いてデータがどれくらいばらついているかを把握します。
| 指標 |
|---|
| 偏差 |
| 分散 |
| 標準偏差 |
② 代表値だけでは分からないこと
簡単にいうと
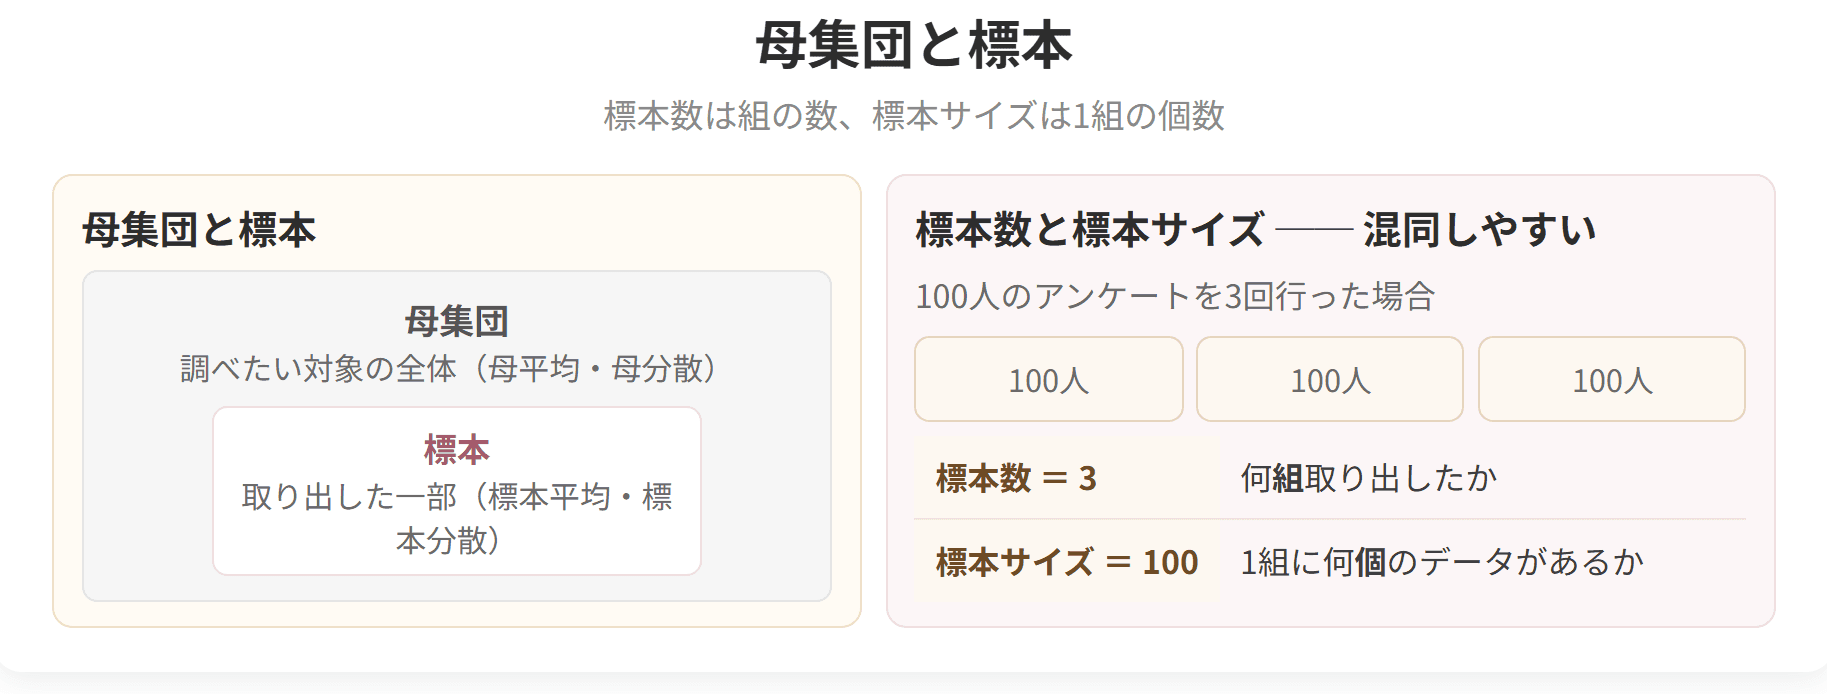
母集団と標本、そして母平均・母分散/標本平均・標本分散!さらに「標本数」と「標本サイズ」の違いが要注意。47都道府県から500人ずつなら、標本数47・標本サイズ500だよ。
① 母集団と標本
調査や研究でデータを収集するときに、対象となるすべてのデータを母集団といいます。
また、母集団から一部を選び出したデータの集まりのことを標本といいます。
| 用語 | 内容 |
|---|---|
| 母集団 | 対象となるすべてのデータ |
| 標本 |

動画・テキスト・過去問・AI添削まですべて網羅!
予備校代の1/10以下で、独学の不安をまるごと解決できます

 全7科目536節の解説動画539本・合計約41時間が見放題。連続再生・ブックマーク再生で、移動中も1本5分前後で進められます。プレミアム限定
 令和3〜7年度の1次過去問1,116問を、科目別・年度別に無制限で演習。問題の図・表と解説つきで、間違えた問題はマイページに残ります。プレミアム限定
 2次は事例I〜IVの114設問に何度でも書いて出せます。AIが設問ごとの基準で採点し、改善点は「どう書き直すか」の例と模範解答つき。プレミアム限定
 科目別のテキストPDFをダウンロードできます。印刷して書き込む、タブレットで持ち歩くなど、好きな使い方で。プレミアム限定
⑤ 中央値(メジアン/メディアン)
中央値とは、データを大きさの順に並べた際にちょうど中央にくる値です。
データが偶数個の場合は、中央に近い2つの値の平均値が中央値となります。
| データ数 | 中央値 |
|---|---|
| 奇数個 | ちょうど中央にくる値 |
| 偶数個 | 中央に近い2つの値の平均値 |
⑥ 最頻値(モード)
最頻値とは、最も度数(頻度)の多い値です。
| 用語 | 意味 |
|---|---|
| 度数(頻度) | その値が現れる回数 |
⑦ 3つの代表値の比較
| 代表値 | 求め方 | 特徴 |
|---|---|---|
| 平均値 | 合計 ÷ データ数 | 極端な値の影響を受けやすい |
| 中央値 | 大きさの順に並べて中央 | 極端な値の影響を受けにくい |
| 最頻値 | 最も度数の多い値 | 分布の山の位置を表す |
⑧ 分布が偏るとき、3つの値はずれる
世帯別の現在貯蓄額の分布(2023年、二人以上の世帯のうち勤労者世帯)を例にすると、次のようになります。
| 代表値 | 値 |
|---|---|
| 最頻値 | 最も低い階級(100万円未満) |
| 中央値 | 895万円 |
| 平均値 | 1,474万円 |
3つの大小関係
| 順 | 値 |
|---|---|
| 最も小さい | 最頻値 |
| 中間 | 中央値 |
| 最も大きい | 平均値 |
⑨ なぜこうなるのか
| 理由 | 内容 |
|---|---|
| 分布が右に長く裾を引いている | 一部に非常に大きな値がある |
| 平均値は大きな値に引っ張られる | 合計を使うため |
| 中央値は順位で決まる | 大きな値の影響を受けない |
年収や貯蓄額は、この型の分布になる——これが試験で狙われる論点です。
⑩ 「平均値を下回る=下位半分」は誤り
| 誤解 | 実際 |
|---|---|
| 平均値を下回っていれば下位半分 | 中央値より大きい可能性がある |
具体的に考える
| 値 | 意味 |
|---|---|
| 平均値:582万円 | 合計 ÷ 人数 |
| 中央値:仮に520万円 | ちょうど真ん中の人の年収 |
| 自分:560万円 | 平均を下回るが中央値より上 |
この場合、上位半分に位置する
⑪ どの代表値を使うべきか
| 状況 | 適する代表値 |
|---|---|
| 分布が左右対称 | 平均値でよい |
| 分布が偏っている | 中央値 |
| 極端な値がある | 中央値 |
| 最も多い層を知りたい | 最頻値 |
⑫ 実務での使い分け
| 場面 | 適する代表値 |
|---|---|
| 顧客の平均的な購買額 | 中央値(一部の大口が平均を引き上げる) |
| 標準的な商品の価格帯 | 最頻値 |
| 全体の売上規模 | 平均値 × 人数(合計) |
「平均」を鵜呑みにしない——これが実務での第一の教訓です。
| データ数は10個(偶数) | 中央に近い2つの値の平均 |
| 5番目と6番目 | 51と51 |
| (51+51) ÷ 2 | 51 |
このデータの最頻値は
| 値 | 度数 |
|---|---|
| 46 | 1 |
| 48 | 1 |
| 50 | 2 |
| 51 | 2 |
| 53 | 3 |
| 55 | 1 |
最頻値:53
3つの代表値
| 代表値 | 値 |
|---|---|
| 平均値 | 51 |
| 中央値 | 51 |
| 最頻値 | 53 |
ほぼ対称に近い分布——3つの値が近くなります。
設例2 平均値と順位
> 次の記述の正誤を判定せよ。(令和2年度第23問 改題)
> ある企業の従業員の年収の平均値を計算すると582万円であった。この企業の従業員である私の年収は560万円である。私の年収は平均値を下回っているので、従業員の年収を高い順に並べた時、下位半分に位置する。
解答 ×
年収や貯蓄額など分散が大きいデータ群の場合、平均値を下回っている場合であっても、中央値よりは大きい可能性があります。
具体例で確認する
従業員10名の年収(万円)
| 順位 | 年収 |
|---|---|
| 1 | 1,800 |
| 2 | 900 |
| 3 | 700 |
| 4 | 600 |
| 5 | 560 |
| 6 | 520 |
| 7 | 480 |
| 8 | 450 |
| 9 | 430 |
| 10 | 380 |
平均値
| 計算 | 結果 |
|---|---|
| 合計 6,820 ÷ 10 | 682万円 |
中央値
| 手順 | 結果 |
|---|---|
| 5番目と6番目の平均 | (560+520)÷2 = 540万円 |
年収560万円の人の位置
| 比較 | 判定 |
|---|---|
| 平均値682万円 | 下回る |
| 中央値540万円 | 上回る |
| 順位 | 10人中5位(上位半分) |
「平均を下回るが上位半分」が成立する
なぜこうなるのか
| 要因 | 内容 |
|---|---|
| 1人の高額所得者(1,800万円) | 平均を大きく引き上げる |
| 中央値は影響を受けない | 順位で決まる |
「1人の突出した値が平均を歪める」
| データ | 平均値 | 中央値 |
|---|---|---|
| 1,800万円を含む | 682万円 | 540万円 |
| 1,800万円を800万円に変える | 582万円 | 540万円 |
平均値は100万円下がるが、中央値は変わらない
実務での応用
例1:顧客の購買額を分析する
| 指標 | 値 |
|---|---|
| 平均購買額 | 12,000円 |
| 中央値 | 4,500円 |
この差が意味すること
| 内容 |
|---|
| 一部の大口顧客が平均を押し上げている |
| 多くの顧客は4,500円程度 |
施策への影響
| 判断 | 内容 |
|---|---|
| 「平均12,000円だから」と品揃えを高単価に | 多くの顧客を逃す |
| 中央値も見て判断する | 主力の価格帯が分かる |
例2:従業員の給与水準を比較する
| 比較 | 注意 |
|---|---|
| 業界平均と自社平均 | 役員報酬が含まれるか |
| 職種別の平均 | 構成の違い |
「平均年収」の比較の落とし穴
| 企業 | 平均年収 | 実態 |
|---|---|---|
| A社 | 600万円 | 年齢構成が高い |
| B社 | 500万円 | 若手が多い |
同じ年齢では B社のほうが高いこともある——平均だけでは判断できません。
例3:待ち時間の分析
| 指標 | 値 |
|---|---|
| 平均待ち時間 | 8分 |
| 中央値 | 5分 |
| 最頻値 | 3分 |
この差が意味すること
| 内容 |
|---|
| 多くの客は3〜5分で済む |
| 一部の客が非常に長く待っている |
改善の方向
| 判断 | 内容 |
|---|---|
| 全体を少しずつ速くする | 平均は下がるが、長く待つ客は残る |
| 長く待つケースの原因を潰す | 満足度への効果が大きい |
「不満を持つのは長く待った客」——平均ではなく、分布の裾を見るべき場面です。
診断士としての助言
| 場面 | 助言 |
|---|---|
| 平均値だけで判断している | 中央値も見ましょう |
| 分布が偏っている | 平均は実態を表しません |
| 改善の対象を決める | 分布の裾を見ましょう |
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 中央値とは、データを大きさの順に並べた際にちょうど中央にくる値であり、データが偶数個の場合は中央に近い2つの値の平均値が中央値となる。
> b 最頻値とは、最も度数(頻度)の多い値である。
> c 平均値は、極端に大きな値があっても影響を受けにくい指標である。
解答 a:○ b:○ c:×
例:2つのグループの平均点がどちらも60点
| グループ | データ |
|---|---|
| A | 58, 59, 60, 61, 62 |
| B | 20, 40, 60, 80, 100 |
どちらも平均は60点だが、散らばりが全く違う
| グループ | 特徴 |
|---|---|
| A | 全員が60点前後 |
| B | 大きくばらついている |
③ 偏差
偏差とは、各データの値から平均値を引いて得られた値です。
各データがどれだけ平均値からずれているかを表します。
④ 偏差の性質
| 値 | 意味 |
|---|---|
| 正の値 | 平均値より大きい |
| 負の値 | 平均値より小さい |
| 0 | 平均値と等しい |
偏差の総和は必ず0になる
| 理由 | 内容 |
|---|---|
| 正の偏差と負の偏差が打ち消し合う | そのままでは散らばりを表せない |
この問題を解決するのが、次の平均偏差と分散です。
⑤ 平均偏差(絶対偏差)
偏差を用いて各データのばらつきを表す指標のひとつに平均偏差(絶対偏差)があります。
平均偏差は、各データの偏差の絶対値をとった値の平均値です。
絶対値をとることで、正負が打ち消し合わなくなります。
⑥ 分散
分散とは、偏差を2乗した値の合計値をデータ数で割った値です。
⑦ なぜ2乗するのか
| 理由 | 内容 |
|---|---|
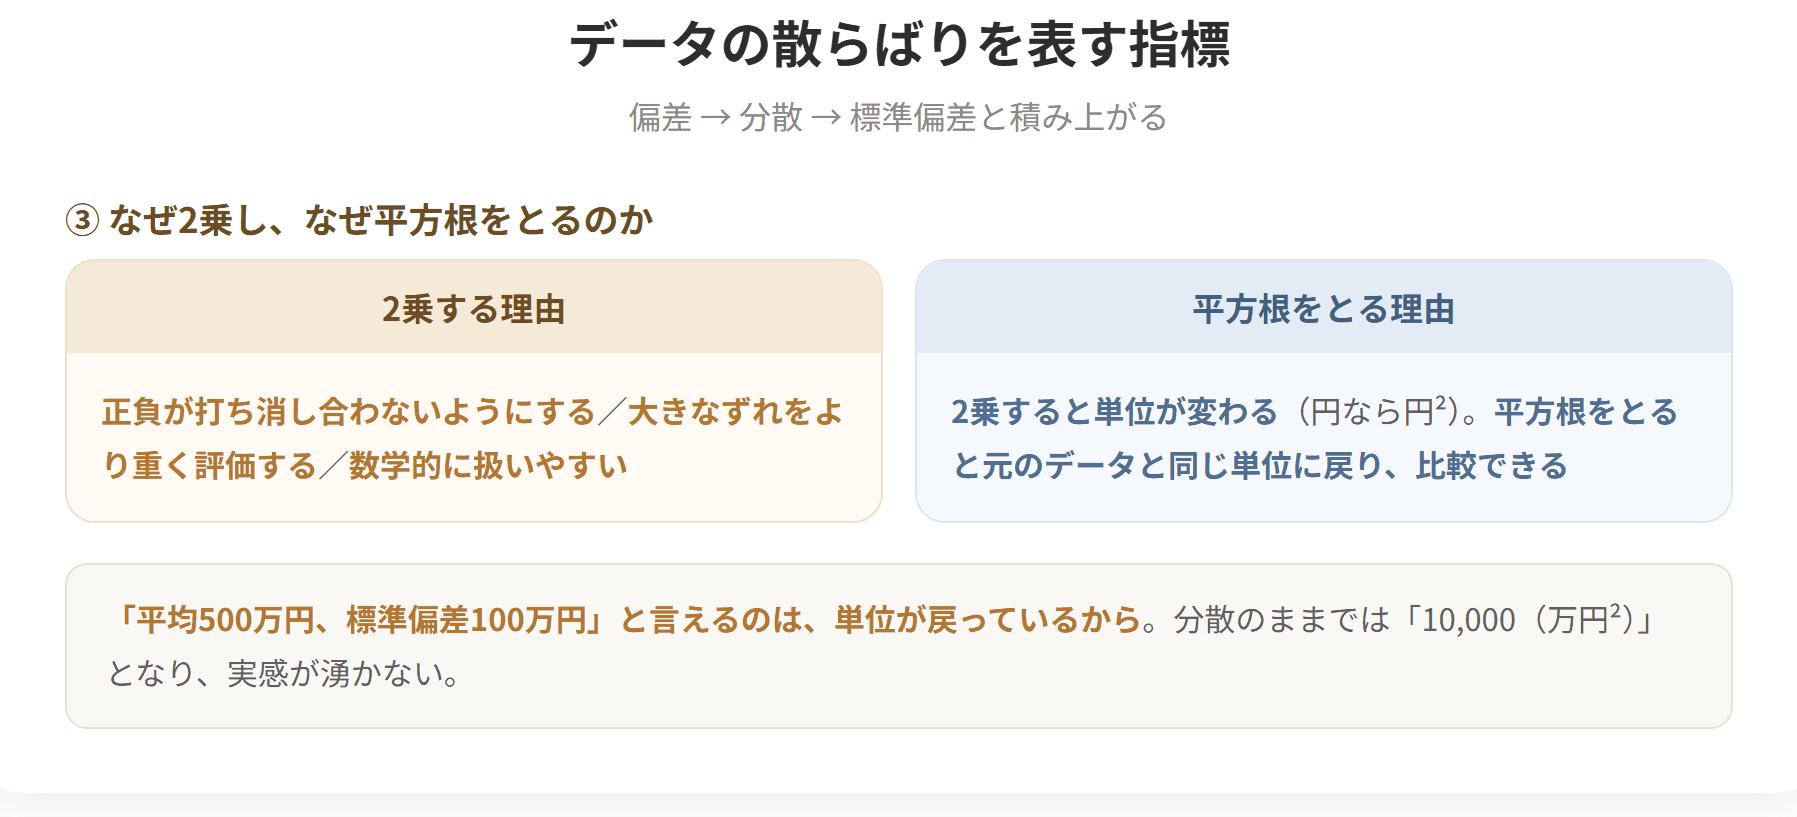
| 正負を打ち消さないため | 2乗すれば必ず正になる |
| 大きなずれをより重く評価するため | 2乗すると差が強調される |
| 数学的に扱いやすいため | 微分などの操作がしやすい |
絶対値との違い
| 平均偏差(絶対値) | 分散(2乗) | |
|---|---|---|
| 大きなずれの扱い | そのまま | 強調される |
| 数学的な扱い | やや扱いにくい | 扱いやすい |
統計では分散のほうが広く使われます。
⑧ 標準偏差
標準偏差とは、分散の平方根をとった値です。
データのばらつきが大きいほど、標準偏差は大きくなります。
⑨ なぜ平方根をとるのか
| 問題 | 内容 |
|---|---|
| 分散は2乗しているため単位が変わる | 金額なら「円²」になってしまう |
| 平方根をとると単位が戻る | 元のデータと同じ単位で比較できる |
例:売上のばらつき
| 指標 | 値 | 単位 |
|---|---|---|
| 分散 | 10,000 | (万円)² |
| 標準偏差 | 100 | 万円 |
「平均500万円、標準偏差100万円」と表現できる——これが標準偏差が使われる理由です。
⑩ 3つの指標の関係
| 順 | 指標 | 計算 |
|---|---|---|
| ① | 偏差 | 各データの値 − 平均値 |
| ② | 分散 | (偏差)² の総和 ÷ データ数 |
| ③ | 標準偏差 | √分散 |
段階的に積み上がる
⑪ 標準偏差の読み方
データが正規分布に従う場合、次の性質があります。
| 範囲 | 含まれるデータの割合 |
|---|---|
| 平均値 ± 1標準偏差 | 約68% |
| 平均値 ± 2標準偏差 | 約95% |
| 平均値 ± 3標準偏差 | 約99.7% |
「約95%」が次節の有意水準5%につながります。
⑫ 変動係数
標準偏差は単位に依存するため、異なる単位のデータを比較するときは変動係数を使います。
| 場面 | 内容 |
|---|---|
| 単位が違うデータを比較する | 売上(円)と客数(人) |
| 規模が違うデータを比較する | 大企業と中小企業 |
⑬ 実務での用途
| 用途 | 内容 |
|---|---|
| 品質管理 | 製品のばらつきを測る |
| 売上の安定性 | 月次売上の変動 |
| 需要予測 | 予測の誤差の幅 |
| 投資判断 | リスクの尺度 |
財務・会計とのつながり
| 科目 | 扱われ方 |
|---|---|
| 財務・会計 | リスク(標準偏差)とリターン(期待値) |
| 運営管理 | 品質管理の工程能力指数 |
| 経営情報システム | 統計の基本的な指標 |
具体例
実際に計算してみる
データ:ある店舗の5日間の来客数
| 日 | 来客数 |
|---|---|
| 1 | 80 |
| 2 | 90 |
| 3 | 100 |
| 4 | 110 |
| 5 | 120 |
手順① 平均値を求める
| 計算 | 結果 |
|---|---|
| (80+90+100+110+120) ÷ 5 | 100 |
手順② 偏差を求める
| 日 | 来客数 | 偏差(来客数 − 100) |
|---|---|---|
| 1 | 80 | −20 |
| 2 | 90 | −10 |
| 3 | 100 | 0 |
| 4 | 110 | +10 |
| 5 | 120 |
偏差の総和を確認
| 計算 | 結果 |
|---|---|
| (−20)+(−10)+0+10+20 | 0 |
必ず0になる——これが偏差をそのまま使えない理由です。
手順③ 分散を求める
| 日 | 偏差 | 偏差の2乗 |
|---|---|---|
| 1 | −20 | 400 |
| 2 | −10 | 100 |
| 3 | 0 | 0 |
| 4 | +10 | 100 |
| 5 | +20 |
| 計算 | 結果 |
|---|---|
| 1,000 ÷ 5 | 200 |
分散:200
手順④ 標準偏差を求める
| 計算 | 結果 |
|---|---|
| √200 | 約14.1 |
標準偏差:約14.1人
結果の読み方
| 表現 | 内容 |
|---|---|
| 「平均100人、標準偏差14.1人」 | おおむね86〜114人の範囲に多くの日が収まる |
平均偏差も求めてみる
| 日 | 偏差の絶対値 |
|---|---|
| 1 | 20 |
| 2 | 10 |
| 3 | 0 |
| 4 | 10 |
| 5 | 20 |
| 総和 | 60 |
| 計算 | 結果 |
|---|---|
| 60 ÷ 5 | 12 |
平均偏差:12人
標準偏差(14.1)より小さい
| 理由 | 内容 |
|---|---|
| 2乗することで大きなずれが強調される | 標準偏差のほうが大きくなる |
2つの店舗を比較する
店舗A
| 日 | 来客数 |
|---|---|
| 1〜5 | 98, 99, 100, 101, 102 |
| 指標 | 値 |
|---|---|
| 平均値 | 100 |
| 標準偏差 | 約1.4 |
店舗B
| 日 | 来客数 |
|---|---|
| 1〜5 | 50, 75, 100, 125, 150 |
| 指標 | 値 |
|---|---|
| 平均値 | 100 |
| 標準偏差 | 約35.4 |
同じ平均、違う性格
| 店舗 | 性格 | 経営上の意味 |
|---|---|---|
| A | 安定している | 人員計画が立てやすい。仕入も読める |
| B | 変動が大きい | ピークに合わせると無駄、平均に合わせると欠品 |
店舗Bへの対応
| 対応 | 内容 |
|---|---|
| 変動の原因を探る | 曜日、天候、イベント |
| 要因が分かれば予測できる | 標準偏差が下がる |
| 柔軟な体制を作る | 応援、パート活用 |
「ばらつきの原因を特定すると、ばらつきが減る」
| 状況 | 内容 |
|---|---|
| 原因不明のばらつき | 標準偏差35.4 |
| 曜日要因を除いた後 | 標準偏差12 |
| 天候要因も除いた後 | 標準偏差6 |
説明できる変動は、予測できる変動——これが需要予測の考え方です。
運営管理とのつながり:品質管理
| 指標 | 内容 |
|---|---|
| 工程能力指数(Cp) | 規格の幅 ÷ (6 × 標準偏差) |
標準偏差が小さいほど工程能力が高い
| Cp | 判定 |
|---|---|
| 1.33以上 | 十分 |
| 1.00〜1.33 | やや不足 |
| 1.00未満 | 不足 |
製造業の現場で使われる指標——統計の知識が直接役立つ場面です。
財務・会計とのつながり:リスク
| 指標 | 内容 |
|---|---|
| 期待収益率 | 平均値 |
| リスク | 標準偏差 |
| 投資 | 期待収益率 | 標準偏差 |
|---|---|---|
| A | 5% | 2% |
| B | 5% | 15% |
同じ期待収益率でも、Bのほうがリスクが高い
「リスク=標準偏差」という考え方——ポートフォリオ理論の基礎です。
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 偏差とは、各データの値から平均値を引いて得られた値である。
> b 分散とは、偏差を2乗した値の合計値をデータ数で割った値である。
> c 標準偏差とは、分散を2乗した値である。
解答 a:○ b:○ c:×
データの散らばりを表す指標(1/2)
データの散らばりを表す指標(2/2)
試験のポイント
② 標本を使う理由
母集団から選び出した標本を統計的手法により分析することで、母集団の特徴が明らかになります。
| 理由 | 内容 |
|---|---|
| すべてを調べられない | 費用、時間、物理的な制約 |
| 一部から全体を推測する | 統計的手法 |
③ 例:日本人の身長を調べる
| 対象 | 内容 |
|---|---|
| 母集団 | 日本国民すべて |
| 標本 | 抽出した日本人1,000人 |
④ 母平均・母分散と標本平均・標本分散
母集団の平均値と分散をそれぞれ、母平均、母分散といいます。
標本の平均値と分散をそれぞれ、標本平均、標本分散といいます。
| 対象 | 平均値 | 分散 |
|---|---|---|
| 母集団 | 母平均 | 母分散 |
| 標本 | 標本平均 | 標本分散 |
⑤ 4つの用語の整理
| 用語 | 何の何か |
|---|---|
| 母平均 | 母集団の平均値 |
| 母分散 | 母集団の分散 |
| 標本平均 | 標本の平均値 |
| 標本分散 | 標本の分散 |
「母」が付けば母集団、「標本」が付けば標本——単純ですが、混同しやすい用語です。
⑥ なぜ区別が重要か
| 状況 | 内容 |
|---|---|
| 知りたいのは母平均 | しかし直接は分からない |
| 分かるのは標本平均 | 標本から計算できる |
| 標本平均から母平均を推測する | 統計的推測 |
次節で学ぶ検定は、この推測を行う手法です。
⑦ 標本数(サンプル数)と標本サイズ(サンプルサイズ)
母集団から無作為に標本を取り出したとき、標本の群の数を「標本数(サンプル数)」、各群の標本のデータの個数を「標本サイズ(サンプルサイズ)」とよびます。
| 用語 | 内容 |
|---|---|
| 標本数(サンプル数) | 標本の群の数 |
| 標本サイズ(サンプルサイズ) | 各群の標本のデータの個数 |
⑧ 例で理解する
47都道府県の住民の身長の平均を比較するために、調査を行います。各都道府県から無作為に500人を選んで平均を算出した場合。
| 用語 | 値 |
|---|---|
| 標本数(サンプル数) | 47 |
| 標本サイズ(サンプルサイズ) | 500人 |
⑨ 判別の考え方
| 問い | 答え |
|---|---|
| いくつのグループに分かれているか | 標本数 |
| 1グループに何個のデータがあるか | 標本サイズ |
⑩ 日常での混同
| 表現 | 実際の意味 |
|---|---|
| 「サンプル数1,000人のアンケート」 | 本来は「標本サイズ1,000人」 |
日常的には混同されることが多い用語ですが、統計学上は区別されます。
⑪ 次節とのつながり
標本数によって、用いる検定が変わります。
| 標本数 | 検定 |
|---|---|
| 1つ | z検定、t検定 |
| 2つ | t検定、ウェルチ検定、F検定 |
| 3つ以上 | 分散分析 |
この対応関係が次節の中心的な論点です。
⑫ 標本の選び方
| 方法 | 内容 |
|---|---|
| 無作為抽出(単純無作為抽出) | すべての要素が等しい確率で選ばれる |
| 層化抽出 | 母集団を層に分けて、各層から抽出する |
| クラスター抽出 | 集団単位で抽出する |
「無作為に」が重要
| 抽出の仕方 | 結果 |
|---|---|
| 無作為 | 母集団を代表する |
| 偏りがある | 誤った推測になる |
⑬ 偏った標本の例
| 調査方法 | 偏り |
|---|---|
| 平日昼間の街頭調査 | 働いている人が含まれにくい |
| インターネット調査 | ネットを使わない層が含まれない |
| 店頭での調査 | 既に来店した人に限られる |
| 回答者の自発的な参加 | 関心の高い人に偏る |
最後の点がとくに注意
| 状況 | 内容 |
|---|---|
| アンケートに答えてくれる人 | もともと関心が高い |
| 不満を持つ人も答えやすい | 両極端に偏る |
| 無関心な層の意見が取れない | 実態と違う結果 |
「答えてくれた人の意見」であって「顧客全体の意見」ではない——調査結果を読む際の重要な注意点です。
具体例
標本数と標本サイズを区別する
例1:都道府県別の調査
| 設定 | 内容 |
|---|---|
| 47都道府県から各500人を選ぶ | — |
| 標本数 | 47 |
| 標本サイズ | 500人 |
例2:3つの店舗の売上比較
| 設定 | 内容 |
|---|---|
| 3店舗について、各30日分のデータを取る | — |
| 標本数 | 3 |
| 標本サイズ | 30 |
例3:単一のアンケート調査
| 設定 | 内容 |
|---|---|
| 顧客1,000人にアンケートを実施 | — |
| 標本数 | 1 |
| 標本サイズ | 1,000人 |
なぜ区別が必要か
| 検定の選択 | 基準 |
|---|---|
| 標本数が1つ | z検定、t検定 |
| 標本数が2つ | t検定、ウェルチ検定、F検定 |
| 標本数が3つ以上 | 分散分析 |
「標本サイズ」ではなく「標本数」で決まる——ここが重要です。
誤りの例
| 誤った判断 | 内容 |
|---|---|
| 「1,000人もいるから分散分析」 | 標本数は1つなので違う |
| 「3店舗×30日で90だから」 | 標本数は3つ |
中小企業の調査での実務
例:顧客満足度調査
| 項目 | 設定 |
|---|---|
| 母集団 | 全顧客 3,000人 |
| 標本 | 無作為に選んだ300人 |
| 標本数 | 1 |
| 標本サイズ | 300人 |
どれくらいの標本サイズが必要か
| 母集団 | 必要な標本サイズの目安(誤差5%、信頼度95%) |
|---|---|
| 100 | 約80 |
| 500 | 約218 |
| 1,000 | 約278 |
| 3,000 | 約341 |
| 10,000 | 約370 |
| 100,000 | 約383 |
母集団が大きくなっても、必要な標本サイズはあまり増えない
| 母集団 | 標本サイズ | 比率 |
|---|---|---|
| 1,000 | 278 | 27.8% |
| 100,000 | 383 | 0.4% |
「全国調査で1,000人聞けば十分」という話の根拠
| 理由 | 内容 |
|---|---|
| 精度は標本サイズで決まる | 母集団の大きさではない |
| 一定数を超えると精度の向上が鈍る | 費用対効果 |
中小企業にとっての意味
| 状況 | 必要な調査規模 |
|---|---|
| 顧客300人の企業 | 約170人 |
| 顧客1,000人の企業 | 約278人 |
「全員に聞く必要はない」——調査の負担を減らせます。
ただし、偏りがあると意味がない
| 抽出方法 | 評価 |
|---|---|
| 顧客名簿から無作為に300人 | 良い |
| 来店した順に300人 | 偏る(頻繁に来る人に偏る) |
| アンケートに応じた300人 | 偏る(関心の高い人に偏る) |
「来店した順」の偏り
| 顧客 | 選ばれる確率 |
|---|---|
| 月10回来店 | 高い |
| 年1回来店 | 低い |
結果として、ヘビーユーザーの意見が過大に反映される
対応
| 対応 | 内容 |
|---|---|
| 顧客名簿から無作為に抽出する | 来店頻度に関わらず選ばれる |
| 郵送やメールで依頼する | 来店を条件にしない |
| 回収率を上げる工夫をする | 謝礼、簡潔な設問 |
「回収率を上げる」ことの重要性
| 回収率 | 偏りの大きさ |
|---|---|
| 10% | 大きい(答えた人が特殊) |
| 50% | 中程度 |
| 80% | 小さい |
回収率が低いと、無作為抽出の意味が失われる——設計と実行の両方が必要です。
層化抽出の活用
状況:顧客層が偏っている
| 顧客層 | 人数 | 比率 |
|---|---|---|
| 法人 | 200 | 20% |
| 個人 | 800 | 80% |
単純無作為抽出だと
| 抽出300人の内訳 | 期待値 |
|---|---|
| 法人 | 約60人 |
| 個人 | 約240人 |
法人の意見を詳しく知りたい場合
| 層 | 抽出数 |
|---|---|
| 法人 | 100人(層内の50%) |
| 個人 | 200人(層内の25%) |
層ごとに抽出率を変える——これが層化抽出です。
集計時の注意
| 注意 | 内容 |
|---|---|
| 抽出率が違う | 単純に合計すると法人の意見が過大になる |
| 重み付けが必要 | 元の比率に戻して集計する |
確認してみましょう
> 次の記述の正誤を判定せよ。
> a 母集団とは、調査や研究でデータを収集するときに、対象となるすべてのデータである。
> b 母集団から無作為に標本を取り出したとき、標本の群の数を「標本数(サンプル数)」、各群の標本のデータの個数を「標本サイズ(サンプルサイズ)」とよぶ。
> c 47都道府県から無作為に500人ずつを選んで平均を算出した場合、標本数は500、標本サイズは47である。
解答 a:○ b:○ c:×
母集団と標本
試験のポイント

 科目別の正答率と連続学習日数がマイページに出るので、次にどの科目をやるかで迷いません。プレミアム限定
プレミアムプラン
¥9,800〜/ 買い切り・自動更新なし(税込)
決済はStripe(世界最高水準・PCI-DSS準拠)で安全に処理されます。カード情報は当サービスに保存されません。
| 総和 | — | 1,000 |
